- Batch API nhận tối đa 100.000 yêu cầu hoặc 256 MB mỗi lô, xử lý không đồng bộ, tính bằng 50% giá thường cho mọi token.
- Phần lớn lô xong trong dưới 1 giờ; lô chưa xong sau 24 giờ thì hết hạn. Kết quả giữ trong 29 ngày.
- Kết quả không theo thứ tự gửi, nên mỗi yêu cầu cần một custom_id để ghép lại.
- Yêu cầu bị lỗi, bị hủy hay hết hạn không tính tiền; lỗi do yêu cầu sai thì sửa rồi mới gửi lại.
Bài này dựa trên trang Batch processing và mục giới hạn của Message Batches API trong tài liệu của Anthropic (đọc ngày 11/11/2026, xem lại giá và giới hạn ngày 15/11/2026). OpenAI và Google cũng có cơ chế xử lý theo lô với mức giảm tương tự; chi tiết khác nhau, nên đọc tài liệu của hãng bạn dùng.
Khi nào dùng batch
Batch hợp với việc có nhiều yêu cầu giống nhau về dạng và không có người đang ngồi chờ: phân loại hoặc gắn nhãn dữ liệu tồn đọng, tóm tắt hay dịch hàng loạt, trích thông tin từ nhiều tài liệu, chạy bộ đánh giá trên hàng nghìn câu mẫu. Batch không hợp với chatbot hay bất cứ thứ gì người dùng chờ trả lời ngay, vì thời gian xử lý có thể tới hàng giờ.
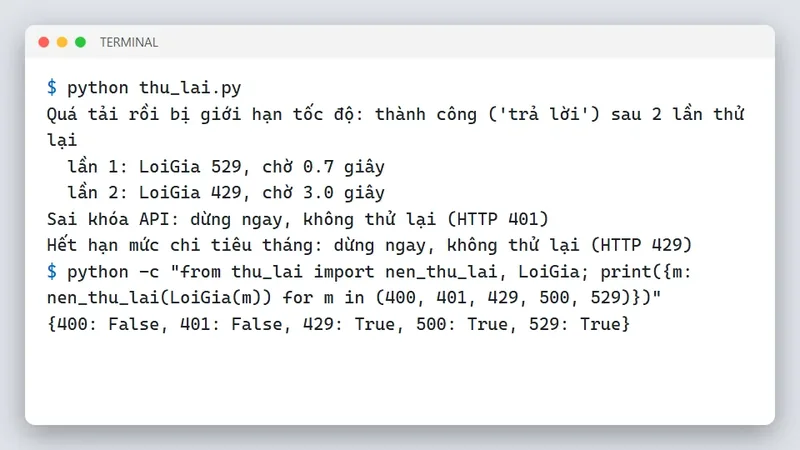
Lợi ích có hai. Chi phí giảm một nửa. Và bạn không phải tự lo gửi từng yêu cầu, giới hạn tốc độ, thử lại khi bị 429: hệ thống xử lý cả lô với giới hạn riêng của nó.
Giới hạn và giá
Theo tài liệu, một lô giới hạn ở 100.000 yêu cầu hoặc 256 MB, cái nào tới trước. Hệ thống xử lý nhanh nhất có thể, phần lớn lô xong trong vòng 1 giờ. Bạn lấy được kết quả khi mọi yêu cầu xong hoặc sau 24 giờ, cái nào tới trước; lô chưa xong trong 24 giờ thì hết hạn. Kết quả tải được trong 29 ngày kể từ khi tạo lô.
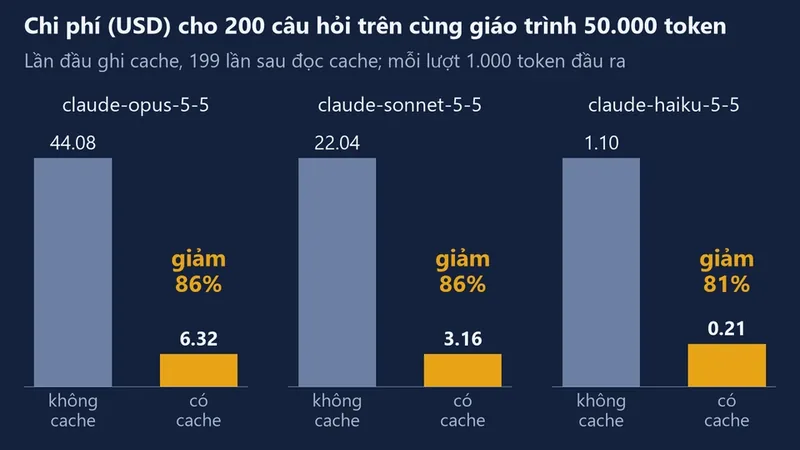
Giá theo lô bằng 50% giá thường. Với Claude Opus 5.5 là 2 USD mỗi triệu token vào và 10 USD mỗi triệu token ra; Sonnet 5.5 là 1 và 5 USD; Haiku 5.5 (prompt tới 100.000 token) là 0,05 và 0,25 USD. Tài liệu cũng lưu ý: vì xử lý song song khối lượng lớn, một lô có thể vượt nhẹ hạn mức chi tiêu bạn đặt cho workspace.
Lô có giới hạn tốc độ riêng: số yêu cầu mỗi phút tới các endpoint của batch, và số yêu cầu đang chờ xử lý trong hàng đợi. Theo trang giới hạn, ở hạng Start, hạng thấp nhất trong bảng giới hạn chuẩn, hàng đợi tối đa 200.000 yêu cầu; tổ chức mới hoặc còn ít lịch sử dùng có thể bắt đầu ở hạng Evaluation, với giới hạn thấp hơn bảng này.
Ví dụ: phân loại mười nghìn góp ý
Đoạn Python dưới đây có các hàm cho từng bước. tao_yeu_cau biến danh sách góp ý thành các yêu cầu, mỗi yêu cầu có custom_id dạng gy-000001 (tài liệu cho phép 1 đến 64 ký tự gồm chữ, số, gạch nối, gạch dưới) và tham số giống hệt một lời gọi Messages API. Với Haiku 5.5, code tắt chế độ suy nghĩ vì việc phân loại đơn giản, để câu trả lời chỉ vài token. chia_lo cắt danh sách dài thành nhiều lô không quá 100.000. cho_xong hỏi trạng thái định kỳ tới khi lô kết thúc. doc_ket_qua đọc từng kết quả và chia ba nhóm.
"""Phân loại hàng nghìn góp ý bằng Message Batches API: rẻ bằng nửa giá, trả kết quả trong tối đa 24 giờ.

Các bước: tạo yêu cầu có custom_id -> gửi lô -> chờ tới khi "ended" -> đọc kết quả theo custom_id
(thứ tự kết quả không theo thứ tự gửi) -> gom các mục cần gửi lại.
Giá USD / 1 triệu token (thường, theo lô) theo tài liệu Anthropic đọc ngày 11/11/2026; xem lại trước khi dùng.
Cài: python -m pip install anthropic ; đặt ANTHROPIC_API_KEY để gọi thật.
"""
import os
import re
import sys
import time

GIA = {  # (vào thường, ra thường, vào theo lô, ra theo lô)
    "claude-opus-5-5": (4.0, 20.0, 2.0, 10.0),
    "claude-sonnet-5-5": (2.0, 10.0, 1.0, 5.0),
    "claude-haiku-5-5": (0.10, 0.50, 0.05, 0.25),
}
HE_THONG = "Phân loại góp ý của học viên vào đúng một nhãn: khen, chê, góp ý, hỏi. Chỉ trả về nhãn."
MAU_ID = re.compile(r"^[a-zA-Z0-9_-]{1,64}$")
TOI_DA_MOT_LO = 100_000


def tao_yeu_cau(ds_gop_y, mo_hinh="claude-haiku-5-5"):
    yeu_cau = []
    for i, cau in enumerate(ds_gop_y, 1):
        cid = f"gy-{i:06d}"
        assert MAU_ID.match(cid)
        params = {"model": mo_hinh, "max_tokens": 20, "system": HE_THONG,
                  "messages": [{"role": "user", "content": cau}]}
        if mo_hinh == "claude-haiku-5-5":
            # Việc phân loại đơn giản: tắt suy nghĩ để câu trả lời chỉ vài token. Haiku 5.5 cho phép;
            # Opus 5.5 không cho tắt (trả lỗi 400), khi đó bỏ dòng này và tăng max_tokens.
            params["thinking"] = {"type": "disabled"}
        yeu_cau.append({"custom_id": cid, "params": params})
    return yeu_cau


def chia_lo(yeu_cau, toi_da=TOI_DA_MOT_LO):
    return [yeu_cau[i:i + toi_da] for i in range(0, len(yeu_cau), toi_da)]


def cho_xong(client, ma_lo, ngu=time.sleep, moi=60):
    while True:
        lo = client.messages.batches.retrieve(ma_lo)
        if lo.processing_status == "ended":
            return lo
        ngu(moi)


def doc_ket_qua(client, ma_lo):
    """Trả về (nhãn theo custom_id, danh sách custom_id cần gửi lại, danh sách custom_id lỗi do yêu cầu sai)."""
    nhan, gui_lai, sai = {}, [], []
    for kq in client.messages.batches.results(ma_lo):
        loai = kq.result.type
        if loai == "succeeded":
            nhan[kq.custom_id] = "".join(k.text for k in kq.result.message.content if k.type == "text").strip()
        elif loai == "errored" and kq.result.error.type == "invalid_request":
            sai.append(kq.custom_id)  # sửa yêu cầu trước khi gửi lại
        else:
            gui_lai.append(kq.custom_id)  # lỗi máy chủ, hết hạn, bị hủy: không tính tiền, gửi lại được
    return nhan, sorted(gui_lai), sorted(sai)


def chi_phi(mo_hinh, so_yc, token_vao, token_ra):
    vt, rt, vl, rl = GIA[mo_hinh]
    return so_yc * (token_vao * vt + token_ra * rt) / 1e6, so_yc * (token_vao * vl + token_ra * rl) / 1e6


def chay_thu():
    dong = ["10000 góp ý, mỗi yêu cầu khoảng 300 token vào, 5 token ra:"]
    for mo_hinh in GIA:
        thuong, lo = chi_phi(mo_hinh, 10_000, 300, 5)
        dong.append(f"  {mo_hinh}: gọi thường {thuong:.2f} USD, theo lô {lo:.2f} USD")
    yc = tao_yeu_cau([f"góp ý số {i}" for i in range(250_001)])
    dong.append(f"250001 yêu cầu chia thành {len(chia_lo(yc))} lô; custom_id đầu {yc[0]['custom_id']}, cuối {yc[-1]['custom_id']}")
    print("\n".join(dong))
    return dong


def main():
    if not os.environ.get("ANTHROPIC_API_KEY"):
        sys.exit("Chưa có ANTHROPIC_API_KEY. Đặt biến môi trường trước khi chạy.")
    import anthropic
    client = anthropic.Anthropic()
    ds = ["Thầy giảng dễ hiểu", "Video bị rè", "Khi nào có điểm giữa kỳ?"]
    try:
        lo = client.messages.batches.create(requests=tao_yeu_cau(ds))
        print("Đã gửi lô", lo.id, "- chờ xử lý (thường dưới 1 giờ, tối đa 24 giờ)")
        cho_xong(client, lo.id)
        nhan, gui_lai, sai = doc_ket_qua(client, lo.id)
    except anthropic.APIStatusError as e:
        sys.exit(f"API báo lỗi {e.status_code}: {e.message}")
    except anthropic.APIConnectionError:
        sys.exit("Không kết nối được tới API. Kiểm tra mạng rồi thử lại.")
    for cid in sorted(nhan):
        print(cid, nhan[cid])
    print("Cần gửi lại:", gui_lai, "| Yêu cầu sai:", sai)


if __name__ == "__main__":
    main() if "--goi-that" in sys.argv else chay_thu()
Phần chạy thử không cần mạng. Với 10.000 góp ý, mỗi yêu cầu khoảng 300 token vào và 5 token ra, chi phí ước tính: Opus 5.5 gọi thường 13,00 USD, gửi theo lô còn 6,50 USD; Haiku 5.5 gọi thường khoảng 0,33 USD, gửi theo lô còn khoảng 0,16 USD. Con số của Opus 5.5 giả định mô hình trả nhãn ngay, không suy nghĩ: Opus 5.5 không cho tắt chế độ suy nghĩ, nếu nó suy nghĩ thì token suy nghĩ tính tiền như token đầu ra và chi phí thật cao hơn, dù gửi theo lô vẫn bằng nửa giá. Danh sách 250.001 góp ý được chia thành 3 lô. Với việc phân loại kiểu này, Haiku theo lô thường là lựa chọn hợp lý, sau khi đã đo độ chính xác trên một bộ câu có nhãn như trong bài phân loại văn bản bằng mô hình ngôn ngữ.
Bốn loại kết quả
Khi lô kết thúc, mỗi yêu cầu có một trong bốn loại kết quả. Thành công: có câu trả lời. Lỗi: không tạo được câu trả lời, có thể do yêu cầu sai hoặc lỗi máy chủ; không tính tiền. Bị hủy: bạn hủy lô trước khi yêu cầu được xử lý; không tính tiền. Hết hạn: lô chạm mốc 24 giờ trước khi yêu cầu được xử lý; không tính tiền.
Hàm doc_ket_qua tách lỗi do yêu cầu sai ra riêng, vì gửi lại y nguyên sẽ lại lỗi; các trường hợp còn lại (lỗi máy chủ, bị hủy, hết hạn) gom vào danh sách gửi lại trong lô sau. Vì kết quả trả về theo thứ tự bất kỳ, chương trình luôn ghép bằng custom_id, không bao giờ bằng vị trí.
Mẹo dùng batch
- Thử trước một yêu cầu bằng Messages API thường. Tài liệu khuyên chạy thử một yêu cầu cùng dạng để bắt lỗi định dạng, tránh cả lô hàng nghìn mục cùng lỗi.
- Đặt custom_id có nghĩa. Mã gắn với khóa chính trong dữ liệu của bạn giúp ghi kết quả ngược lại dễ dàng.
- Chia nhỏ dữ liệu rất lớn. Nhiều lô vừa phải dễ theo dõi và gửi lại hơn một lô khổng lồ.
- Cache với lô. Tài liệu gợi ý dùng thời hạn cache 1 giờ khi xử lý lô có phần đầu chung, vì lô có thể chạy lâu hơn 5 phút; xem bài prompt caching.
- Lưu mã lô. Ghi lại mã lô ngay sau khi gửi để chương trình có thể dừng và quay lại đọc kết quả sau.
Lưu trạng thái để chạy lại an toàn
Một lần xử lý theo lô có thể kéo dài nhiều giờ, trong khi chương trình của bạn có thể bị tắt, máy có thể khởi động lại. Cách làm chắc chắn là tách việc gửi và việc đọc thành hai bước có lưu trạng thái. Sau khi gửi, ghi mã lô và danh sách custom_id đã gửi vào một tệp hoặc bảng. Một chương trình khác, chạy định kỳ, đọc tệp đó, hỏi trạng thái, và khi lô xong thì tải kết quả, ghi nhãn vào dữ liệu, đánh dấu những custom_id đã có kết quả. Mục nào chưa có kết quả sau khi lô kết thúc sẽ vào lô kế tiếp. Nhờ vậy, dù dừng ở bước nào, lần chạy sau vẫn biết chính xác việc gì đã xong, việc gì còn lại, và không trả tiền hai lần cho cùng một mục.
Batch hay gọi thường có thử lại
Nếu bạn đang viết vòng lặp gọi API cho hàng nghìn mục, kèm logic thử lại khi bị giới hạn tốc độ như trong bài xử lý lỗi khi gọi API AI, hãy hỏi: kết quả có cần trong vài phút không? Nếu không, batch gọn hơn và rẻ bằng nửa. Nếu cần nhanh, hoặc mỗi bước phụ thuộc kết quả bước trước (như agent nhiều vòng), gọi thường vẫn là lựa chọn đúng.
Một cách kết hợp hay dùng: chạy thử vài chục mục bằng gọi thường để tinh chỉnh prompt và đo chất lượng, rồi chạy toàn bộ bằng batch.
- Ghép kết quả theo vị trí thay vì theo custom_id.
- Gửi cả lô lớn mà chưa chạy thử một yêu cầu cùng dạng.
- Gửi lại y nguyên các yêu cầu lỗi do sai định dạng.
- Dùng batch cho việc người dùng đang chờ trả lời.
- Quên tải kết quả trước khi hết 29 ngày.
Câu hỏi thường gặp
Batch có hỗ trợ công cụ, hình ảnh, cache không?
Theo tài liệu, mỗi yêu cầu trong lô dùng được các tính năng của Messages API. Có vài ngoại lệ được nêu trong mục giới hạn của trang tài liệu.
Có hủy được lô đang chạy không?
Được. Các yêu cầu chưa xử lý sẽ có kết quả bị hủy và không tính tiền; yêu cầu đã xong vẫn có kết quả.
Mỗi lô có dùng mô hình khác nhau được không?
Mỗi yêu cầu có tham số riêng, gồm cả tên mô hình. Để dễ theo dõi chi phí, nên giữ một mô hình cho một lô.
Làm sao biết lô sắp xong?
Đọc số đếm yêu cầu theo từng trạng thái khi hỏi trạng thái lô. Hỏi thưa, ví dụ mỗi phút một lần, là đủ.
Học tiếp
- Thử lại đúng chỗ khi gọi thường: xử lý lỗi khi gọi API AI.
- Đo chất lượng phân loại trước khi chạy lô: phân loại văn bản bằng mô hình ngôn ngữ.
- Giảm thêm chi phí phần đầu chung: prompt caching.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.