- Chi phí tính theo token đầu vào (mô hình đọc) và đầu ra (mô hình viết). Ở các mô hình Claude 5.5, giá đầu ra gấp 5 lần đầu vào (bảng giá đọc ngày 11/11/2026).
- Agent tốn vì mỗi bước gửi lại cả ngữ cảnh. Bộ nhớ đệm lời nhắc làm phần đã gửi rẻ đi nhiều: trong phép ước tính của bài, một phiên 24 bước với Sonnet 5.5 giảm từ khoảng 2,63 xuống 0,47 đô la.
- Cách tiết kiệm hiệu quả nhất:
/cleargiữa các việc, chọn mô hình hợp việc, giữ tệp hướng dẫn gọn, tắt máy chủ MCP không dùng, viết yêu cầu cụ thể.
Bài này dựa trên bảng giá API của Anthropic, trang quản lý chi phí của Claude Code và bài kỹ thuật về hệ nhiều agent của Anthropic, đọc ngày 11/11/2026. Giá thay đổi thường xuyên; trước khi lập ngân sách, hãy xem lại trang giá. Ví dụ dùng Claude vì tài liệu ghi số liệu cụ thể, nhưng cách tính áp dụng cho mọi dịch vụ tính tiền theo token.
Token là gì và được tính tiền thế nào?
Mô hình ngôn ngữ không đọc từng chữ cái mà đọc từng mẩu văn bản gọi là token. Một token có thể là một từ ngắn, một phần của từ dài, hay một dấu câu. Dịch vụ API tính tiền theo số token, tách làm hai loại:
- Token đầu vào: mọi thứ gửi cho mô hình trong một lần gọi, gồm chỉ dẫn hệ thống, lịch sử trò chuyện, nội dung tệp, kết quả công cụ.
- Token đầu ra: những gì mô hình viết ra, kể cả phần suy nghĩ mở rộng. Tài liệu Claude Code ghi rõ token suy nghĩ được tính như token đầu ra.
Theo bảng giá của Anthropic đọc ngày 11/11/2026 (đơn vị: đô la Mỹ cho một triệu token):
| Mô hình | Đầu vào | Ghi bộ nhớ đệm 5 phút | Đọc từ bộ nhớ đệm | Đầu ra |
|---|---|---|---|---|
| Claude Opus 5.5 | 4 | 5 | 0,20 | 20 |
| Claude Sonnet 5.5 | 2 | 2,50 | 0,10 | 10 |
| Claude Haiku 5.5 (lời nhắc tới 100.000 token) | 0,10 | 0,125 | 0,01 | 0,50 |
Haiku 5.5 có giá cao hơn khi lời nhắc vượt 100.000 token. Bảng giá cũng cho biết Batch API, dùng cho việc không cần kết quả ngay, giảm 50% cả đầu vào lẫn đầu ra.
Vì sao agent tốn hơn chat?
Khi chat, một câu hỏi là một lần gọi. Khi dùng agent, một việc là nhiều lần gọi: đọc tệp, chạy lệnh, sửa, chạy test, mỗi bước một lần. Và mỗi lần gọi, toàn bộ ngữ cảnh đang có được gửi lại. Tài liệu Claude Code mô tả đúng điều này: Claude Code gửi cả cuộc trò chuyện ở mỗi yêu cầu, và mỗi lần dùng công cụ lại có thêm một yêu cầu mang kết quả của công cụ đó.
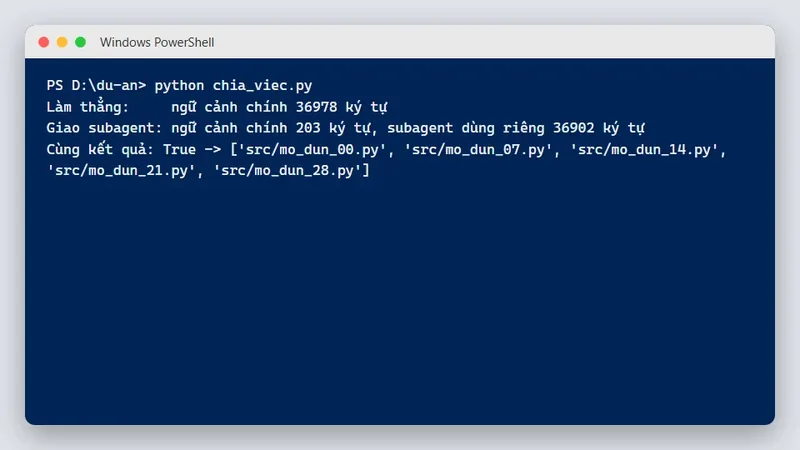
Anthropic có công bố số liệu từ hệ thống nghiên cứu nhiều agent của họ (bài kỹ thuật ngày 13/06/2025): agent thường dùng khoảng 4 lần lượng token so với trò chuyện thường, còn hệ nhiều agent khoảng 15 lần. Bài subagent là gì giải thích vì sao chia việc cho nhiều agent làm tổng token tăng.
Bộ nhớ đệm lời nhắc (prompt caching)
Vì phần lớn ngữ cảnh lần gọi sau giống lần gọi trước, nhà cung cấp cho lưu phần đó vào bộ nhớ đệm. Lần sau, phần trùng được đọc từ bộ nhớ đệm với giá rất thấp: ở bảng trên, giá đọc từ bộ nhớ đệm chỉ bằng 1/20 giá đầu vào thường với Opus 5.5 và Sonnet 5.5. Đổi lại, lần đầu ghi vào bộ nhớ đệm đắt hơn đầu vào thường một chút. Tài liệu Claude Code cho biết công cụ tự dùng bộ nhớ đệm để giảm chi phí cho nội dung lặp lại như chỉ dẫn hệ thống.
Bộ nhớ đệm có thời hạn. Tài liệu ghi rằng tin nhắn đầu tiên sau một khoảng nghỉ dài hơn thời hạn bộ nhớ đệm sẽ không trúng bộ nhớ đệm và phải xử lý lại toàn bộ ngữ cảnh. Một phiên mở cả ngày, quay lại hỏi một câu ngắn sau giờ nghỉ trưa, có thể tốn hơn bạn tưởng.
Ước tính chi phí một phiên agent
Để thấy các con số trên ghép lại thế nào, đoạn Python dưới đây ước tính chi phí một phiên với giả định đơn giản: lần gọi đầu gửi 12.000 token (chỉ dẫn hệ thống, tệp hướng dẫn, yêu cầu); mỗi bước sau ngữ cảnh dài thêm 3.500 token (kết quả công cụ cộng phần mô hình viết); mô hình viết 500 token mỗi bước. Giá lấy từ bảng ở trên. Đây là ước tính để thấy cơ chế, không phải hóa đơn: phiên thật có suy nghĩ mở rộng, kết quả công cụ dài ngắn khác nhau, và nén ngữ cảnh.
"""Ước tính chi phí token của một phiên agent nhiều bước, có và không có bộ nhớ đệm lời nhắc (prompt caching).

Giả định đơn giản để thấy cơ chế, không phải hóa đơn thật:
- Lần gọi đầu gửi 12.000 token (chỉ dẫn hệ thống, tệp hướng dẫn dự án, yêu cầu).
- Mỗi bước sau, ngữ cảnh dài thêm 3.500 token (3.000 token kết quả công cụ + 500 token mô hình viết ra).
- Mỗi lần gọi, toàn bộ ngữ cảnh được gửi lại. Có bộ nhớ đệm thì phần đã gửi ở lần trước được đọc với giá rẻ,
  phần mới được ghi vào bộ nhớ đệm với giá ghi.
Giá (USD cho 1 triệu token) lấy từ trang Pricing của Anthropic, đọc ngày 11/11/2026: vào, ghi đệm 5 phút, đọc đệm, ra.
"""

GIA = {
    "Opus 5.5": (4.00, 5.00, 0.20, 20.00),
    "Sonnet 5.5": (2.00, 2.50, 0.10, 10.00),
    "Haiku 5.5": (0.10, 0.125, 0.01, 0.50),  # giá cho lời nhắc tới 100.000 token
}
BAN_DAU, MOI_BUOC, RA_MOI_BUOC = 12_000, 3_500, 500


def ngu_canh(buoc):
    """Số token gửi đi ở lần gọi thứ `buoc` (đếm từ 1)."""
    return BAN_DAU + (buoc - 1) * MOI_BUOC


def chi_phi(so_buoc, gia, co_dem=True):
    vao, ghi, doc, ra = (g / 1_000_000 for g in gia)
    tien = 0.0
    for b in range(1, so_buoc + 1):
        c = ngu_canh(b)
        if co_dem:
            da_dem = ngu_canh(b - 1) if b > 1 else 0
            tien += da_dem * doc + (c - da_dem) * ghi
        else:
            tien += c * vao
        tien += RA_MOI_BUOC * ra
    return tien


SO_BUOC = 24  # ngữ cảnh cuối 92.500 token, dưới mốc 100.000 token nơi giá Haiku 5.5 đổi


def chay_thu():
    cuoi = f"{ngu_canh(SO_BUOC):,}".replace(",", ".")
    print(f"Một phiên {SO_BUOC} bước, ngữ cảnh cuối {cuoi} token")
    for ten, gia in GIA.items():
        print(f"{ten:<11} không đệm ${chi_phi(SO_BUOC, gia, False):.2f} | có đệm ${chi_phi(SO_BUOC, gia):.2f}")
    s = GIA["Sonnet 5.5"]
    nua = SO_BUOC // 2
    print(f"Sonnet 5.5, có đệm: 1 phiên {SO_BUOC} bước ${chi_phi(SO_BUOC, s):.2f}; "
          f"chia 2 phiên {nua} bước ${2 * chi_phi(nua, s):.2f}")


if __name__ == "__main__":
    chay_thu()
Kết quả:
Một phiên 24 bước, ngữ cảnh cuối 92.500 token
Opus 5.5    không đệm $5.26 | có đệm $0.93
Sonnet 5.5  không đệm $2.63 | có đệm $0.47
Haiku 5.5   không đệm $0.13 | có đệm $0.03
Sonnet 5.5, có đệm: 1 phiên 24 bước $0.47; chia 2 phiên 12 bước $0.44
Ba điều rút ra:
- Bộ nhớ đệm là yếu tố lớn nhất. Với cùng một phiên, có bộ nhớ đệm rẻ hơn khoảng 5 lần. Vì vậy đừng làm những việc khiến bộ nhớ đệm mất hiệu lực liên tục (tài liệu có danh sách các thao tác làm mất hiệu lực, như đổi định nghĩa công cụ giữa chừng).
- Chọn mô hình tạo chênh lệch hàng chục lần. Cùng phiên đó, Haiku 5.5 rẻ hơn Opus 5.5 khoảng 30 lần. Việc đơn giản không cần mô hình mạnh nhất.
- Ngữ cảnh ngắn rẻ hơn. Chia một việc dài thành hai phiên ngắn (bắt đầu lại bằng
/clear) tiết kiệm thêm một chút, vì nửa sau không phải mang theo ngữ cảnh của nửa đầu. Tiết kiệm lớn hơn nhiều khi các việc vốn không liên quan nhau mà bạn vẫn làm chung một phiên.
Gói thuê bao và API: hạn mức khác tiền
Có hai cách trả tiền khi dùng công cụ agent như Claude Code:
- Qua API: trả theo token như bảng giá. Tài liệu Claude Code cho biết, trên các doanh nghiệp đã triển khai, chi phí trung bình khoảng 13 đô la cho mỗi lập trình viên mỗi ngày có làm việc, 150 đến 250 đô la mỗi tháng, và 90% người dùng ở dưới 30 đô la mỗi ngày làm việc. Con số dao động mạnh theo mô hình chọn, kích thước kho mã và cách dùng.
- Qua gói thuê bao: trả phí cố định, dùng trong một hạn mức. Với gói Team và Enterprise, tài liệu cho biết mức dùng của mỗi thành viên lấy từ phần định mức của chỗ ngồi đó, đặt lại theo một cửa sổ 5 giờ trượt và một cửa sổ hằng tuần, dùng chung với Claude chat. Giá và hạn mức của từng gói xem tại trang giá của Anthropic.
Với gói thuê bao, câu hỏi không phải "tốn bao nhiêu tiền" mà "còn bao nhiêu hạn mức". Tài liệu lưu ý các thông báo hết hạn mức phiên hay hạn mức tuần là hạn mức chung cho mọi mô hình, nên đổi mô hình không giúp tiếp tục; thông báo cho biết lúc hạn mức đặt lại.
Theo dõi mức dùng
Trong Claude Code, lệnh /usage cho thấy mức dùng. Với người dùng API, phần phiên hiện tổng chi phí ước tính tính theo giá niêm yết, số token theo từng mô hình và thống kê bộ nhớ đệm (bao nhiêu phần đầu vào lấy từ bộ nhớ đệm). Với người dùng gói thuê bao, nó hiện các thanh hạn mức và bảng phân bổ: phần mức dùng do skill, subagent, plugin hay từng máy chủ MCP chiếm, kèm gợi ý thay đổi cho những hành vi chiếm từ 10% mức dùng gần đây trở lên.
Lệnh /context cho biết cái gì đang chiếm chỗ trong ngữ cảnh. Đây là nơi bạn phát hiện một tệp hướng dẫn quá dài hay một máy chủ MCP không dùng mà vẫn chiếm chỗ.
Mười cách tiết kiệm có trong tài liệu
Tài liệu Claude Code liệt kê các cách giảm token. Gom lại theo mức hiệu quả:
/clearkhi chuyển sang việc không liên quan. Ngữ cảnh cũ làm tốn token ở mọi tin nhắn sau. Đặt tên phiên bằng/renametrước khi xóa để mở lại sau.- Chọn mô hình hợp việc. Theo tài liệu, Sonnet làm tốt phần lớn việc lập trình và rẻ hơn Opus; để dành Opus cho quyết định kiến trúc phức tạp hay suy luận nhiều bước; cho subagent làm việc đơn giản dùng Haiku.
- Hạ mức nỗ lực cho việc đơn giản. Suy nghĩ mở rộng giúp việc phức tạp nhưng tính như token đầu ra; việc đơn giản thì hạ mức nỗ lực bằng
/effort. - Giữ tệp hướng dẫn dự án gọn, dưới 200 dòng; chuyển quy trình chuyên biệt sang skill, vì skill chỉ nạp khi dùng. Xem viết hướng dẫn dự án cho AI.
- Tắt máy chủ MCP không dùng bằng
/mcp, và ưu tiên công cụ dòng lệnh nhưghkhi có, vì chúng không thêm danh sách công cụ vào ngữ cảnh. - Viết yêu cầu cụ thể. Theo tài liệu, yêu cầu mơ hồ như "cải thiện kho mã này" khiến agent quét rộng; yêu cầu cụ thể như "thêm kiểm tra đầu vào cho hàm đăng nhập trong auth.ts" giúp nó đọc ít tệp.
- Lập kế hoạch cho việc phức tạp để tránh làm lại tốn kém khi hướng ban đầu sai, và dừng ngay bằng
Esckhi agent đi lệch. - Dùng hook để lọc đầu ra dài trước khi agent đọc, ví dụ chỉ giữ dòng có ERROR trong tệp nhật ký 10.000 dòng; tài liệu ví dụ việc này giảm ngữ cảnh từ hàng chục nghìn token xuống hàng trăm.
- Cho phép kiểm để agent tự phát hiện lỗi thay vì bạn phải yêu cầu sửa thêm nhiều vòng.
- Cẩn thận với nhiều agent cùng lúc. Subagent vẫn tính vào mức dùng của bạn; tài liệu cho biết đội agent (agent teams) dùng khoảng 7 lần token so với phiên thường khi các thành viên chạy ở chế độ lập kế hoạch.
Vì sao mức dùng tăng nhanh trong phiên dài?
Tài liệu nêu các nguyên nhân hay gặp khiến một phiên mở nhiều giờ dùng hết hạn mức nhanh hơn bạn nghĩ:
- Ngữ cảnh dài: một câu hỏi một dòng trong phiên mở cả ngày vẫn kéo theo cả cuộc trò chuyện.
- Trượt bộ nhớ đệm sau khoảng nghỉ dài hơn thời hạn bộ nhớ đệm.
- Việc chạy định kỳ trong phiên vẫn chạy khi bạn không gõ gì, mỗi lần gửi cả ngữ cảnh.
- Subagent và quy trình nhiều agent, mỗi cái gửi yêu cầu riêng.
- Nén ngữ cảnh cũng là một yêu cầu lớn vì phải đọc cả cuộc trò chuyện để tóm tắt; khi muốn bắt đầu lại hẳn,
/clearkhông tốn gì.
Quy trình làm việc gọn (giao việc vừa cỡ, có phép kiểm, bắt đầu lại khi đi sai) vừa cho kết quả tốt hơn vừa rẻ hơn. Xem quy trình làm dự án với agent.
- Để một phiên mở cả ngày và làm mọi việc trong đó: mỗi câu hỏi kéo theo toàn bộ lịch sử.
- Dùng mô hình mạnh nhất cho mọi việc, kể cả đổi tên biến.
- Tệp hướng dẫn dự án dài hàng trăm dòng, nạp vào mọi phiên dù việc không liên quan.
- Bật hàng loạt máy chủ MCP rồi để đó.
- Chạy nhiều agent song song cho việc không chia được, tưởng nhanh hơn mà chỉ tốn hơn.
- Lập ngân sách theo bảng giá cũ: giá đổi thường xuyên, luôn xem lại trang giá.
Câu hỏi thường gặp
Vì sao token đầu ra đắt hơn đầu vào?
Bảng giá của các nhà cung cấp đặt giá đầu ra cao hơn; với các mô hình Claude 5.5 trong bảng đọc ngày 11/11/2026, đầu ra gấp 5 lần đầu vào. Vì vậy yêu cầu mô hình trả lời gọn và hạ mức suy nghĩ cho việc đơn giản giúp tiết kiệm.
Dùng gói thuê bao có rẻ hơn API không?
Tùy mức dùng. Gói thuê bao trả cố định trong một hạn mức; API trả theo đúng token đã dùng. Người dùng nhiều và đều đặn thường thấy gói thuê bao tiện hơn; dùng ít hoặc chạy tự động thì API dễ kiểm soát hơn. Xem giá hiện hành trên trang của nhà cung cấp.
Bộ nhớ đệm có tự hoạt động không?
Với Claude Code, có: tài liệu cho biết công cụ tự dùng bộ nhớ đệm lời nhắc. Khi tự gọi API, bạn cần đánh dấu phần nội dung muốn lưu đệm theo hướng dẫn của API.
Làm sao biết phiên của tôi đã tốn bao nhiêu?
Trong Claude Code, chạy /usage. Người dùng API thấy chi phí ước tính của phiên; người dùng gói thuê bao thấy các thanh hạn mức và phần phân bổ theo skill, subagent, máy chủ MCP.
Subagent có giúp tiết kiệm không?
Không trực tiếp. Subagent giữ ngữ cảnh chính gọn nhưng yêu cầu của nó vẫn tính vào mức dùng. Tiết kiệm được khi cho subagent dùng mô hình rẻ hơn cho việc đơn giản.
Học tiếp
- Muốn hiểu vì sao nhiều agent làm tổng token tăng, đọc subagent là gì.
- Muốn làm việc gọn để vừa tốt vừa rẻ, đọc quy trình làm dự án với agent.
- Muốn tệp hướng dẫn không làm phình ngữ cảnh, đọc viết hướng dẫn dự án cho AI.
Nếu bạn muốn học AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.