- Mọi thuật toán Chia để trị (Divide and Conquer) đều xoay quanh 3 bước: Chia (Divide) bài toán thành các phần nhỏ độc lập → Trị (Conquer) giải đệ quy từng phần tới trường hợp cơ sở → Gộp (Combine) nghiệm các phần lại.
- Khác biệt cốt lõi với Quy hoạch động: trong Chia để trị, các bài toán con rời nhau (không trùng lặp) nên không cần mảng nhớ; còn trong Quy hoạch động, các bài toán con gối lên nhau nên phải lưu bảng để tránh tính lại.
- Khi chia đôi bài toán cỡ
Nthành 2 bài toán con cỡN / 2và tốnO(N)để gộp (T(N) = 2T(N/2) + O(N)), độ phức tạp tổng thể là O(N log N). - Nếu mỗi bước chia đôi chỉ cần giải 1 nhánh duy nhất (
T(N) = T(N/2) + O(1)), độ phức tạp giảm xuống chỉ còn O(log N).
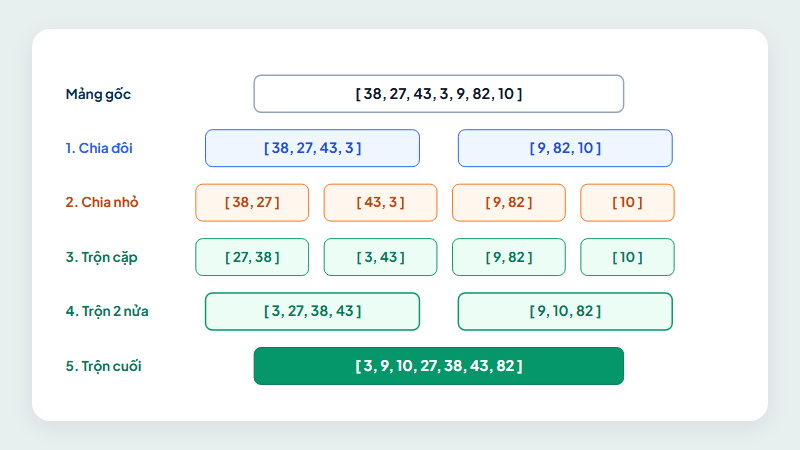
Mô hình 3 bước kinh điển của Chia để trị (Divide – Conquer – Combine)
Khi một bài toán trên mảng N = 100.000 phần tử không thể chạy kịp bằng vét cạn O(N²), một hướng tiếp cận đáng xét là Chia để trị (Divide and Conquer). Mọi hàm đệ quy chia để trị trên đoạn a[lo .. hi] đều tuân theo khung thiết kế 3 bước:
- Bước 1 — Chia (Divide): Tìm điểm chính giữa
mid = lo + (hi - lo) / 2để tách đoạna[lo .. hi]cỡNthành hai đoạn con độc lập là nửa tráia[lo .. mid]và nửa phảia[mid + 1 .. hi], mỗi nửa cỡN / 2. - Bước 2 — Trị (Conquer): Gọi đệ quy giải bài toán trên nửa trái và nửa phải. Quá trình chia dừng lại ở trường hợp cơ sở (base case) — thường là khi đoạn chỉ còn
1phần tử (lo == hi). - Bước 3 — Gộp (Combine): Kết hợp nghiệm của nửa trái, nghiệm của nửa phải (cộng thêm các phương án vắt ngang qua ranh giới
midnếu có) để thu được nghiệm của cả đoạna[lo .. hi].
Khi chia đôi liên tiếp, cây đệ quy chỉ cao log₂ N tầng; nếu việc gộp ở mỗi tầng tốn tổng cộng O(N) phép tính thì thời gian thực thi toàn cục là O(N log N).
Hệ thống hóa các thuật toán Chia để trị nền tảng
Tùy vào việc thuật toán đặt phần việc chính ở bước Chia hay bước Gộp, các thuật toán Chia để trị tiêu biểu có đặc trưng như sau:
| Thuật toán | Bước Chia (Divide) | Bước Trị (Conquer) | Bước Gộp (Combine) | Công thức và Độ phức tạp |
|---|---|---|---|---|
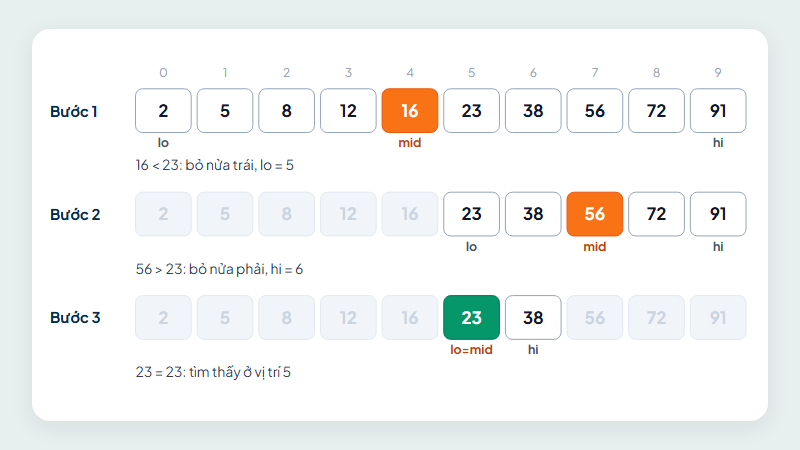
| Tìm kiếm nhị phân | So sánh x với a[mid] trong O(1) |
Chỉ gọi đệ quy 1 nửa chứa x |
Không cần gộp (O(1)) |
T(N) = T(N/2) + O(1) → O(log N) |
| Lũy thừa nhị phân | Chia đôi số mũ b thành b / 2 |
Tính đệ quy 1 lần half = a^(b/2) |
Nhân half × half trong O(1) |
T(b) = T(b/2) + O(1) → O(log b) |
| Sắp xếp trộn (Merge Sort) | Cắt đôi mảng tại mid trong O(1) |
Gọi đệ quy sắp xếp cả 2 nửa | Trộn hai nửa tăng dần trong O(N) |
T(N) = 2T(N/2) + O(N) → O(N log N) |
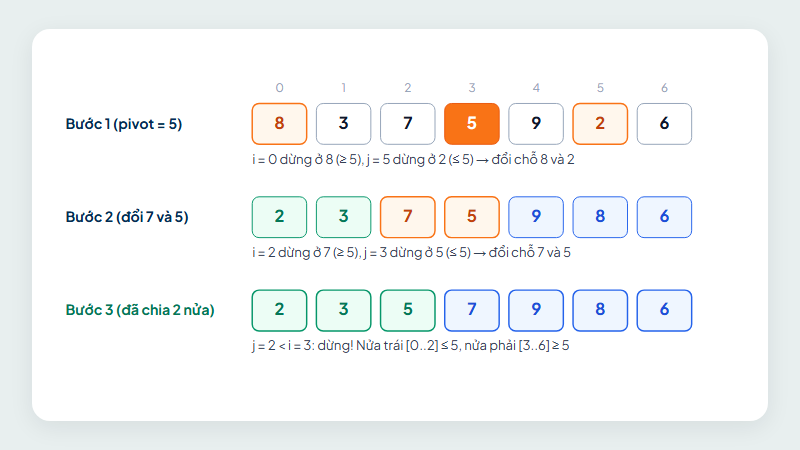
| Sắp xếp nhanh (Quick Sort) | Phân hoạch quanh chốt pivot trong O(N) |
Gọi đệ quy sắp xếp 2 nửa | Không cần gộp (O(1)) |
Phân hoạch cân bằng: 2T(N/2) + O(N) → O(N log N); xấu nhất O(N²) |
Bạn có thể thấy: Merge Sort chia rất nhẹ (O(1)) nhưng dồn việc nặng sang bước Gộp (O(N)); ngược lại Quick Sort dồn việc nặng vào bước Chia (O(N)) để bước Gộp bằng 0.
Ví dụ thực chiến 1: Tìm đoạn con liên tiếp có tổng lớn nhất
Quy ước đoạn cần chọn không rỗng và mảng có ít nhất một phần tử. Do đó mảng toàn âm phải trả phần tử lớn nhất, không phải 0.
Xét bài toán Maximum Subarray Sum: cho mảng a = [-2, 1, -3, 4, -1, 2, 1, -5, 4], hãy tìm đoạn con liên tiếp a[u .. v] có tổng lớn nhất.
Khi chia đôi đoạn a[lo .. hi] tại mid = (lo + hi) / 2, mọi đoạn con liên tiếp a[u .. v] phải thuộc đúng 1 trong 3 vị trí:
- Nằm hoàn toàn bên nửa trái (
lo ≤ u ≤ v ≤ mid): kết quả đệ quytot_trai. - Nằm hoàn toàn bên nửa phải (
mid + 1 ≤ u ≤ v ≤ hi): kết quả đệ quytot_phai. - Vắt ngang qua ranh giới giữa (
u ≤ midvàv ≥ mid + 1): đoạn này bắt buộc chứa cảa[mid]vàa[mid + 1], nên nó là ghép nối của hậu tố có tổng lớn nhất kết thúc tạimid(max_hau_to_trai, tìm bằng cách quét ngược từmidvềlo) với tiền tố có tổng lớn nhất bắt đầu từmid + 1(max_tien_to_phai, quét xuôi từmid + 1đếnhi). Tổng tốt nhất vắt ngang làtot_giua = max_hau_to_trai + max_tien_to_phai.
Ở bước Gộp, ta trả về max({tot_trai, tot_phai, tot_giua}). Trên mảng ví dụ (mid = 4), hậu tố trái tốt nhất là [4, -1] (tổng 3), tiền tố phải tốt nhất là [2, 1] (tổng 3), ghép lại được đoạn [4, -1, 2, 1] có tổng lớn nhất bằng 6:
#include <algorithm>
#include <climits>
#include <iostream>
#include <vector>
using namespace std;

// Tìm tổng đoạn con liên tiếp lớn nhất trong đoạn a[lo .. hi] bằng Chia để trị O(n log n)
long long max_subarray_dac(const vector<long long>& a, int lo, int hi) {
    // Trường hợp cơ sở: đoạn chỉ có 1 phần tử
    if (lo == hi) {
        return a[lo];
    }
    int mid = lo + (hi - lo) / 2;

    // 1 & 2. Chia (Divide) và Trị (Conquer) hai nửa độc lập
    long long tot_trai = max_subarray_dac(a, lo, mid);
    long long tot_phai = max_subarray_dac(a, mid + 1, hi);

    // 3. Gộp (Combine): Tìm đoạn con tốt nhất vắt ngang qua ranh giới mid và mid + 1
    long long max_hau_to_trai = LLONG_MIN, tong_trai = 0;
    for (int i = mid; i >= lo; --i) {
        tong_trai += a[i];
        max_hau_to_trai = max(max_hau_to_trai, tong_trai);
    }

    long long max_tien_to_phai = LLONG_MIN, tong_phai = 0;
    for (int j = mid + 1; j <= hi; ++j) {
        tong_phai += a[j];
        max_tien_to_phai = max(max_tien_to_phai, tong_phai);
    }

    long long tot_giua = max_hau_to_trai + max_tien_to_phai;
    return max({tot_trai, tot_phai, tot_giua});
}

int main() {
    // Test 1: Mảng kinh điển [-2, 1, -3, 4, -1, 2, 1, -5, 4] -> đoạn [4, -1, 2, 1] có tổng = 6
    vector<long long> a1 = {-2, 1, -3, 4, -1, 2, 1, -5, 4};
    cout << "MaxSub1: " << max_subarray_dac(a1, 0, (int)a1.size() - 1) << "\n";

    // Test 2: Mảng [5, 4, -1, 7, 8] -> toàn bộ mảng có tổng = 23
    vector<long long> a2 = {5, 4, -1, 7, 8};
    cout << "MaxSub2: " << max_subarray_dac(a2, 0, (int)a2.size() - 1) << "\n";

    // Test 3: Mảng toàn số âm [-8, -3, -6, -2, -5] -> chọn phần tử lớn nhất = -2
    vector<long long> a3 = {-8, -3, -6, -2, -5};
    cout << "MaxSub3: " << max_subarray_dac(a3, 0, (int)a3.size() - 1) << "\n";

    return 0;
}
def max_subarray_dac(a: list[int], lo: int, hi: int) -> int:
    """Tìm tổng đoạn con liên tiếp lớn nhất trong a[lo .. hi] bằng Chia để trị O(n log n)."""
    # Trường hợp cơ sở: đoạn chỉ có 1 phần tử
    if lo == hi:
        return a[lo]

    mid = (lo + hi) // 2

    # 1 & 2. Chia (Divide) và Trị (Conquer) hai nửa độc lập
    tot_trai = max_subarray_dac(a, lo, mid)
    tot_phai = max_subarray_dac(a, mid + 1, hi)

    # 3. Gộp (Combine): Tìm đoạn con tốt nhất vắt ngang qua mid và mid + 1
    max_hau_to_trai = a[mid]
    tong_trai = 0
    for i in range(mid, lo - 1, -1):
        tong_trai += a[i]
        if tong_trai > max_hau_to_trai:
            max_hau_to_trai = tong_trai

    max_tien_to_phai = a[mid + 1]
    tong_phai = 0
    for j in range(mid + 1, hi + 1):
        tong_phai += a[j]
        if tong_phai > max_tien_to_phai:
            max_tien_to_phai = tong_phai

    tot_giua = max_hau_to_trai + max_tien_to_phai
    return max(tot_trai, tot_phai, tot_giua)


if __name__ == "__main__":
    # Test 1: Mảng kinh điển [-2, 1, -3, 4, -1, 2, 1, -5, 4] -> tổng = 6
    a1 = [-2, 1, -3, 4, -1, 2, 1, -5, 4]
    print(f"MaxSub1: {max_subarray_dac(a1, 0, len(a1) - 1)}")

    # Test 2: Mảng [5, 4, -1, 7, 8] -> tổng = 23
    a2 = [5, 4, -1, 7, 8]
    print(f"MaxSub2: {max_subarray_dac(a2, 0, len(a2) - 1)}")

    # Test 3: Mảng toàn số âm [-8, -3, -6, -2, -5] -> tổng = -2
    a3 = [-8, -3, -6, -2, -5]
    print(f"MaxSub3: {max_subarray_dac(a3, 0, len(a3) - 1)}")
Chủ đề này nằm trong Lecture 04: Divide and Conquer (Chia để trị) của Khóa Orange. Xem đề cương
Ví dụ thực chiến 2: Đếm số cặp nghịch thế trong O(N log N)
Một cặp chỉ số (i, j) với i đứng trước j nhưng a[i] lớn hơn a[j] là một cặp nghịch thế (xem thêm bài Sắp xếp nổi bọt). Dựa trên khung trộn của Merge Sort, ta đếm toàn bộ cặp nghịch thế trong O(N log N):
- Chia & Trị: Đếm đệ quy số cặp nghịch thế trong nửa trái và nửa phải, đồng thời sắp xếp mỗi nửa tăng dần.
- Gộp: Khi trộn hai nửa đã tăng dần bằng hai con trỏ
i(nửa trái) vàj(nửa phải), nếu gặpa[i]lớn hơna[j]thì vì nửa trái đã tăng dần, mọi phần tử từa[i]đếna[mid]đều lớn hơna[j]! Ta cộng ngaydem += (mid - i + 1)trongO(1).
#include <iostream>
#include <vector>
using namespace std;

// Đếm số cặp (i < j) mà a[i] > a[j] trong đoạn a[lo .. hi] bằng Chia để trị O(n log n)
long long dem_cap_lon_hon_dac(vector<int>& a, int lo, int hi) {
    if (lo >= hi) return 0;
    int mid = lo + (hi - lo) / 2;

    // 1 & 2. Đếm đệ quy ở nửa trái và nửa phải
    long long dem = dem_cap_lon_hon_dac(a, lo, mid)
                  + dem_cap_lon_hon_dac(a, mid + 1, hi);

    // 3. Gộp hai nửa đã tăng dần và đếm các cặp vắt ngang (i ở nửa trái, j ở nửa phải)
    vector<int> tam;
    tam.reserve(hi - lo + 1);
    int i = lo, j = mid + 1;
    while (i <= mid && j <= hi) {
        if (a[i] <= a[j]) {
            tam.push_back(a[i++]);
        } else {
            // Vì nửa trái đã tăng dần, mọi phần tử từ a[i .. mid] đều lớn hơn a[j]
            dem += (mid - i + 1);
            tam.push_back(a[j++]);
        }
    }
    while (i <= mid) tam.push_back(a[i++]);
    while (j <= hi) tam.push_back(a[j++]);
    for (int k = lo; k <= hi; ++k) a[k] = tam[k - lo];
    return dem;
}

int main() {
    vector<vector<int>> cac_mang = {
        {5, 1, 4, 2, 8},  // 4 cặp: (5,1), (5,4), (5,2), (4,2)
        {8, 4, 2, 1},     // 6 cặp
        {1, 3, 5, 7}      // 0 cặp
    };

    for (auto a : cac_mang) {
        cout << "Inversions: " << dem_cap_lon_hon_dac(a, 0, (int)a.size() - 1) << "\n";
    }
    return 0;
}
def dem_cap_lon_hon_dac(a: list[int], lo: int, hi: int) -> int:
    """Đếm số cặp (i < j) mà a[i] > a[j] trong đoạn a[lo .. hi] bằng Chia để trị O(n log n)."""
    if lo >= hi:
        return 0
    mid = (lo + hi) // 2

    # 1 & 2. Đếm đệ quy ở nửa trái và nửa phải
    dem = dem_cap_lon_hon_dac(a, lo, mid) + dem_cap_lon_hon_dac(a, mid + 1, hi)

    # 3. Gộp hai nửa đã tăng dần và đếm các cặp vắt ngang (i ở nửa trái, j ở nửa phải)
    tam: list[int] = []
    i, j = lo, mid + 1
    while i <= mid and j <= hi:
        if a[i] <= a[j]:
            tam.append(a[i])
            i += 1
        else:
            # Mọi phần tử từ a[i .. mid] đều lớn hơn a[j]
            dem += mid - i + 1
            tam.append(a[j])
            j += 1
    tam.extend(a[i : mid + 1])
    tam.extend(a[j : hi + 1])
    a[lo : hi + 1] = tam
    return dem


if __name__ == "__main__":
    cac_mang = [
        [5, 1, 4, 2, 8],  # 4 cặp: (5,1), (5,4), (5,2), (4,2)
        [8, 4, 2, 1],     # 6 cặp
        [1, 3, 5, 7],     # 0 cặp
    ]

    for a in cac_mang:
        b = a[:]
        print(f"Inversions: {dem_cap_lon_hon_dac(b, 0, len(b) - 1)}")
Phân biệt Chia để trị và Quy hoạch động (Dynamic Programming)
Cả Chia để trị và Quy hoạch động đều tách bài toán lớn thành bài toán con, nhưng khác nhau ở tính độc lập của các bài toán con:
| Tiêu chí đối chiếu | Chia để trị (Divide and Conquer) | Quy hoạch động (Dynamic Programming) |
|---|---|---|
| Quan hệ giữa các bài toán con | Độc lập, rời nhau (nửa trái a[0..3] và nửa phải a[4..7] không giao nhau) |
Gối lên nhau, lặp lại nhiều lần (F(5) gọi F(4), F(3), rồi F(4) gọi lại F(3)) |
| Có cần bảng nhớ (DP Table) không? | Không cần, mỗi bài toán con chỉ giải đúng 1 lần | Lưu kết quả trạng thái, có thể chỉ giữ vài giá trị nếu quan hệ phụ thuộc cho phép |
| Ví dụ tiêu biểu | Merge Sort, Quick Sort, Tìm kiếm nhị phân | Dãy Fibonacci, Bài toán cái túi (Knapsack), Dãy con tăng dài nhất |
Lỗi hay gặp khi thiết kế hàm Chia để trị
- Quên xét phương án vắt ngang qua
midở bước Gộp. Nếu chỉ lấymax(tot_trai, tot_phai)mà bỏ quêntot_giua, thuật toán sẽ bỏ sót mọi nghiệm đi qua tâm mảng. - Chia khoảng đệ quy gây lặp vô hạn. Với
mid = lo + (hi - lo) / 2(làm tròn xuống), hai nhánh đệ quy bắt buộc là(lo, mid)và(mid + 1, hi). Nếu viết(lo, mid - 1)và(mid, hi), khilo = 0, hi = 1thìmid = 0và nhánh phải gọi lại(0, 1)vô hạn. - Truyền mảng theo giá trị (pass-by-value) vào hàm đệ quy. Sao chép cả mảng ở mỗi lời gọi tốn
O(N), làm hỏng độ phức tạp. Hãy truyền tham chiếuconst vector<long long>& akèm chỉ sốlo, hi.
Luyện ngay trên Big-O Coding
Thực hành ngay tư duy chia đôi bài toán và kết hợp nghiệm trên hệ thống Big-O Coding:
Câu hỏi thường gặp
Bài toán tìm đoạn con có tổng lớn nhất có cách nào nhanh hơn Chia để trị O(N log N) không?
Có, thuật toán Kadane giải trong O(N). Tuy nhiên, tư duy Chia để trị (hợp nhất thông tin từ nửa trái và nửa phải) lại là nền tảng trực tiếp để xây dựng Cây phân đoạn (Segment Tree) khi bài toán yêu cầu vừa cập nhật phần tử vừa truy vấn đoạn con có tổng lớn nhất trong O(log N).
Vì sao Tìm kiếm nhị phân chỉ đi vào 1 nhánh mà vẫn xếp vào Chia để trị?
Tìm kiếm nhị phân và Lũy thừa nhị phân là trường hợp đặc biệt (còn gọi là Giảm để trị — Decrease and Conquer) khi ở bước Chia ta loại bỏ được hẳn một nửa và chỉ cần trị nửa còn lại với bước Gộp O(1).
Khi nào KHÔNG nên dùng Chia để trị?
Khi các bài toán con bị trùng lặp nhiều lần (cần dùng Quy hoạch động) hoặc khi bước Gộp tốn tới O(N²) không nhanh hơn cách giải trực tiếp.
Khóa Orange: làm chủ thuật toán nâng cao như Graph, DP tối ưu, Segment Tree, HLD để giải bài Hard. 16 buổi online, C++/Java/Python, học thử buổi 1 miễn phí.