- Token là đơn vị mô hình đọc và viết; một từ có thể là một hoặc nhiều token. Tiền và giới hạn đều tính theo token, không theo chữ.
- Anthropic có endpoint đếm token miễn phí, nhận đúng cấu trúc của một yêu cầu thật (chỉ dẫn, tin nhắn, công cụ, hình, PDF) và trả về số token đầu vào.
- Kết quả là ước lượng, có thể lệch chút ít so với lúc gọi thật. Theo tài liệu, mô hình từ Claude Opus 4.7 trở đi đếm cùng văn bản ra nhiều hơn khoảng 30%.
- Dùng số đếm để ước chi phí, chọn bao nhiêu tài liệu đưa vào, và chừa chỗ cho câu trả lời.
Bài này dựa trên trang Token counting, Context windows, Pricing và Rate limits trong tài liệu của Anthropic (đọc ngày 11/11/2026, xem lại giá và giới hạn ngày 15/11/2026). Nếu chưa gọi API lần nào, đọc trước bài gọi API AI bằng Python.
Vì sao không đếm bằng số chữ
Mô hình không đọc từng chữ cái hay từng từ, mà đọc các mảnh văn bản gọi là token, lấy từ một bộ từ vựng cố định. Một từ phổ biến có thể là một token, một từ hiếm bị tách thành vài token, dấu câu và khoảng trắng cũng chiếm token. Tỷ lệ giữa số từ và số token thay đổi theo ngôn ngữ, theo loại văn bản (văn xuôi, code, bảng số) và theo bộ tách token của từng mô hình.
Vì vậy các quy tắc nhẩm kiểu "một token bằng mấy ký tự" chỉ đúng gần đúng cho một loại văn bản. Khi cần con số đáng tin để tính tiền hoặc kiểm tra prompt có vừa không, hãy đếm bằng chính công cụ của nhà cung cấp, cho đúng mô hình bạn định dùng.
Endpoint đếm token
Theo tài liệu, endpoint đếm token nhận cùng cấu trúc đầu vào như khi tạo tin nhắn: tên mô hình, chỉ dẫn hệ thống, danh sách tin nhắn, công cụ, hình ảnh, tệp PDF. Kết quả trả về là tổng số token đầu vào. Trong thư viện Python, hàm tương ứng là count_tokens trên đối tượng messages.
Ba điều tài liệu nhấn mạnh. Thứ nhất, đếm token miễn phí, nhưng có giới hạn số yêu cầu mỗi phút theo hạng tài khoản: 5.000 yêu cầu mỗi phút ở hạng Start, hạng thấp nhất trong bảng giới hạn chuẩn; theo trang Rate limits, tổ chức mới hoặc còn ít lịch sử dùng có thể bắt đầu ở hạng Evaluation, với giới hạn thấp hơn bảng chuẩn. Giới hạn này tách riêng khỏi giới hạn của việc gọi mô hình. Thứ hai, con số là ước lượng: số token thực tế khi gọi có thể lệch một ít, và có thể gồm token hệ thống tự thêm mà bạn không bị tính tiền. Thứ ba, một số đầu vào không đếm được, như công cụ chạy phía máy chủ (tìm kiếm web, chạy code) hay hình và PDF gửi bằng đường dẫn; muốn đếm hình và PDF thì gửi dạng base64.
Một ghi chú quan trọng khi đổi mô hình: các mô hình từ Claude Opus 4.7 trở đi dùng bộ tách token mới, cùng một văn bản cho ra nhiều hơn khoảng 30% token so với mô hình cũ, tùy nội dung. Tài liệu khuyên đếm lại prompt theo mô hình định dùng, không dùng lại số đã đo trên mô hình cũ để ước chi phí.
Ví dụ: chọn tài liệu vừa ngân sách
Trong một chatbot hỏi đáp tài liệu, bạn tìm được tám đoạn liên quan, đã xếp theo độ liên quan giảm dần. Đưa hết thì tốn, có khi vượt giới hạn; đưa ít quá thì thiếu thông tin. Đoạn Python dưới đây thêm dần từng đoạn, mỗi lần đếm lại tổng token, dừng khi đoạn tiếp theo làm vượt ngân sách.
"""Đếm token trước khi gọi API: ước chi phí, chọn bao nhiêu đoạn tài liệu cho vừa ngân sách token.

- dem_bang_api: gọi endpoint đếm token (miễn phí, có giới hạn số yêu cầu mỗi phút), trả về input_tokens.
- chon_doan_vua: thêm dần các đoạn tài liệu (đã xếp theo độ liên quan) tới khi chạm ngân sách.
- chi_phi_vao: tiền phần đầu vào theo bảng giá.
Khi chạy thử không có mạng, dùng dem_gia: đếm theo số ký tự, CHỈ để chạy thử luồng code, không phải số token thật.
Cài: python -m pip install anthropic ; đặt ANTHROPIC_API_KEY để đếm thật.
"""
import os
import sys

GIA_VAO = {"claude-opus-5-5": 4.0, "claude-sonnet-5-5": 2.0, "claude-haiku-5-5": 0.10}  # USD / 1 triệu token, 11/11/2026


def dem_bang_api(client, mo_hinh, he_thong, noi_dung):
    kq = client.messages.count_tokens(model=mo_hinh, system=he_thong,
                                      messages=[{"role": "user", "content": noi_dung}])
    return kq.input_tokens


def dem_gia(mo_hinh, he_thong, noi_dung):
    return (len(he_thong) + len(noi_dung)) // 4 + 8


def chon_doan_vua(cac_doan, cau_hoi, ngan_sach, dem, mo_hinh="claude-haiku-5-5", he_thong="Trả lời dựa trên tài liệu."):
    """Thêm từng đoạn (đã xếp theo độ liên quan) miễn tổng token vẫn trong ngân sách. Trả về (đoạn được chọn, số token)."""
    chon, so_token = [], dem(mo_hinh, he_thong, cau_hoi)
    for doan in cac_doan:
        thu = "\n\n".join(chon + [doan]) + "\n\nCâu hỏi: " + cau_hoi
        n = dem(mo_hinh, he_thong, thu)
        if n > ngan_sach:
            break
        chon.append(doan)
        so_token = n
    return chon, so_token


def chi_phi_vao(mo_hinh, so_token, so_lan=1):
    return GIA_VAO[mo_hinh] * so_token * so_lan / 1e6


def chay_thu():
    doan = [f"Đoạn {i}: " + "nội dung giáo trình " * 40 for i in range(1, 9)]
    chon, n = chon_doan_vua(doan, "Đệ quy là gì?", ngan_sach=1500, dem=dem_gia)
    dong = [f"Ngân sách 1500 token (đếm giả): chọn {len(chon)}/{len(doan)} đoạn, tổng {n} token"]
    for m in GIA_VAO:
        dong.append(f"  1000 lần gọi với {n} token đầu vào, {m}: {chi_phi_vao(m, n, 1000):.4f} USD")
    print("\n".join(dong))
    return dong


def main():
    if not os.environ.get("ANTHROPIC_API_KEY"):
        sys.exit("Chưa có ANTHROPIC_API_KEY. Đặt biến môi trường trước khi chạy.")
    import anthropic
    client = anthropic.Anthropic()
    try:
        n = dem_bang_api(client, "claude-haiku-5-5", "Bạn là trợ giảng.", "Giải thích đệ quy bằng một ví dụ.")
    except anthropic.APIStatusError as e:
        sys.exit(f"API báo lỗi {e.status_code}: {e.message}")
    except anthropic.APIConnectionError:
        sys.exit("Không kết nối được tới API. Kiểm tra mạng rồi thử lại.")
    print("Số token đầu vào:", n)


if __name__ == "__main__":
    main() if "--dem-that" in sys.argv else chay_thu()
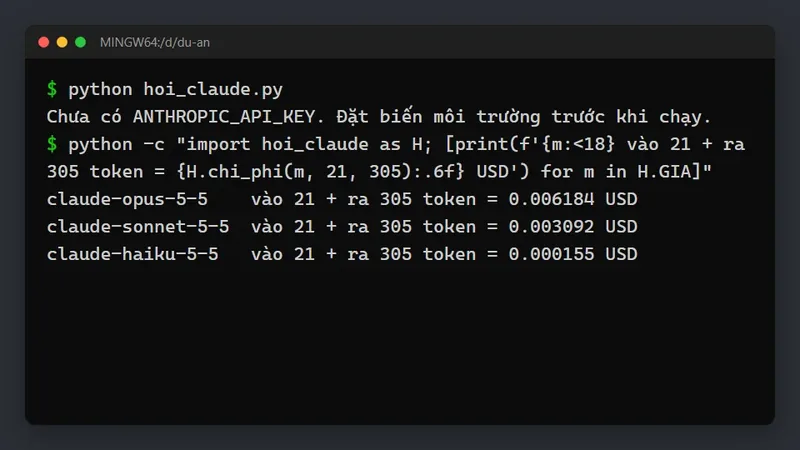
Hàm chon_doan_vua nhận hàm đếm làm tham số. Khi chạy thật, truyền vào hàm gọi endpoint đếm token. Khi chạy thử không có mạng, code dùng một hàm đếm giả theo số ký tự, chỉ để thấy luồng xử lý chạy đúng, không phải số token thật. Với ngân sách 1.500 token theo cách đếm giả, chương trình chọn được 7 trong 8 đoạn, tổng 1.437 token. Phần ước chi phí cho thấy 1.000 lần gọi với chừng ấy token đầu vào tốn khoảng 5,75 USD với Opus 5.5 và khoảng 0,14 USD với Haiku 5.5, theo giá đầu vào ngày 11/11/2026 (xem lại ngày 15/11/2026, không đổi), chưa tính đầu ra. Với Opus 5.5, Sonnet 5.5 và Haiku 5.5, giá đầu ra gấp 5 lần giá đầu vào; ba mô hình này bật sẵn chế độ suy nghĩ, và token suy nghĩ cũng tính là token đầu ra. Muốn biết tổng chi phí, hãy đo đầu ra bằng vài lần gọi thật như trong phần thói quen bên dưới.
Đếm lại sau mỗi lần thêm đoạn tốn nhiều lần gọi endpoint. Với tài liệu lớn, có thể đếm từng đoạn một lần rồi cộng dồn, chấp nhận lệch chút ít, và chỉ đếm lại toàn bộ yêu cầu cuối cùng trước khi gửi.
Chừa chỗ cho câu trả lời
Cửa sổ ngữ cảnh là tổng số token mô hình xử lý trong một lần, gồm cả đầu vào lẫn đầu ra. Trang Context windows trong tài liệu giải thích cách tính này và kích thước cửa sổ của từng mô hình. Nếu prompt đã chiếm gần hết cửa sổ, câu trả lời sẽ bị cắt. Khi đặt ngân sách, trừ trước số token tối đa bạn cho phép câu trả lời, cộng thêm khoảng dư cho phần suy nghĩ nếu mô hình có bật chế độ này.
Dùng số đếm vào việc gì
Ước chi phí trước khi chạy lớn. Lấy vài chục yêu cầu mẫu, đếm, nhân với số lần gọi dự kiến và giá. Đây là bước nên làm trước mọi đợt xử lý hàng nghìn tài liệu.
Chọn mô hình theo độ dài. Với yêu cầu ngắn, đơn giản, chọn mô hình nhỏ rẻ; với tài liệu rất dài, kiểm tra giá có đổi theo độ dài prompt không (ví dụ Haiku 5.5 có giá khác cho prompt trên 100.000 token theo trang giá).
Giữ prompt gọn. So số token của hai phiên bản chỉ dẫn hệ thống để thấy phần nào tốn mà không đem lại gì.
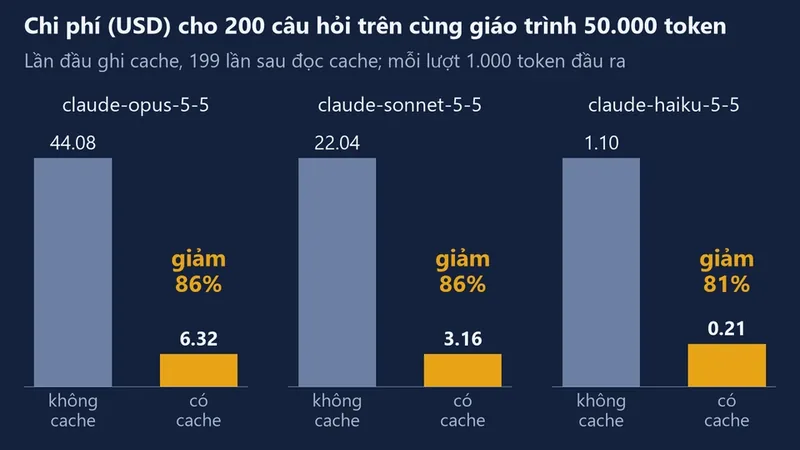
Kết hợp cache. Nếu phần đầu dài lặp lại ở nhiều yêu cầu, xem bài prompt caching. Tài liệu ghi rõ việc đếm token không dùng logic cache, nên số đếm là số token trước khi tính giảm giá do cache.
Thói quen trước mỗi đợt chạy lớn
Một quy trình ngắn giúp tránh bất ngờ về hóa đơn. Lấy ngẫu nhiên khoảng hai mươi mục từ dữ liệu thật, không lấy mục ngắn nhất hay dài nhất. Đếm token đầu vào của từng mục với đúng mô hình, đúng chỉ dẫn và công cụ sẽ dùng. Gọi thật năm mục để biết đầu ra trung bình dài bao nhiêu. Nhân trung bình với tổng số mục, nhân với giá, cộng thêm một khoản dự phòng cho các mục dài bất thường. Nếu con số vượt ngân sách, cân nhắc mô hình nhỏ hơn, rút gọn chỉ dẫn, dùng cache cho phần chung, hoặc gửi theo lô để được giảm giá. Ghi lại ước tính này, rồi so với số thật sau khi chạy; chênh lệch lớn là dấu hiệu dữ liệu mẫu chưa đại diện.
Đọc số token sau khi gọi
Đếm trước là ước lượng; số chính xác nằm trong phần usage của phản hồi sau mỗi lần gọi, gồm token vào, token ra và các token liên quan tới cache. Ghi các con số này vào nhật ký cùng tên mô hình và ngày. Sau một tuần, bạn có số liệu thật về chi phí trung bình mỗi yêu cầu, chính xác hơn mọi ước tính, và phát hiện sớm khi một thay đổi prompt làm chi phí tăng vọt.
- Ước token bằng số chữ hay số từ rồi tính tiền cho cả đợt lớn.
- Dùng lại số token đo trên mô hình cũ khi chuyển sang mô hình mới.
- Lấp đầy cửa sổ ngữ cảnh bằng đầu vào, không chừa chỗ cho câu trả lời.
- Gọi endpoint đếm cho từng câu nhỏ trong vòng lặp lớn mà quên giới hạn số yêu cầu mỗi phút.
- Bỏ qua số token trong phản hồi thật, chỉ tin số ước lượng.
Câu hỏi thường gặp
Đếm token có tốn tiền không?
Theo tài liệu, đếm token miễn phí, chỉ bị giới hạn số yêu cầu mỗi phút.
Đếm được token đầu ra trước không?
Không. Đầu ra phụ thuộc mô hình sinh ra gì. Bạn chỉ giới hạn được mức tối đa bằng tham số max_tokens, và đọc số thật trong phản hồi.
Văn bản tiếng Việt tốn token hơn tiếng Anh không?
Tùy bộ tách token và nội dung. Cách chắc chắn là đếm chính văn bản của bạn bằng endpoint cho mô hình bạn dùng.
Có đếm offline được không?
Bài không dựa vào công cụ đếm offline nào cho Claude. Với số liệu để tính tiền, dùng endpoint chính thức.
Học tiếp
- Gọi API và đọc số token trong phản hồi: gọi API AI bằng Python.
- Giảm chi phí phần đầu lặp lại: prompt caching.
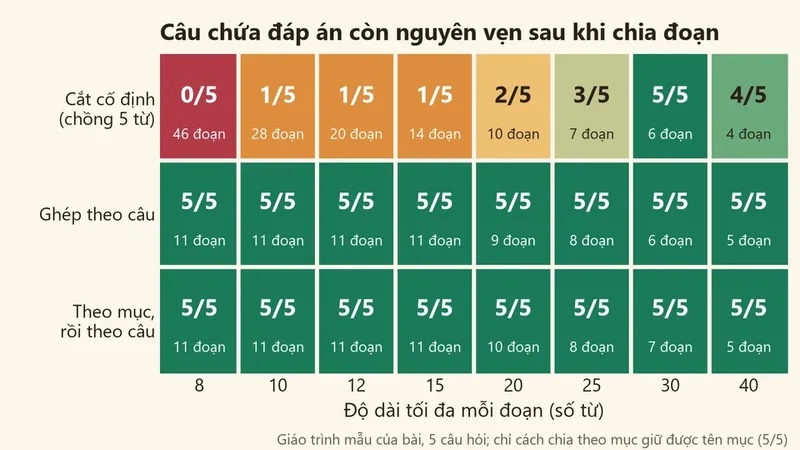
- Chia tài liệu thành đoạn trước khi chọn: chia đoạn văn bản cho RAG.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.