- GAN gồm bộ sinh G (biến nhiễu
zthành mẫu) và bộ phân biệt D (cho xác suất mẫu là thật), huấn luyện như một trò chơi minimax. - Với G cố định, D tối ưu là \(p_{\text{data}} / (p_{\text{data}} + p_g)\); khi đó giá trị trò chơi bằng \(-\log 4\) cộng hai lần độ lệch Jensen-Shannon, nhỏ nhất khi phân phối giả trùng phân phối thật.
- GAN khó huấn luyện: gradient bão hòa khi D quá giỏi, và sập mode khi G dồn nhiều nhiễu khác nhau về cùng một mẫu.
- WGAN thay độ lệch Jensen-Shannon bằng khoảng cách Wasserstein, cho gradient dùng được cả khi hai phân phối không giao nhau; StyleGAN đưa nhiễu qua một mạng ánh xạ rồi điều khiển từng tầng của ảnh.
Bài dựa trên bản PDF của ba bài báo: GAN (Goodfellow và cộng sự, arXiv 1406.2661v1), WGAN (Arjovsky và cộng sự, arXiv 1701.07875v3) và StyleGAN (Karras và cộng sự, arXiv 1812.04948v3), đọc ngày 12/11/2026. Bài 10 bài báo AI kinh điển có một đoạn tóm tắt GAN; ở đây ta đi vào hàm mục tiêu và các lỗi khi huấn luyện.
GAN là gì
GAN (generative adversarial network, mạng đối nghịch tạo sinh) là một cách huấn luyện mô hình sinh dữ liệu. Thay vì viết ra công thức xác suất của dữ liệu rồi tối đa hóa nó, GAN đặt hai mạng vào thế đối đầu. Bộ sinh G nhận một vector nhiễu z lấy ngẫu nhiên và biến nó thành một mẫu, ví dụ một ảnh. Bộ phân biệt D nhận một mẫu và trả về xác suất mẫu đó đến từ dữ liệu thật. D được thưởng khi đoán đúng; G được thưởng khi làm D đoán sai.
Bài báo gốc ví G như một nhóm làm tiền giả, D như cảnh sát: hai bên cùng giỏi lên, cho tới khi tiền giả không còn phân biệt được với tiền thật. Điểm hấp dẫn là chỉ cần lan truyền ngược: không cần chuỗi Markov, không cần suy luận gần đúng trong lúc học. Cái giá phải trả là không có công thức tường minh cho phân phối \(p_g\) của mẫu giả, và hai mạng phải được giữ cân bằng trong suốt quá trình huấn luyện.
z qua bộ sinh G thành mẫu giả; bộ phân biệt D chấm cả mẫu giả lẫn ảnh thật (các số 0,2 và 0,9 chỉ để minh họa). G được cập nhật để D đoán sai. Với G cố định, D tốt nhất bằng p_data chia cho p_data cộng p_g; ở điểm cân bằng của lý thuyết, D bằng 1/2 ở mọi điểm.Hàm mục tiêu: một trò chơi minimax
Bài báo viết trò chơi giữa hai mạng là \(\min_G \max_D V(D, G)\), với hàm giá trị (phương trình 1):
\[\begin{aligned} V(D, G) &= \mathbb{E}_{x \sim p_{\text{data}}}[\log D(x)] \\ &\quad + \mathbb{E}_{z \sim p_z}[\log(1 - D(G(z)))] \end{aligned}\]
D muốn \(V\) lớn: cho điểm gần 1 với mẫu thật và gần 0 với mẫu giả. G chỉ có mặt trong số hạng thứ hai và muốn \(V\) nhỏ, tức là muốn \(D(G(z))\) gần 1. Thuật toán 1 của bài báo xen kẽ hai việc: cập nhật D k bước trên một lô mẫu thật và một lô mẫu giả, rồi cập nhật G một bước. Nhóm tác giả dùng k = 1, lựa chọn rẻ nhất, và cập nhật bằng gradient có quán tính (momentum).
Bộ phân biệt tối ưu và khoảng cách Jensen-Shannon
Nếu G đứng yên, D tốt nhất có công thức đóng (mệnh đề 1):
\[D^*(x) = \frac{p_{\text{data}}(x)}{p_{\text{data}}(x) + p_g(x)}\]
Lý do: tại mỗi điểm x, D chỉ cần chọn một số y làm lớn nhất biểu thức \(a \log y + b \log(1 - y)\), với a là mật độ thật và b là mật độ giả; đáp án là \(y = a/(a + b)\). Thay \(D^*\) vào, giá trị của trò chơi thành (định lý 1):
\[C(G) = -\log 4 + 2 \cdot \mathrm{JSD}(p_{\text{data}} \,\|\, p_g)\]
Độ lệch Jensen-Shannon (JSD) luôn không âm và chỉ bằng 0 khi hai phân phối trùng nhau. Vậy cực tiểu toàn cục của trò chơi là \(-\log 4\), đạt được khi và chỉ khi \(p_g = p_{\text{data}}\); lúc đó \(D^* = 1/2\) ở mọi nơi. Cần nhớ kết quả này giả định hai mạng có sức chứa vô hạn và được tối ưu trực tiếp trên không gian các phân phối; mạng thật chỉ chỉnh được một số hữu hạn tham số.
Code numpy: kiểm định lý trên phân phối rời rạc
Đoạn code dưới đây dùng hai phân phối trên 5 điểm, tính \(D^*\), so giá trị trò chơi với công thức của định lý 1, đo gradient bão hòa, và chạy ví dụ hai khối điểm của WGAN (phần sau giải thích).
"""GAN bằng numpy trên phân phối rời rạc: bộ phân biệt tối ưu, giá trị của trò chơi, gradient bão hòa,
và ví dụ "hai đường thẳng song song" của WGAN.

Chạy: python gan_toi_uu.py  (cần numpy)
"""
import numpy as np


def d_toi_uu(p_data, p_g):
    """Mệnh đề 1 của Goodfellow và cộng sự (2014): D*(x) = p_data(x) / (p_data(x) + p_g(x))."""
    return p_data / (p_data + p_g)


def gia_tri(D, p_data, p_g):
    """V(D, G) = E_{x~p_data}[log D(x)] + E_{x~p_g}[log(1 - D(x))], tính trên các điểm rời rạc."""
    return float(np.sum(p_data * np.log(D)) + np.sum(p_g * np.log(1 - D)))


def kl(a, b):
    """Độ lệch Kullback-Leibler KL(a || b), bỏ qua các điểm a = 0 (đóng góp 0)."""
    co = a > 0
    return float(np.sum(a[co] * np.log(a[co] / b[co])))


def jsd(p, q):
    """Độ lệch Jensen-Shannon (logarit tự nhiên): trung bình KL của p và q tới phân phối giữa m."""
    m = (p + q) / 2
    return (kl(p, m) + kl(q, m)) / 2


def gradient_theo_logit(a):
    """D = sigmoid(a). Đạo hàm theo a của log(1 - D) (mục tiêu gốc của G) và của log D (mẹo không bão hòa)."""
    d = 1 / (1 + np.exp(-a))
    return -d, 1 - d


def wasserstein_1d(luoi, p, q):
    """W1 trên một chiều = tích phân |F_p - F_q|, với F là hàm phân phối tích lũy trên lưới đều."""
    h = luoi[1] - luoi[0]
    return float(np.sum(np.abs(np.cumsum(p) - np.cumsum(q))) * h)


def chay_thu():
    p_data = np.array([0.10, 0.40, 0.30, 0.15, 0.05])
    p_g = np.array([0.30, 0.20, 0.20, 0.20, 0.10])
    D = d_toi_uu(p_data, p_g)
    print("D* tại 5 điểm:", " ".join(f"{x:.3f}" for x in D))
    print(f"V(D*, G) = {gia_tri(D, p_data, p_g):.4f};  -log 4 + 2·JSD = {-np.log(4) + 2 * jsd(p_data, p_g):.4f}")
    print(f"D = 1/2 ở mọi điểm cho V = {gia_tri(np.full(5, 0.5), p_data, p_g):.4f} (nhỏ hơn V(D*, G))")
    print(f"Khi p_g = p_data: D* = {d_toi_uu(p_data, p_data)[0]:.1f} ở mọi điểm, V = {gia_tri(d_toi_uu(p_data, p_data), p_data, p_data):.4f}")
    goc, ko_bao_hoa = gradient_theo_logit(np.log(0.01 / 0.99))   # D(G(z)) = 0,01: D gạt mẫu giả rất tự tin
    print(f"Khi D(G(z)) = 0,01: gradient của log(1 - D) là {goc:.2f}, của log D là {ko_bao_hoa:.2f}")
    luoi = np.round(np.arange(-1.0, 2.0 + 1e-9, 0.05), 2)
    p0 = (luoi == 0.0).astype(float)                              # khối lượng dồn ở 0
    for theta in (1.0, 0.5, 0.1, 0.0):
        pt = (luoi == theta).astype(float)                        # khối lượng dồn ở theta
        print(f"theta = {theta:.1f}: JSD = {jsd(p0, pt):.4f}, W1 = {wasserstein_1d(luoi, p0, pt):.2f}")


if __name__ == "__main__":
    chay_thu()
Hai số ở dòng thứ hai trùng nhau: \(V(D^*, G) = -1{,}2778\), đúng bằng \(-\log 4 + 2 \cdot \mathrm{JSD}\). Thay \(D^*\) bằng bộ phân biệt "đoán bừa" \(D = 1/2\) thì \(V\) tụt xuống \(-1{,}3863\), nhỏ hơn: \(D^*\) đúng là tốt nhất. Khi \(p_g = p_{\text{data}}\), \(D^*\) bằng 0,5 ở cả năm điểm và \(V = -\log 4\). Muốn tự kiểm khi sửa code, thử thật nhiều D ngẫu nhiên: không D nào được cho \(V\) lớn hơn \(D^*\).
Vì sao GAN khó huấn luyện
Gradient bão hòa. Đầu quá trình học, mẫu giả còn rất tệ nên D gạt chúng đi với độ tự tin cao, và số hạng \(\log(1 - D(G(z)))\) gần như phẳng. Dòng thứ năm của code cho thấy điều này: khi \(D(G(z)) = 0{,}01\), gradient của \(\log(1 - D)\) theo đầu ra trước hàm sigmoid của D chỉ là \(-0{,}01\), còn gradient của \(\log D\) là \(0{,}99\). Vì vậy chính bài báo gợi ý cho G tối đa hóa \(\log D(G(z))\) thay vì tối thiểu hóa \(\log(1 - D(G(z)))\): cùng điểm cân bằng nhưng gradient mạnh hơn nhiều lúc đầu.
Sập mode (mode collapse). Nếu G được huấn luyện quá nhiều mà D không được cập nhật kịp, G có thể dồn nhiều giá trị z khác nhau về cùng một mẫu x. Bài báo gọi đó là "kịch bản Helvetica". Mẫu sinh ra khi đó trông được nhưng thiếu đa dạng: chỉ một vài khuôn mặt, một vài chữ số. Bài WGAN giải thích thêm: với một D cố định, G tốt nhất là đặt toàn bộ khối lượng vào vài điểm mà D chấm cao nhất.
Khó đo tiến độ. GAN không cho công thức xác suất, nên bài báo năm 2014 phải ước lượng log-likelihood bằng cửa sổ Parzen trên mẫu sinh ra. Đường mất mát của G và D cũng không cho biết ảnh đẹp lên hay chưa.
WGAN: đổi thước đo khoảng cách
Bài WGAN bắt đầu bằng một ví dụ đơn giản (ví dụ 1, "hai đường thẳng song song"): phân phối thật nằm trên đoạn thẳng đứng tại hoành độ 0, phân phối giả nằm trên đoạn song song tại hoành độ \(\theta\). Khi \(\theta \ne 0\), hai phân phối không giao nhau nên JSD luôn bằng \(\log 2\), dù \(\theta\) là 1 hay 0,001: không có gradient nào chỉ đường. Khoảng cách Wasserstein (khoảng cách "dời đất", Earth Mover) thì bằng đúng \(|\theta|\), giảm đều khi hai đường xích lại. Bốn dòng cuối của code là bản một chiều của ví dụ này: JSD đứng yên ở 0,6931 còn W1 giảm từ 1,00 xuống 0,10.
Khoảng cách Wasserstein khó tính trực tiếp, nhưng theo đối ngẫu Kantorovich-Rubinstein, nó bằng giá trị lớn nhất của hiệu kỳ vọng trên các hàm 1-Lipschitz:
\[\begin{aligned} W(P_r, P_\theta) = \sup_{\|f\|_L \le 1} \; & \mathbb{E}_{x \sim P_r}[f(x)] \\ & - \mathbb{E}_{x \sim P_\theta}[f(x)] \end{aligned}\]
WGAN thay D bằng một "nhà phê bình" (critic) \(f\) không có sigmoid, và giữ nó gần Lipschitz bằng cách kẹp mọi trọng số trong đoạn \([-0{,}01;\ 0{,}01]\) sau mỗi bước. Thuật toán 1 dùng tốc độ học 0,00005, mỗi lô gồm 64 mẫu, 5 bước cho nhà phê bình mỗi bước của G, với RMSProp vì Adam làm quá trình học mất ổn định. Kết quả theo bài báo: đường mất mát đi theo chất lượng ảnh, và trong các thí nghiệm của họ không thấy dấu hiệu sập mode. Chính nhóm tác giả gọi việc kẹp trọng số là cách "rõ ràng là tệ" để giữ điều kiện Lipschitz và mời người khác cải tiến.
StyleGAN: điều khiển ảnh theo từng tầng
StyleGAN (Karras và cộng sự, NVIDIA) giữ nguyên hàm mất mát và đổi bộ sinh. Nhiễu z 512 chiều đi qua một mạng ánh xạ 8 lớp để thành vector w, cũng 512 chiều. Bộ sinh bắt đầu từ một khối hằng số 4×4×512 đã học, và tại mỗi lớp tích chập, w điều khiển phép chuẩn hóa thích nghi AdaIN:
\[\mathrm{AdaIN}(x_i, y) = y_{s,i} \frac{x_i - \mu(x_i)}{\sigma(x_i)} + y_{b,i}\]
Mỗi lớp còn được cộng nhiễu riêng để sinh chi tiết ngẫu nhiên như sợi tóc, lỗ chân lông. Trộn hai vector w ở hai tầng khác nhau cho thấy các tầng thô (4×4 đến 8×8) quyết định tư thế, khuôn mặt, kính, còn các tầng mịn quyết định màu sắc. Bộ dữ liệu FFHQ do nhóm tác giả công bố gồm 70.000 ảnh mặt người 1024×1024. Trên FFHQ, chỉ số FID (thấp là tốt) giảm từ 8,04 của Progressive GAN xuống 4,40 với đầy đủ các thay đổi; bộ sinh có 26,2 triệu tham số so với 23,1 triệu của bộ sinh truyền thống.
GAN hay mô hình khuếch tán
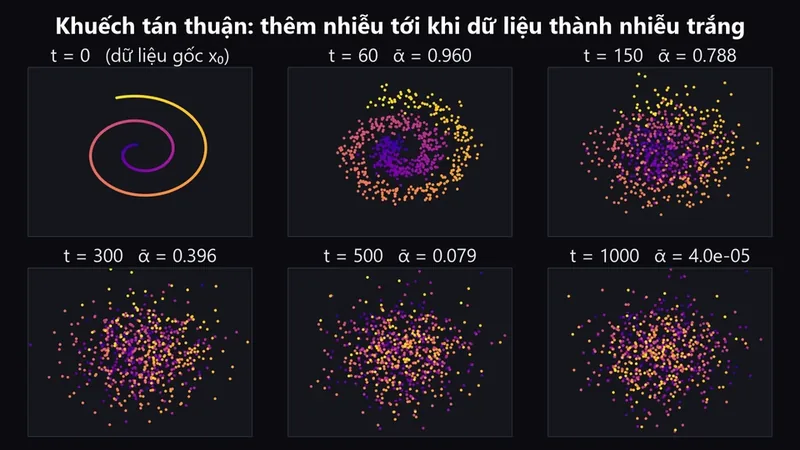
GAN sinh một ảnh bằng một lần chạy qua bộ sinh, nên rất nhanh. Mô hình khuếch tán phải chạy cùng một mạng nhiều lần liên tiếp, bài báo Latent Diffusion nhắc tới 25 đến 1.000 bước, đổi lại học ổn định hơn. GAN vẫn sống bên trong các hệ thống đó: bộ tự mã hóa nén ảnh của Latent Diffusion được huấn luyện với một bộ phân biệt theo từng mảng ảnh, đúng tinh thần đối nghịch của GAN. Bài autoencoder và VAE nói tiếp về bộ tự mã hóa đó.
- Để D quá mạnh ngay từ đầu: gradient cho G gần như bằng 0; dùng mục tiêu không bão hòa \(\log D(G(z))\) cho G.
- Huấn luyện G nhiều bước liền mà không cập nhật D: dễ sập mode.
- Nhìn đường mất mát của GAN gốc để đoán ảnh đẹp lên chưa: nó không đi theo chất lượng; hãy xem mẫu và đo chỉ số như FID.
- Dùng Adam với hệ số quán tính cho nhà phê bình WGAN kẹp trọng số: bài báo ghi điều này làm học mất ổn định.
- Hiểu "cân bằng ở \(p_g = p_{\text{data}}\)" là đảm bảo khi chạy thật: định lý giả định mạng có sức chứa vô hạn.
Câu hỏi thường gặp
GAN dùng để làm gì?
Sinh ảnh, tăng độ phân giải, chuyển phong cách ảnh, và tạo dữ liệu tổng hợp. StyleGAN là ví dụ nổi tiếng về sinh mặt người độ phân giải cao.
Sập mode là gì?
Là khi bộ sinh chỉ tạo ra vài kiểu mẫu lặp đi lặp lại, vì nhiều giá trị nhiễu khác nhau bị dồn về cùng một đầu ra. Mẫu vẫn trông thật nhưng không đa dạng như dữ liệu.
WGAN khác GAN gốc ở đâu?
WGAN đo khoảng cách Wasserstein thay cho độ lệch Jensen-Shannon, bỏ sigmoid ở đầu ra của bộ phân biệt, và kẹp trọng số để giữ điều kiện Lipschitz. Đường mất mát của nó đi theo chất lượng mẫu.
Có còn ai dùng GAN không?
Nhiều công cụ tạo ảnh phổ biến, như Stable Diffusion, dựa trên mô hình khuếch tán. Nhưng ý tưởng đối nghịch vẫn được dùng, ví dụ trong bộ tự mã hóa của Latent Diffusion.
Học tiếp
- Đối thủ đang dẫn đầu của GAN trong sinh ảnh: mô hình khuếch tán tạo ảnh thế nào.
- Nén ảnh vào không gian ẩn và sinh mẫu bằng VAE: autoencoder là gì.
- Ảnh do AI tạo có dấu vết gì: nhận biết ảnh do AI tạo.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Goodfellow và cộng sự (2014): Generative Adversarial Networks, arXiv 1406.2661v1 (đọc bản PDF ngày 12/11/2026)
- Arjovsky, Chintala, Bottou (2017): Wasserstein GAN, arXiv 1701.07875v3 (đọc bản PDF ngày 12/11/2026)
- Karras, Laine, Aila (2019): A Style-Based Generator Architecture for GANs, arXiv 1812.04948v3 (đọc bản PDF ngày 12/11/2026)
- Rombach và cộng sự (2022): High-Resolution Image Synthesis with Latent Diffusion Models, arXiv 2112.10752v2