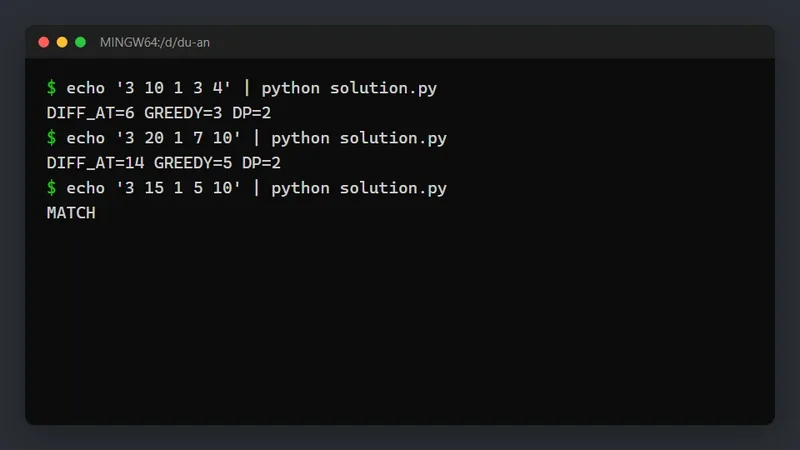
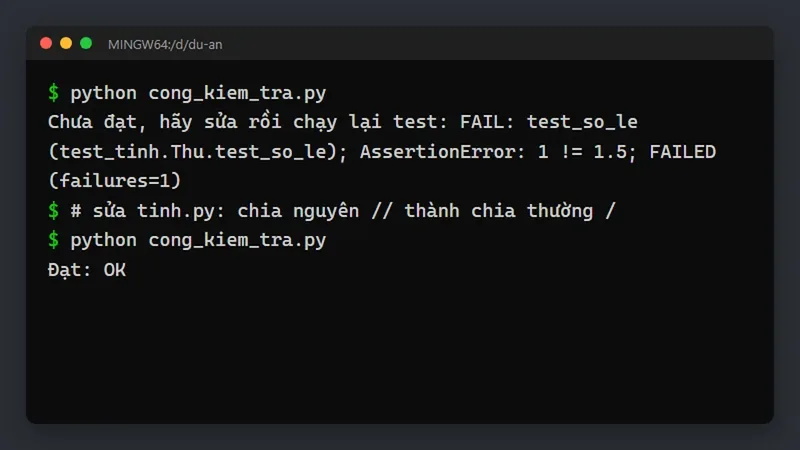
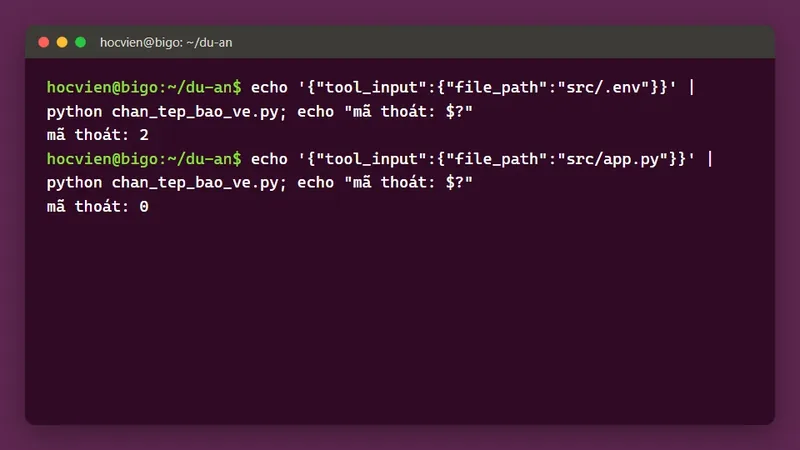
- Ba lớp kiểm chứng: chạy (test, build, chạy thử chương trình) và xem đầu ra; đọc từng thay đổi; đối chiếu độc lập (với lời giải vét cạn, hoặc một người xem lại chưa thấy cuộc trò chuyện).
- Đúng ví dụ mẫu chưa phải là đúng. Trong ví dụ của bài, hàm do AI viết qua ví dụ mẫu nhưng sai ở
[0, 0, 2]; đối chiếu với vét cạn trên dữ liệu ngẫu nhiên tìm ra ngay. - Mức kiểm tùy rủi ro: đổi tên biến thì xem nhanh; thanh toán, phân quyền, xóa dữ liệu thì cần cả ba lớp và một người duyệt.
Bài này dựa trên tài liệu best practices của Claude Code và khảo sát Stack Overflow 2026, đọc ngày 11/11/2026. Ví dụ code là Python, nhưng cách kiểm chứng áp dụng cho mọi ngôn ngữ và mọi công cụ AI.
Vì sao phải kiểm chứng việc AI làm?
Tài liệu Claude Code giải thích vì sao: agent kết thúc lượt làm việc khi kết quả có vẻ ổn. Thiếu một bước kiểm chạy được, cảm giác "có vẻ ổn" là căn cứ duy nhất của nó, và lỗi cứ nằm im cho tới khi bạn tình cờ phát hiện.
Người làm nghề cũng thấy điều này. Trong khảo sát Stack Overflow 2026 (mục AI), 48% người trả lời cho biết họ tin AI khi dễ kiểm chứng câu trả lời của nó, và chỉ 16% tin AI cho phần lớn công việc không phải quyết định quan trọng. Nói cách khác, niềm tin vào AI đi kèm với khả năng kiểm chứng.
Có một cái bẫy đặc biệt khi kiểm code do AI viết: nếu cùng một AI viết cả code lẫn test, test có thể có cùng điểm mù với code. AI hiểu sai đề ở đâu thì test cũng thường kiểm theo đúng cách hiểu sai đó. Vì vậy cần ít nhất một lớp kiểm không đến từ cùng một nguồn.
Lớp 1: chạy và xem đầu ra
Lớp đầu tiên cần một phép thử cho kết quả rõ ràng, qua hoặc trượt: bộ test, việc biên dịch thành công hay thất bại, công cụ soát định dạng, hoặc script so kết quả với đáp án mẫu. Theo tài liệu Claude Code, đây là thứ đáng chuẩn bị nhất, vì nhờ nó agent tự sửa rồi tự thử lại mà không cần bạn trông chừng. Cách thiết lập có trong bài quy trình làm dự án với agent.
Nhưng có test chưa đủ, phải nhìn kết quả. Hãy đòi agent đưa ra bằng chứng như tài liệu khuyên: câu lệnh nó đã chạy kèm kết quả in ra, hoặc ảnh chụp màn hình. Một lời khẳng định rằng test qua hết, không kèm kết quả, gần như không nói lên điều gì; còn đọc kết quả thì nhanh hơn tự chạy lại, và là thứ duy nhất bạn có khi không ngồi theo dõi phiên làm việc.
Khi đọc đầu ra, để ý ba điều:
- Số test có đúng như bạn nghĩ không. "Ran 0 tests" hay "no tests ran" là dấu hiệu test không được tìm thấy, chứ không phải mọi thứ đều đúng.
- Test có bị bỏ qua không. Test đánh dấu bỏ qua (skip) hay test bị chú thích tắt đi trông như "qua" nhưng không kiểm gì.
- Chương trình có chạy thật không. Test qua mà ứng dụng không khởi động được vẫn là hỏng. Tài liệu Claude Code nhắc tới lệnh
/verifyđể agent dựng và chạy ứng dụng rồi xem kết quả, nhằm bắt loại lỗi mà test và kiểm kiểu bỏ sót.
Lớp 2: đọc từng thay đổi
Trước khi commit, đọc thay đổi bằng git diff (hoặc trang so sánh của pull request). Việc này nhanh hơn bạn nghĩ nếu đi theo danh sách:
| Câu hỏi | Vì sao quan trọng |
|---|---|
| Thay đổi có nằm đúng phạm vi việc đã giao không? | Agent đôi khi "tiện tay" sửa tệp khác hoặc định dạng lại cả tệp |
| Có test nào bị sửa, bị xóa hay bị tắt không? | Sửa test cho khớp code sai là cách "qua test" dễ nhất |
| Kết quả mong đợi trong test có được tính độc lập không? | Test sao chép đúng phép tính của code sẽ luôn qua, dù code sai |
| Có xử lý đầu vào xấu, danh sách rỗng, giá trị trùng không? | Ca biên là nơi code AI hay sai nhất |
| Có thư viện mới, lệnh gọi mạng, đọc hay ghi tệp ngoài phạm vi không? | Mỗi phụ thuộc mới là thêm rủi ro bảo mật và bảo trì |
| Có khóa API, mật khẩu, đường dẫn riêng của máy bạn lọt vào code không? | Xem giữ khóa API an toàn |
| Bạn có giải thích được từng đoạn không? | Đoạn nào không giải thích được là đoạn bạn chưa thật sự kiểm |
Câu cuối là tiêu chí quan trọng nhất. Nếu bạn không giải thích được một đoạn code, hãy hỏi agent vì sao nó viết như vậy, hoặc viết lại đoạn đó cho tới khi bạn hiểu.
Lớp 3: đối chiếu độc lập
Lớp này dùng một nguồn khác để kiểm, nên bắt được lỗi mà code và test cùng mắc. Có hai cách.
Đối chiếu với lời giải vét cạn
Nhiều bài toán có một lời giải chậm nhưng hiển nhiên đúng: thử mọi khả năng. Lời giải nhanh do AI viết có thể đối chiếu với nó trên hàng trăm đầu vào nhỏ ngẫu nhiên. Đây chính là kỹ thuật sinh test và đối chiếu (stress testing) quen thuộc với người luyện thi lập trình; bài kỹ thuật sinh test và đối chiếu code trình bày chi tiết.
Ví dụ: bài toán đếm số cặp chỉ số i < j có a[i] + a[j] == k. Giả sử AI đưa lời giải sắp xếp rồi dùng hai con trỏ, chạy O(n log n), trông rất gọn. Đoạn code dưới đây đặt ba bản cạnh nhau: bản AI viết, bản vét cạn O(n²) làm thước đo, và bản sửa dùng bảng đếm O(n). Hàm doi_chieu thử hết các mảng ngắn trước rồi mới tới mảng dài, nên phản ví dụ tìm được là nhỏ.
"""Đối chiếu hàm do AI viết với một bản vét cạn chậm nhưng chắc chắn đúng, trên nhiều đầu vào ngẫu nhiên nhỏ.

Bài toán: đếm số cặp chỉ số i < j có a[i] + a[j] == k.
Bản "AI viết" dùng sắp xếp và hai con trỏ: chạy đúng ví dụ mẫu, nhưng sai khi mảng có phần tử trùng nhau.
"""
import random
from collections import Counter


def dem_cap_ai(a, k):
    """Bản AI viết: sắp xếp rồi dùng hai con trỏ. Bỏ sót cặp khi có giá trị trùng."""
    a = sorted(a)
    i, j, dem = 0, len(a) - 1, 0
    while i < j:
        s = a[i] + a[j]
        if s == k:
            dem += 1
            i += 1
            j -= 1
        elif s < k:
            i += 1
        else:
            j -= 1
    return dem


def dem_cap_vet_can(a, k):
    """Bản chậm O(n^2): thử mọi cặp. Dùng làm thước đo đúng sai."""
    return sum(1 for i in range(len(a)) for j in range(i + 1, len(a)) if a[i] + a[j] == k)


def dem_cap_dung(a, k):
    """Bản sửa O(n): đếm số lần đã gặp mỗi giá trị."""
    da_gap, dem = Counter(), 0
    for x in a:
        dem += da_gap[k - x]
        da_gap[x] += 1
    return dem


def doi_chieu(ham, so_lan=1000, hat_giong=1):
    """Thử từ mảng ngắn tới dài; trả về đầu vào sai đầu tiên, hoặc None nếu qua hết."""
    rd = random.Random(hat_giong)
    moi_do_dai = so_lan // 9
    for n in range(9):  # thử hết mảng ngắn rồi mới tới mảng dài, nên phản ví dụ tìm được là nhỏ
        for _ in range(moi_do_dai):
            a = [rd.randint(0, 3) for _ in range(n)]
            k = rd.randint(0, 6)
            if ham(a, k) != dem_cap_vet_can(a, k):
                return a, k
    return None


def chay_thu():
    print(f"Ví dụ mẫu a=[1, 2, 3, 4], k=5: ra {dem_cap_ai([1, 2, 3, 4], 5)}, đúng là {dem_cap_vet_can([1, 2, 3, 4], 5)}")
    sai = doi_chieu(dem_cap_ai)
    if sai:
        a, k = sai
        print(f"Bản AI viết sai ở a={a}, k={k}: ra {dem_cap_ai(a, k)}, đúng là {dem_cap_vet_can(a, k)}")
    print("Bản sửa:", "qua 999 lần thử" if doi_chieu(dem_cap_dung) is None else "vẫn sai")
    return sai


if __name__ == "__main__":
    chay_thu()
Kết quả:
Ví dụ mẫu a=[1, 2, 3, 4], k=5: ra 2, đúng là 2
Bản AI viết sai ở a=[0, 0, 2], k=2: ra 1, đúng là 2
Bản sửa: qua 999 lần thử
Ví dụ mẫu qua, nên nếu chỉ thử bằng tay một lần, bạn sẽ tin code đúng. Nhưng với [0, 0, 2] và k = 2, có hai cặp (mỗi số 0 ghép với số 2), còn bản hai con trỏ sau khi ghép được một cặp thì dịch cả hai con trỏ vào trong và bỏ sót cặp còn lại. Lỗi chỉ lộ ra khi có giá trị trùng, đúng loại ca biên mà người viết test bằng tay hay quên. Phản ví dụ chỉ có ba phần tử, nên đọc là hiểu ngay lỗi ở đâu.
Ba điều làm cách này hiệu quả:
- Thước đo phải hiển nhiên đúng. Bản vét cạn viết đơn giản tới mức nhìn là biết đúng; nếu ngờ nó, hãy kiểm nó trên vài ca tính tay trước.
- Đầu vào nhỏ, giá trị trong khoảng hẹp. Mảng ngắn và giá trị từ 0 tới 3 tạo ra nhiều phần tử trùng, nên lỗi hiện ra sớm và phản ví dụ dễ đọc.
- Cố định hạt giống ngẫu nhiên để chạy lại được đúng phản ví dụ đó khi sửa.
Một người xem lại chưa thấy cuộc trò chuyện
Với việc không có lời giải vét cạn (giao diện, tích hợp nhiều thành phần), hãy nhờ một người xem lại độc lập. Tài liệu Claude Code nhắc tới lệnh /code-review: một subagent hoàn toàn mới, không biết gì về cuộc trò chuyện, rà các thay đổi, nên không bị lập luận ban đầu dẫn dắt. Tài liệu cũng nói rõ: giao lại cùng một việc cho subagent không làm câu trả lời tốt hơn, nhưng một người xem lại mới thì có ích, vì họ chưa thấy lập luận của bạn.
Khi viết yêu cầu xem lại, hãy cho tiêu chí cụ thể (so với bản đặc tả, kiểm các ca biên có test) và dặn bỏ qua chuyện phong cách. Lý do, theo tài liệu: ai được giao đi tìm lỗi cũng sẽ luôn tìm ra điều để chê, và làm theo mọi lời chê dễ sinh ra code rườm rà cùng test cho những tình huống không bao giờ xảy ra.
Kiểm bao nhiêu là đủ?
Không phải thay đổi nào cũng cần cả ba lớp. Hãy chọn theo rủi ro:
| Loại thay đổi | Ví dụ | Kiểm tối thiểu |
|---|---|---|
| Thấp | Đổi tên biến, sửa chú thích, định dạng | Lớp 1 (test vẫn qua) + nhìn nhanh thay đổi |
| Vừa | Thêm hàm mới, sửa lỗi logic | Lớp 1 + lớp 2 đầy đủ, có test cho ca biên |
| Cao | Thuật toán lõi, xử lý tiền, phân quyền, xóa hay di chuyển dữ liệu | Cả ba lớp + một người duyệt trước khi gộp |
Với thay đổi rủi ro cao, đừng để agent tự chạy trên dữ liệu thật. Thử trên bản sao, có kế hoạch quay lại, và nhớ rằng theo tài liệu Claude Code, chức năng quay lại của nó chỉ áp dụng cho thay đổi tệp; thao tác lên cơ sở dữ liệu, API hay hệ thống triển khai thì không quay lại được. Xem thêm giới hạn quyền khi cho AI tự chạy lệnh.
Muốn một bước kiểm luôn chạy mà không phụ thuộc agent có nhớ hay không, hãy biến nó thành hook: ví dụ hook báo lỗi cú pháp sau mỗi lần sửa, hoặc hook Stop chạy test trước khi agent được dừng. Bài hooks cho AI có ví dụ.
- Chấp nhận lời báo "test qua hết" khi chưa tận mắt xem kết quả chạy.
- Để cùng một AI viết cả code lẫn test rồi coi test qua là bằng chứng đủ.
- Không để ý test bị sửa hay bị tắt trong cùng thay đổi.
- Chỉ thử ví dụ mẫu trong đề; lỗi thường nằm ở danh sách rỗng, giá trị trùng, số âm, số rất lớn.
- Gộp thay đổi bạn không giải thích được.
- Kiểm mọi thay đổi với cùng một mức: tốn công ở chỗ ít rủi ro, lơ là ở chỗ nguy hiểm.
Câu hỏi thường gặp
Có nên để AI tự viết test cho code của nó không?
Được, nhưng đừng coi đó là lớp kiểm duy nhất. Tự đọc test xem kết quả mong đợi có được tính độc lập không, và thêm ít nhất một lớp kiểm khác như đối chiếu với vét cạn hoặc một người xem lại.
Không có lời giải vét cạn thì đối chiếu thế nào?
Dùng tính chất mà kết quả phải thỏa: sắp xếp xong thì dãy không giảm và giữ nguyên các phần tử; mã hóa rồi giải mã phải ra dữ liệu ban đầu. Hoặc so với một thư viện đã được kiểm kỹ làm cùng việc.
Đọc thay đổi mất nhiều thời gian quá thì sao?
Giao việc nhỏ hơn để mỗi lần thay đổi ít tệp hơn, dùng danh sách câu hỏi ở trên để đọc có trọng tâm, và để test tự động lo phần kiểm lặp lại.
AI nói code đã được kiểm kỹ, có tin được không?
Đề nghị nó cho xem câu lệnh và kết quả in ra. Lời khẳng định không thay được kết quả chạy.
Học tiếp
- Muốn tìm hiểu sâu kỹ thuật đối chiếu, đọc kỹ thuật sinh test và đối chiếu code.
- Muốn đặt phép kiểm vào quy trình làm việc với agent, đọc quy trình làm dự án với agent.
- Muốn bước kiểm chạy tự động mỗi lần, đọc hooks cho AI.
Nếu bạn muốn rèn nền tảng thuật toán để nhận ra lời giải sai, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.