Nhận diện nhóm bài Top K và hợp đồng cần chốt với người phỏng vấn
Trong các vòng phỏng vấn thuật toán lẫn thiết kế hệ thống (System Design), bài toán trích xuất K phần tử đứng đầu (Top K Elements) xuất hiện liên tục dưới nhiều hình thức:
- Kth Largest Element in an Array: Tìm phần tử lớn thứ
ktrong mảng chưa sắp xếp. - Top K Frequent Elements / Words: Tìm
kgiá trị (hoặc từ vựng) có tần suất xuất hiện cao nhất. - K Closest Points to Origin: Tìm
kđiểm trên mặt phẳng tọa độ có khoảng cách Euclid tới gốc(0, 0)nhỏ nhất. - Kth Largest Element in a Stream: Duy trì phần tử lớn thứ
kkhi dữ liệu chảy vào liên tục theo thời gian thực.
Trước khi chọn giải pháp giữa Sắp xếp toàn bộ, Heap kích thước k, Quickselect hay Bucket Sort, bạn nên hỏi rõ người phỏng vấn 4 điểm định hình lời giải:
- Định nghĩa "lớn thứ k" khi có phần tử trùng nhau: Với mảng
[3, 2, 3, 1, 2, 4, 5, 5, 6]vàk = 4, sau khi sắp giảm dần thành[6, 5, 5, 4, 3, 3, 2, 2, 1], phần tử lớn thứ 4 tính theo chỉ số sau khi sắp (tức là số4) hay tính theo các giá trị phân biệt? Trong 99% đề chuẩn (như LeetCode 215), đề bài tính theo thứ tự sau khi sắp xếp không giảm (bao gồm cả bản sao). - Dữ liệu tĩnh trong bộ nhớ hay luồng dữ liệu trực tuyến (streaming)? Nếu dữ liệu là luồng vô tận hoặc mảng quá lớn không vừa RAM, bạn không thể dùng Quickselect (vì cần truy cập ngẫu nhiên toàn bộ mảng) mà bắt buộc phải dùng Heap kích thước
k. - Có được phép sửa đổi mảng đầu vào không? Thuật toán chọn nhanh Hoare (Quickselect) đạt trung bình
O(n)vớiO(1)bộ nhớ phụ nhưng sẽ tráo đổi các phần tử ngay trên mảng gốc. - Quan hệ giữa
kvàn: Nếukrất nhỏ so vớin(ví dụ tìm Top 10 bài viết từ 10 triệu bản ghi),O(n log k)bằng Heap cực kỳ lợi thế; nếukxấp xỉn / 2, Quickselect hoặc Bucket Sort sẽ được hỏi tới ở phần mở rộng.
Quy tắc chọn loại Heap cho bài toán Top K luôn ngược với tên gọi: để giữ K phần tử lớn nhất, hãy dùng Min-Heap kích thước k; để giữ K phần tử nhỏ nhất, hãy dùng Max-Heap kích thước k. Đỉnh của Heap đóng vai trò là "người gác cổng" yếu nhất trong nhóm Top K hiện tại: bất kỳ ứng viên mới nào vượt qua được người gác cổng đều xứng đáng thế chỗ vào nhóm.
Tại sao tìm K phần tử lớn nhất lại dùng Min-Heap thay vì Max-Heap?
Khi nghe đề bài "tìm phần tử lớn thứ k", phản xạ tự nhiên của nhiều ứng viên là đẩy tất cả n phần tử vào một Max-Heap rồi gọi lệnh pop() đúng k lần. Cách đó đúng và tốn thời gian O(n + k log n) (nếu dựng Heap dưới lên bằng heapify), nhưng lại cần tới O(n) bộ nhớ để chứa toàn bộ mảng trong Heap.
Ngược lại, nếu ta chỉ duy trì một Min-Heap chứa tối đa k phần tử lớn nhất đã từng gặp tính đến thời điểm hiện tại:
- Phần tử nằm ở đỉnh Min-Heap (
min_heap.top()) là phần tử nhỏ nhất trong sốkphần tử lớn nhất, tức là ứng viên đang giữ vị trí lớn thứktạm thời. - Khi xét phần tử mới
x:- Nếu
min_heap.size() < k: nhóm Top K chưa đủ chỗ, ta đẩy thẳngxvào Heap. - Nếu
min_heap.size() == kvàx <= min_heap.top(): vìxcòn không thắng nổi phần tử nhỏ nhất trong nhómkanh dẫn đầu,xchắc chắn không có cơ hội lọt vào Top K (chỉ mấtO(1)để bỏ qua!). - Nếu
min_heap.size() == kvàx > min_heap.top():xxứng đáng vào Top K hơn phần tử ở đỉnh, nên ta loại bỏ đỉnh cũ (pop) và đưaxvào (push).
- Nếu
Sau khi quét hết n phần tử, Min-Heap chứa đúng k phần tử lớn nhất của cả mảng, và đỉnh min_heap.top() chính là phần tử lớn thứ k.
Chạy tay từng bước trên nums = [3, 2, 1, 5, 6, 4], k = 2
Hãy theo dõi trạng thái của Min-Heap cỡ k = 2 khi duyệt qua từng phần tử của mảng [3, 2, 1, 5, 6, 4]:
| Bước | Phần tử x |
Kích thước Heap trước bước | So sánh với top() |
Thao tác thực hiện | Min-Heap sau bước (đỉnh ở đầu) |
|---|---|---|---|---|---|
| 1 | 3 |
0 < 2 |
Chưa đủ k phần tử |
push(3) |
[3] (top = 3) |
| 2 | 2 |
1 < 2 |
Chưa đủ k phần tử |
push(2) |
[2, 3] (top = 2) |
| 3 | 1 |
2 == 2 |
1 <= top (2) |
Bỏ qua trong O(1) |
[2, 3] (top = 2) |
| 4 | 5 |
2 == 2 |
5 > top (2) |
pop() bỏ 2, push(5) |
[3, 5] (top = 3) |
| 5 | 6 |
2 == 2 |
6 > top (3) |
pop() bỏ 3, push(6) |
[5, 6] (top = 5) |
| 6 | 4 |
2 == 2 |
4 <= top (5) |
Bỏ qua trong O(1) |
[5, 6] (top = 5) |
Kết thúc vòng quét, hai phần tử lớn nhất của mảng là 5 và 6 nằm gọn trong Heap, và đỉnh min_heap.top() = 5 là câu trả lời chính xác cho phần tử lớn thứ 2.
Code mẫu C++17, Python và Java 21
Chương trình dưới đây cài đặt thuật toán tìm phần tử lớn thứ k bằng Min-Heap kích thước k trên cả 3 ngôn ngữ. Khi chạy không có đầu vào từ stdin, chương trình tự động kiểm tra bộ mẫu nums = [3, 2, 1, 5, 6, 4], k = 2 và in ra 5.
#include <functional>
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    int n = 6, k = 2;
    vector<long long> nums = {3, 2, 1, 5, 6, 4};
    if (cin >> n >> k) {
        nums.resize(n);
        for (auto& x : nums) cin >> x;
    }
    priority_queue<long long, vector<long long>, greater<long long>> min_heap;
    for (long long x : nums) {
        if ((int)min_heap.size() < k) {
            min_heap.push(x);
        } else if (x > min_heap.top()) {
            min_heap.pop();
            min_heap.push(x);
        }
    }
    cout << min_heap.top() << '\n';
    return 0;
}
import heapq
import sys


def find_kth_largest(nums: list[int], k: int) -> int:
    min_heap: list[int] = []
    for x in nums:
        if len(min_heap) < k:
            heapq.heappush(min_heap, x)
        elif x > min_heap[0]:
            heapq.heapreplace(min_heap, x)
    return min_heap[0]


def main() -> None:
    data = list(map(int, sys.stdin.buffer.read().split()))
    if len(data) >= 2:
        k = data[1]
        nums = data[2:]
    else:
        k = 2
        nums = [3, 2, 1, 5, 6, 4]
    print(find_kth_largest(nums, k))


if __name__ == "__main__":
    main()
import java.util.*;

public class Main {
    static long findKthLargest(long[] nums, int k) {
        PriorityQueue<Long> minHeap = new PriorityQueue<>();
        for (long x : nums) {
            if (minHeap.size() < k) {
                minHeap.offer(x);
            } else if (x > minHeap.peek()) {
                minHeap.poll();
                minHeap.offer(x);
            }
        }
        return minHeap.peek();
    }

    public static void main(String[] args) {
        Scanner sc = new Scanner(System.in);
        int k = 2;
        long[] nums = {3, 2, 1, 5, 6, 4};
        if (sc.hasNextInt()) {
            int n = sc.nextInt();
            k = sc.nextInt();
            nums = new long[n];
            for (int i = 0; i < n; i++) nums[i] = sc.nextLong();
        }
        System.out.println(findKthLargest(nums, k));
    }
}
Trong bản Python, khi len(min_heap) == k và x > min_heap[0], ta dùng hàm heapq.heapreplace(min_heap, x) (hoặc heappushpop). Hàm này thay trực tiếp gốc của Heap bằng x rồi vun đống xuống (sift-down) chỉ trong một lượt, nên ít phép so sánh hơn việc gọi rời hai lệnh heappop rồi heappush.
Độ phức tạp và khác biệt mặc định của Priority Queue giữa 3 ngôn ngữ
- Thời gian:
O(n log k)trong trường hợp xấu nhất (khi mảng đầu vào tăng dần, mọi phần tử đều lớn hơntop()và kích hoạtpop/pushtrên Heap cỡk). Nếu thứ tự dữ liệu ngẫu nhiên (các giá trị khác nhau), phần tử thứi(vớii > k) chỉ lớn hơntop()khi nó thuộc nhómksố lớn nhất củaisố đầu tiên, xác suất làk / i. Vì vậy đa số phần tử bị bỏ qua trongO(1), số lầnpop/pushkỳ vọng chỉ khoảngk · ln(n / k), và thời gian kỳ vọng làO(n + k log k · (1 + log(n / k))). - Bộ nhớ phụ:
O(k)— chỉ lưu tối đakphần tử trong Heap tại mọi thời điểm. - Khác biệt mặc định giữa C++, Python và Java (rất hay bị hỏi trong phỏng vấn):
- Trong C++17,
std::priority_queue<T>mặc định là Max-Heap! Để biến thành Min-Heap, bạn phải khai báo đủ 3 tham số mẫu:priority_queue<long long, vector<long long>, greater<long long>>. - Trong Python (
heapq) và Java 21 (java.util.PriorityQueue), cấu trúc mặc định lại là Min-Heap! Khi cần Max-Heap trong Python, từ Python 3.14 bạn dùng thẳngheapq.heappush_max/heapq.heappop_max; với bản cũ hơn, mẹo quen thuộc với số nguyên là đổi dấu-xtrước khi đẩy vào; còn trong Java 21, bạn khởi tạonew PriorityQueue<>(Collections.reverseOrder())hoặc truyền biểu thức lambda(a, b) -> Long.compare(b, a).
- Trong C++17,
So sánh 5 chiến lược giải bài toán Top K trong phỏng vấn
Khi người phỏng vấn hỏi tiếp: "Em còn cách nào giảm độ phức tạp xuống O(n) không?", bạn có thể trình bày bảng đối chiếu 5 phương pháp dưới đây để thể hiện chiều sâu kiến thức:
| Phương pháp | Thời gian trung bình | Thời gian xấu nhất | Bộ nhớ phụ | Khi nào là lựa chọn tốt nhất? |
|---|---|---|---|---|
| Sắp xếp toàn bộ (Full Sort) | O(n log n) |
O(n log n) |
O(1) đến O(n) |
Khi n nhỏ (<= 10^4) hoặc đằng nào cũng cần toàn bộ mảng theo thứ tự sắp xếp |
Min-Heap kích thước k |
O(n log k) |
O(n log k) |
O(k) |
Khi k << n, khi dữ liệu là luồng trực tuyến (stream), hoặc không được sửa mảng gốc |
Max-Heap heapify toàn mảng |
O(n + k log n) |
O(n + k log n) |
O(n) |
Khi đã có sẵn mảng trong bộ nhớ, được dùng O(n) không gian và k rất nhỏ |
| Quickselect (Phân hoạch Hoare) | O(n) |
O(n²) (nếu chọn chốt kém) |
O(1) |
Khi toàn bộ mảng nằm trong RAM, được phép tráo đổi tại chỗ và cần tối ưu thời gian kỳ vọng |
| Bucket Sort theo tần suất | O(n) |
O(n) |
O(n) |
Dành riêng cho bài Top K Frequent Elements vì tần suất của mỗi phần tử chỉ nằm trong đoạn [1..n] |
Với bài Top K Frequent Elements (tìm k số xuất hiện nhiều nhất), sau khi đếm tần suất bằng bảng băm trong O(n), bạn vừa có thể đẩy các cặp (freq, num) vào Min-Heap cỡ k để đạt O(n log k), vừa có thể tạo mảng các thùng buckets[1..n] (trong đó buckets[f] chứa danh sách các số xuất hiện đúng f lần) rồi quét ngược từ f = n về 1 để nhặt đủ k phần tử trong đúng O(n) xác định.
Các lỗi sai phổ biến và cách tự kiểm tra code
- Dùng nhầm Max-Heap kích thước
kkhi tìm K phần tử lớn nhất: Nếu bạn dùng Max-Heap và mỗi khi kích thước vượtklại gọipop(), phần tử bị văng ra khỏi Heap chính là phần tử lớn nhất, nên cuối cùng Heap của bạn chỉ còn lạikphần tử nhỏ nhất! - Không kiểm tra
x > min_heap.top()mà luônpush(x)rồipop(): Cách viếtmin_heap.push(x); if (min_heap.size() > k) min_heap.pop();vẫn cho kết quả đúng, nhưng khix <= min_heap.top(), bạn vẫn tốnO(log k)để đẩyxvào rồi lập tức lấy chínhxra. Kiểm traif (x > min_heap.top())trước giúp bỏ qua ngay trongO(1)và không bao giờ để kích thước Heap vượt lênk + 1. - Tính căn bậc hai
sqrt(x*x + y*y)trong bài K Closest Points: Hàmsqrtsố thực vừa chậm vừa dễ sai số làm tròn; bạn chỉ cần so sánh bình phương khoảng cách1LL * x * x + 1LL * y * ytrên kiểu số nguyên 64-bitlong long.
Để tự kiểm tra code trước khi kết thúc bài làm, bạn có thể viết một hàm đối chiếu chỉ 2 dòng (sắp xếp mảng giảm dần rồi lấy nums[k - 1]) và chạy thử trên 4 ca biên:
k = 1(tìm phần tử lớn nhất) vàk = n(tìm phần tử nhỏ nhất của mảng, ví dụn = 5, k = 5trên[-1, -5, 0, 3, 2]→ phải trả về-5).- Mảng chỉ có đúng 1 phần tử (
n = 1, k = 1, nums = [42]→ trả về42). - Mảng có nhiều phần tử trùng nhau quanh vị trí thứ
k(nums = [3, 2, 3, 1, 2, 4, 5, 5, 6],k = 4→ trả về4). - Mảng toàn số nguyên âm để chắc chắn bạn không khởi tạo biến chốt bằng
0.
Luyện ngay trên Big-O Coding
Bạn hãy thực hành ngay 3 bài toán sử dụng cấu trúc dữ liệu Heap và chọn phần tử lớn thứ K trong lộ trình Coding Interview 150 dưới đây.
Câu hỏi thường gặp
Tại sao Quickselect có độ phức tạp trung bình là O(n) chứ không phải O(n log n) như Quicksort?
Trong Quicksort, sau khi phân hoạch mảng quanh phần tử chốt (pivot), ta phải đệ quy xuống cả hai nửa trái và phải nên tổng chi phí là \(n + 2 \cdot (n/2) + \dots = O(n \log n)\). Ngược lại, trong Quickselect, ta biết chính xác chỉ số \(k\) cần tìm nằm ở bên trái hay bên phải chốt, nên ta chỉ đệ quy vào đúng một nửa chứa vị trí \(k\) và bỏ hẳn nửa kia. Tổng số phép so sánh trung bình là chuỗi hình học \(n + n/2 + n/4 + n/8 + \dots \le 2n = O(n)\).
Trong bài Top K Frequent Words, nếu hai từ có cùng tần suất nhưng đề yêu cầu ưu tiên từ có thứ tự từ điển nhỏ hơn thì viết bộ so sánh cho Min-Heap thế nào?
Vì Min-Heap sẽ loại bỏ phần tử "yếu nhất" ở đỉnh khi đầy, bạn phải định nghĩa phần tử "yếu hơn" là phần tử có tần suất nhỏ hơn, hoặc nếu cùng tần suất thì có thứ tự từ điển lớn hơn (ví dụ "love" đứng sau "i" nên "love" bị loại trước để giữ lại "i"). Khi kết thúc và lấy các từ ra khỏi Min-Heap, bạn chỉ cần đảo ngược danh sách kết quả là có thứ tự từ mạnh nhất đến yếu nhất.
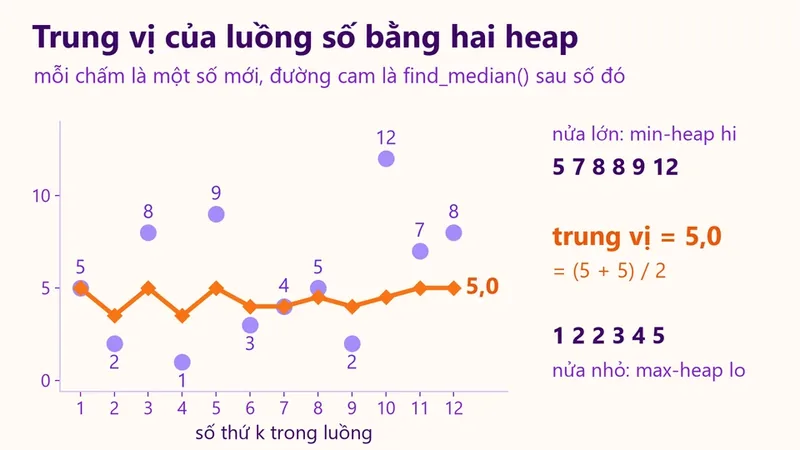
Làm sao tìm trung vị của luồng dữ liệu (Find Median from Data Stream) bằng hai Heap?
Đó là mở rộng kinh điển của mẫu Top K: bạn chia các số đã đọc thành hai nửa bằng nhau. Nửa nhỏ hơn được lưu trong một Max-Heap lo, nửa lớn hơn được lưu trong một Min-Heap hi, giữ bất biến 0 <= lo.size() - hi.size() <= 1. Khi đó trung vị luôn nằm ngay ở đỉnh lo.top() (nếu tổng số phần tử lẻ) hoặc là trung bình cộng của hai đỉnh (lo.top() + hi.top()) / 2.0 (nếu chẵn) trong thời gian truy vấn O(1) và thêm mới O(log n).
Luyện LeetCode thực chiến theo pattern, giải bài trong 45 phút và mock interview cùng AI. 16 buổi online, lớp 7–12 học viên, chọn C++, Java hoặc Python.