- Phỏng vấn System Design không tìm kiếm một đáp án duy nhất đúng, mà đánh giá khả năng làm rõ yêu cầu mơ hồ, ước lượng thông số kỹ thuật và cân bằng đánh đổi (Trade-off) giữa độ trễ, tính nhất quán và chi phí.
- Luôn tuân thủ khung 4 bước phân bổ trong 45 phút: Làm rõ yêu cầu & Ước lượng tải (10 phút) \(\rightarrow\) Thiết kế tổng quan & API (10 phút) \(\rightarrow\) Đi sâu vào thành phần cốt lõi (15–20 phút) \(\rightarrow\) Xử lý nút thắt cổ chai & Mở rộng (5 phút).
- Nắm vững công thức nháp nhanh Back-of-the-Envelope: quy đổi số người dùng hoạt động hằng ngày (\(\text{DAU}\)) sang thông lượng đọc/ghi mỗi giây (\(\text{QPS}\)) với mốc \(1\text{ ngày} = 86{,}400\text{ giây} \approx 10^5\text{ giây}\).
- Thành thạo 4 mảnh ghép nền tảng giải quyết \(80\%\) bài toán thiết kế: Cân bằng tải (Load Balancer), Bộ nhớ đệm (Caching), Nhân bản & Phân mảnh cơ sở dữ liệu (Replication & Sharding), và Hàng đợi tin nhắn bất đồng bộ (Message Queue).
Sự khác biệt giữa vòng Coding và vòng System Design
Trong quá trình ôn luyện theo lộ trình luyện LeetCode phỏng vấn Big Tech, bạn đã quen với việc nhận một hàm có chữ ký cố định, biết rõ giới hạn \(N \le 10^5\) và mục tiêu là giảm độ phức tạp từ \(\mathcal{O}(N^2)\) xuống \(\mathcal{O}(N \log N)\). Ngược lại, khi bước vào phòng phỏng vấn System Design (thường bắt buộc từ cấp độ Kỹ sư Phần mềm L4/SDE II trở lên, hoặc xuất hiện ở mức cơ bản với vị trí Fresher/SDE I tại nhiều công ty sản phẩm), người phỏng vấn chỉ đưa ra một yêu cầu rất ngắn:
"Hãy thiết kế cho tôi hệ thống bảng tin (News Feed) giống Facebook, hoặc dịch vụ rút gọn liên kết giống Bitly."
Nếu bạn lập tức cầm bút vẽ ngay cụm máy chủ Kubernetes, Kafka hay phân mảnh cơ sở dữ liệu khi chưa hỏi bất kỳ câu nào, đó là tín hiệu đỏ (Red Flag) lớn nhất. Một hệ thống phục vụ \(1{,}000\) nhân viên nội bộ có kiến trúc hoàn toàn khác với hệ thống phục vụ \(100\text{ triệu}\) người dùng toàn cầu. Do đó, kỹ năng đầu tiên cần rèn luyện là dẫn dắt cuộc trò chuyện theo cấu trúc 4 bước khoa học.
Khung 4 bước giải quyết bài toán System Design trong 45 phút
Trừ đi 5 phút giới thiệu đầu giờ và 5 phút hỏi đáp cuối giờ, bạn có khoảng 35 đến 40 phút thực chiến. Việc chia nhỏ thời gian theo 4 chặng giúp bạn không bị sa lầy vào các chi tiết phụ:
Bước 1: Làm rõ yêu cầu và Ước lượng quy mô (Phút 01 – 10)
Đừng tự giả định tính năng. Hãy đặt câu hỏi để thu hẹp phạm vi vào hai nhóm:
- Yêu cầu chức năng (Functional Requirements — FR): Người dùng thực hiện được 2–3 hành động cốt lõi nào? (Ví dụ: Đăng bài viết văn bản kèm ảnh, xem bảng tin của bạn bè theo thứ tự thời gian). Tạm gác các tính năng phụ như bình luận lồng nhau, quảng cáo hay nhắn tin riêng trừ khi người phỏng vấn yêu cầu.
- Yêu cầu phi chức năng (Non-Functional Requirements — NFR):
- Quy mô người dùng (\(\text{DAU}\) — Daily Active Users) là bao nhiêu? Tỷ lệ đọc so với ghi (\(\text{Read:Write ratio}\)) là \(10:1\) hay \(100:1\)?
- Hệ thống ưu tiên Tính sẵn sàng cao (High Availability) hay Tính nhất quán chặt chẽ (Strong Consistency) theo định lý CAP? (Ví dụ: Bảng tin mạng xã hội chấp nhận trễ vài giây — Eventual Consistency, nhưng hệ thống chuyển tiền ngân hàng hay đặt giữ ghế máy bay bắt buộc phải nhất quán tức thì).
- Độ trễ mục tiêu (\(\text{Latency SLA}\)) cho thao tác đọc là dưới \(200\text{ ms}\) hay \(500\text{ ms}\)?
Bước 2: Thiết kế cấp cao và Giao diện API (Phút 11 – 20)
- Viết nhanh chữ ký 2–3 RESTful hoặc gRPC API chính (đường dẫn, tham số đầu vào, mã phản hồi HTTP).
- Lên sơ đồ lược đồ dữ liệu cốt lõi (Data Schema): các bảng chính, khóa chính (Primary Key), khóa ngoại và loại cơ sở dữ liệu (Quan hệ RDBMS hay NoSQL).
- Vẽ sơ đồ khối cấp cao (High-Level Diagram) từ đầu đến cuối:
Client\(\rightarrow\)CDN / Load Balancer\(\rightarrow\)API Gateway\(\rightarrow\)Service Layer\(\rightarrow\)Cache&Database. Đảm bảo một yêu cầu thông thường đi từ đầu vào đến đầu ra hoàn chỉnh.
Bước 3: Đi sâu vào thành phần trọng tâm — Deep Dive (Phút 21 – 35)
Dựa trên tín hiệu từ người phỏng vấn, hãy chọn 1–2 bài toán hóc búa nhất của đề bài để phân tích sâu:
- Nếu thiết kế hệ thống rút gọn link URL Shortener: Đi sâu vào cơ chế sinh mã định danh duy nhất không đụng độ và mã hóa Base62.
- Nếu thiết kế bộ giới hạn tốc độ Rate Limiter: Đi sâu vào thuật toán Token Bucket và chống tranh chấp dữ liệu bằng Redis Lua Script.
- Nếu thiết kế hệ thống bảng tin (News Feed): Phân tích mô hình đẩy khi ghi (Fan-out on Write) cho người dùng thường kết hợp kéo khi đọc (Fan-out on Read) cho tài khoản người nổi tiếng có hàng triệu người theo dõi (Celebrity / Hot Key problem).
Bước 4: Xử lý điểm nghẽn, Giám sát và Tổng kết (Phút 36 – 40)
Tự rà soát sơ đồ của mình để chỉ ra Điểm lỗi đơn (Single Point of Failure — SPOF): điều gì xảy ra nếu máy chủ cơ sở dữ liệu chính bị sập? Làm sao phát hiện sự cố sớm thông qua hệ thống giám sát (Metrics, Logging, Alerting)?
Nghệ thuật tính nhẩm Back-of-the-Envelope trong 3 phút
Mọi quyết định chọn cơ sở dữ liệu hay số lượng máy chủ đều phải bắt nguồn từ con số. Bạn không cần tính chính xác đến từng chữ số thập phân, mà cần nắm vững quy tắc làm tròn theo lũy thừa của 10.
Các hằng số vàng cần nhớ thuộc lòng
- Số giây trong 1 ngày: \(24 \times 3{,}600 = 86{,}400\text{ giây} \approx 10^5\text{ giây}\) (khi nhẩm nhanh).
- Một máy chủ ứng dụng (Web Server) thông thường xử lý được khoảng \(1{,}000 - 5{,}000\text{ QPS}\) tùy độ nặng nhẹ của tác vụ.
- Một cơ sở dữ liệu quan hệ (PostgreSQL/MySQL) trên ổ cứng SSD NVMe chịu tải tốt ở ngưỡng \(1{,}000 - 3{,}000\text{ Write QPS}\); trong khi một nút Redis trong bộ nhớ RAM xử lý dễ dàng \(50{,}000 - 100{,}000\text{ QPS}\).
Ví dụ chạy tay (Dry-run) bài toán ước lượng tải
Giả sử hệ thống có các thông số đầu vào sau:
- Số người dùng hoạt động mỗi ngày: \(\text{DAU} = 10{,}000{,}000\) (\(10\text{ triệu}\) người).
- Trung bình mỗi người thực hiện \(R = 20\) lượt đọc và \(W = 2\) lượt tạo bản ghi mới mỗi ngày.
- Kích thước trung bình mỗi bản ghi mới (gồm siêu dữ liệu và văn bản): \(S = 500\text{ bytes}\).
Ta tính lần lượt 4 chỉ số cốt lõi:
| Chỉ số cần ước lượng | Công thức tính toán | Phép tính cụ thể | Kết quả thực tế | Ý nghĩa thiết kế kiến trúc |
|---|---|---|---|---|
| 1. Read QPS trung bình | \(\frac{\text{DAU} \times R}{86{,}400}\) (làm tròn) | \(\frac{10^7 \times 20}{86{,}400} \approx 2{,}314.8\) | \(2{,}315\text{ req/s}\) | Tải đọc vừa phải, nhưng cần Cache để giảm áp lực DB |
| 2. Peak Read QPS (Đỉnh) | \(\text{Read QPS} \times 2\) | \(2{,}315 \times 2\) | \(4{,}630\text{ req/s}\) | Cần tối thiểu \(3 - 4\) máy chủ API đứng sau Load Balancer |
| 3. Write QPS trung bình | \(\frac{\text{DAU} \times W}{86{,}400}\) (làm tròn) | \(\frac{10^7 \times 2}{86{,}400} \approx 231.48\) | \(231\text{ req/s}\) | Một cụm DB Primary duy nhất hoàn toàn gánh tốt lượng ghi |
| 4. Lưu trữ tăng thêm/ngày | \(\text{DAU} \times W \times S\) | \(10^7 \times 2 \times 500\text{ B}\) | \(10.0\text{ GB/ngày}\) | Khoảng \(3.65\text{ TB/năm}\) — chưa bắt buộc Sharding ngay năm đầu |
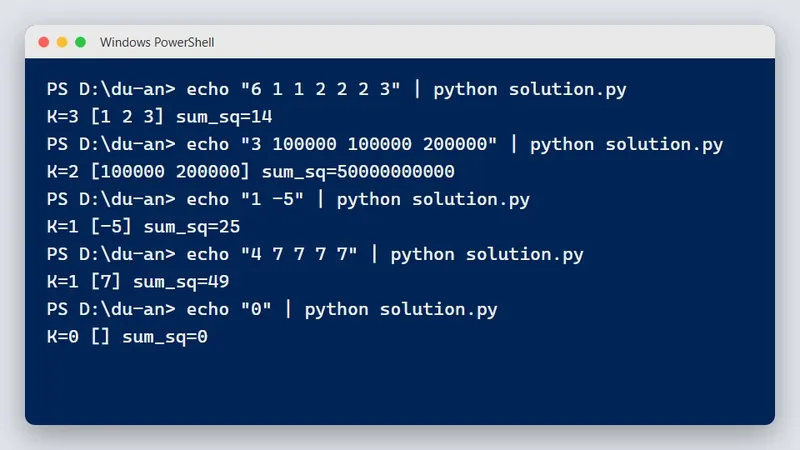
Chương trình dưới đây (C++17, Python, Java 21) tính lại cả 4 chỉ số của bảng cho nhiều kịch bản tải. Mỗi dòng đầu vào là một bộ DAU R W S; mỗi dòng đầu ra gồm Read QPS, Peak QPS, Write QPS và dung lượng ghi thêm theo ngày, theo năm. Mọi phép tính dùng số nguyên 64-bit (tích \(10^7 \times 2 \times 500 = 10^{10}\) byte của ví dụ trên đã vượt giới hạn khoảng \(2.1 \times 10^9\) của kiểu int 32-bit), phép chia làm tròn tới số gần nhất. Chạy không có đầu vào, chương trình dùng đúng kịch bản của bảng và in Read QPS = 2315, Peak QPS = 4630, Write QPS = 231, Storage = 10.0 GB/day = 3.650 TB/year:
// Ước lượng tải kiểu Back-of-the-Envelope cho nhiều kịch bản (bảng "Ví dụ chạy tay" của bài).
// Đầu vào: số kịch bản q, rồi q dòng "DAU R W S". Không có đầu vào thì chạy kịch bản của bảng: 10000000 20 2 500.
// Mọi phép tính làm bằng số nguyên 64-bit (DAU * W * S = 10^10 byte của kịch bản trong bài đã vượt 2^31), phép chia
// làm tròn tới số gần nhất (nửa lên).
// Giới hạn để không tràn long long: DAU <= 10^9, R và W <= 1000, S <= 10^4 byte.
#include <iomanip>
#include <iostream>
#include <sstream>
#include <string>
#include <vector>
using namespace std;

const long long GIAY_MOI_NGAY = 86400;

long long chia_lam_tron(long long a, long long b) {  // a / b làm tròn tới số nguyên gần nhất (a >= 0, b chẵn)
    return (a + b / 2) / b;
}

string uoc_luong(long long dau, long long r, long long w, long long s) {
    long long read_qps = chia_lam_tron(dau * r, GIAY_MOI_NGAY);
    long long peak_qps = 2 * read_qps;
    long long write_qps = chia_lam_tron(dau * w, GIAY_MOI_NGAY);
    long long byte_moi_ngay = dau * w * s;
    long long gb_x10 = chia_lam_tron(byte_moi_ngay, 100000000LL);          // GB/ngày, 1 chữ số thập phân
    long long tb_x1000 = chia_lam_tron(byte_moi_ngay * 365, 1000000000LL);  // TB/năm, 3 chữ số thập phân
    ostringstream out;
    out << "Read QPS = " << read_qps << ", Peak QPS = " << peak_qps << ", Write QPS = " << write_qps
        << ", Storage = " << gb_x10 / 10 << "." << gb_x10 % 10 << " GB/day = " << tb_x1000 / 1000 << "."
        << setw(3) << setfill('0') << tb_x1000 % 1000 << " TB/year";
    return out.str();
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    vector<vector<long long>> kich_ban;
    int q;
    if (!(cin >> q)) {
        kich_ban.push_back({10000000, 20, 2, 500});
    } else {
        for (int i = 0; i < q; ++i) {
            long long dau, r, w, s;
            cin >> dau >> r >> w >> s;
            kich_ban.push_back({dau, r, w, s});
        }
    }
    for (const auto& k : kich_ban) cout << uoc_luong(k[0], k[1], k[2], k[3]) << "\n";
    return 0;
}
# Ước lượng tải kiểu Back-of-the-Envelope cho nhiều kịch bản (bảng "Ví dụ chạy tay" của bài).
# Đầu vào: số kịch bản q, rồi q dòng "DAU R W S" (người dùng mỗi ngày, số lượt đọc và số lượt ghi của mỗi người mỗi
# ngày, số byte của mỗi bản ghi mới). Không có đầu vào thì chạy kịch bản của bảng: 10000000 20 2 500.
# Mọi phép chia làm bằng số nguyên và làm tròn tới số gần nhất (nửa lên). Bản C++ và Java dùng số nguyên 64-bit vì tích
# DAU * W * S = 10^10 byte của kịch bản trong bài đã vượt 2^31.
import sys

GIAY_MOI_NGAY = 86_400


def chia_lam_tron(a: int, b: int) -> int:
    """a / b làm tròn tới số nguyên gần nhất (a >= 0, b > 0 và chẵn)."""
    return (a + b // 2) // b


def uoc_luong(dau: int, r: int, w: int, s: int) -> str:
    read_qps = chia_lam_tron(dau * r, GIAY_MOI_NGAY)
    peak_qps = 2 * read_qps
    write_qps = chia_lam_tron(dau * w, GIAY_MOI_NGAY)
    byte_moi_ngay = dau * w * s
    gb_x10 = chia_lam_tron(byte_moi_ngay, 10**8)          # GB/ngày, giữ 1 chữ số thập phân
    tb_x1000 = chia_lam_tron(byte_moi_ngay * 365, 10**9)  # TB/năm, giữ 3 chữ số thập phân
    return (f"Read QPS = {read_qps}, Peak QPS = {peak_qps}, Write QPS = {write_qps}, "
            f"Storage = {gb_x10 // 10}.{gb_x10 % 10} GB/day = {tb_x1000 // 1000}.{tb_x1000 % 1000:03d} TB/year")


def main() -> None:
    data = sys.stdin.read().split()
    if not data:
        kich_ban = [(10_000_000, 20, 2, 500)]
    else:
        q = int(data[0])
        so = [int(x) for x in data[1:1 + 4 * q]]
        kich_ban = [tuple(so[4 * i:4 * i + 4]) for i in range(q)]
    for dau, r, w, s in kich_ban:
        print(uoc_luong(dau, r, w, s))


if __name__ == "__main__":
    main()
// Ước lượng tải kiểu Back-of-the-Envelope cho nhiều kịch bản (bảng "Ví dụ chạy tay" của bài).
// Đầu vào: số kịch bản q, rồi q dòng "DAU R W S". Không có đầu vào thì chạy kịch bản của bảng: 10000000 20 2 500.
// Mọi phép tính làm bằng số nguyên 64-bit (long): DAU * W * S = 10^10 byte của kịch bản trong bài đã vượt 2^31.
// Phép chia làm tròn tới số gần nhất (nửa lên).
// Giới hạn để không tràn long: DAU <= 10^9, R và W <= 1000, S <= 10^4 byte.
import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;
import java.util.Locale;

public class Main {
    static final long GIAY_MOI_NGAY = 86400;

    static long chiaLamTron(long a, long b) {  // a / b làm tròn tới số nguyên gần nhất (a >= 0, b chẵn)
        return (a + b / 2) / b;
    }

    static String uocLuong(long dau, long r, long w, long s) {
        long readQps = chiaLamTron(dau * r, GIAY_MOI_NGAY);
        long peakQps = 2 * readQps;
        long writeQps = chiaLamTron(dau * w, GIAY_MOI_NGAY);
        long byteMoiNgay = dau * w * s;
        long gbX10 = chiaLamTron(byteMoiNgay, 100_000_000L);          // GB/ngày, 1 chữ số thập phân
        long tbX1000 = chiaLamTron(byteMoiNgay * 365, 1_000_000_000L);  // TB/năm, 3 chữ số thập phân
        return String.format(Locale.ROOT,
                "Read QPS = %d, Peak QPS = %d, Write QPS = %d, Storage = %d.%d GB/day = %d.%03d TB/year",
                readQps, peakQps, writeQps, gbX10 / 10, gbX10 % 10, tbX1000 / 1000, tbX1000 % 1000);
    }

    public static void main(String[] args) throws IOException {
        String vao = new String(System.in.readAllBytes(), StandardCharsets.UTF_8).trim();
        List<long[]> kichBan = new ArrayList<>();
        if (vao.isEmpty()) {
            kichBan.add(new long[]{10_000_000L, 20, 2, 500});
        } else {
            String[] tk = vao.split("\\s+");
            int q = Integer.parseInt(tk[0]);
            for (int i = 0; i < q; i++) {
                long[] k = new long[4];
                for (int j = 0; j < 4; j++) k[j] = Long.parseLong(tk[1 + 4 * i + j]);
                kichBan.add(k);
            }
        }
        StringBuilder sb = new StringBuilder();
        for (long[] k : kichBan) sb.append(uocLuong(k[0], k[1], k[2], k[3])).append('\n');
        System.out.print(sb);
    }
}
4 mảnh ghép kiến trúc giải quyết các điểm nghẽn kinh điển
Khi lượng truy cập tăng gấp \(10\) hoặc \(100\) lần, hệ thống một máy chủ sẽ sập. Dưới đây là 4 công cụ chuẩn để bạn mở rộng theo chiều ngang (Horizontal Scaling):
1. Bộ cân bằng tải (Load Balancer) và Tầng Web không trạng thái (Stateless)
Để có thể nhân bản từ 1 máy chủ API lên 20 máy chủ API chỉ trong vài phút, bản thân tầng ứng dụng phải không lưu trạng thái phiên làm việc trong RAM cục bộ (Stateless). Mọi thông tin đăng nhập được xác thực qua mã thông báo JWT hoặc lưu tập trung trên cụm Redis. Đứng phía trước là Load Balancer (ở tầng L4 TCP hoặc tầng L7 HTTP như NGINX, Envoy, AWS ALB) phân phối lưu lượng theo thuật toán Round Robin hoặc Least Connections, đồng thời tự động ngắt kết nối tới máy chủ bị lỗi (Health Check).
2. Chiến lược Bộ nhớ đệm (Caching Strategy)
Với các hệ thống có tỷ lệ đọc gấp 10–100 lần ghi, đặt một tầng bộ nhớ đệm như Redis hoặc Memcached trước cơ sở dữ liệu giúp giảm \(80\% - 95\%\) tải truy vấn xuống đĩa cứng. Mô hình phổ biến nhất là Cache-Aside (Lazy Loading):
- Ứng dụng kiểm tra khóa trên Redis trước (tương tự thao tác tra cứu \(\mathcal{O}(1)\) trên bảng băm (Hash Table)).
- Nếu có (Cache Hit), trả dữ liệu ngay trong \(\approx 1\text{ ms}\).
- Nếu không có (Cache Miss), ứng dụng đọc từ Database, ghi ngược bản sao vào Redis kèm thời gian sống (TTL — Time To Live) rồi trả kết quả cho người dùng. Khi dữ liệu gốc thay đổi, ưu tiên xóa khóa trên Cache (Invalidate) thay vì cập nhật đè để tránh tranh chấp thứ tự ghi giữa hai luồng.
3. Nhân bản (Replication) và Phân mảnh (Sharding) Cơ sở dữ liệu
- Master-Slave (Primary-Replica) Replication: Mọi thao tác ghi (
INSERT,UPDATE,DELETE) đi vào nút Primary; dữ liệu được đồng bộ sang các nút Read Replicas để phục vụ riêng các truy vấn đọc (SELECT). - Database Sharding (Phân mảnh ngang): Khi lượng ghi vượt quá sức chịu đựng của 1 nút Primary (ví dụ \(\gt 10{,}000\text{ Write QPS}\)) hoặc bảng dữ liệu phình lên hàng chục Terabyte làm chỉ mục B-Tree không còn nằm vừa trong RAM, ta chia bảng thành nhiều phân mảnh độc lập dựa trên Khóa phân mảnh (Shard Key) như
user_id % Nhoặc dùng Băm nhất quán (Consistent Hashing) để khi thêm/bớt máy chủ chỉ cần di chuyển \(\frac{1}{N}\) lượng dữ liệu.
4. Hàng đợi tin nhắn bất đồng bộ (Message Queue)
Những tác vụ tốn thời gian nhưng người dùng không cần kết quả ngay trong cùng một chu kỳ HTTP — như gửi email xác nhận, nén video nhiều độ phân giải, hay cộng dồn thống kê lượt xem — cần được tách khỏi luồng chính bằng hàng đợi Kafka hoặc RabbitMQ. Máy chủ API chỉ việc đẩy một sự kiện vào hàng đợi rồi trả về 202 Accepted ngay lập tức, giúp độ trễ phản hồi giữ vững ở mức vài chục mili-giây ngay cả trong giờ cao điểm.
Luyện ngay trên Big-O Coding
Nhiều thuật toán lõi bên trong các hệ thống phân tán — từ tra cứu phân đoạn chỉ mục đến tính thời gian lan truyền bản tin giữa các nút mạng — đều bắt nguồn từ những cấu trúc dữ liệu nền tảng; hãy thực hành ngay 2 bài toán cốt lõi dưới đây trên Big-O Coding:
Sinh viên mới ra trường (Fresher / New Grad) có bị hỏi System Design khi phỏng vấn không?
Ở các tập đoàn lớn như Google hay Meta, vị trí mới ra trường (L3 ở Google, E3 ở Meta) chủ yếu tập trung vào 3–4 vòng thuật toán và cấu trúc dữ liệu. Tuy nhiên, rất nhiều công ty công nghệ tầm trung, các kỳ lân (Unicorn) tại Đông Nam Á và các đội sản phẩm trong nước vẫn dành 15–20 phút hỏi thiết kế hệ thống ở mức độ thực hành (như thiết kế lược đồ cơ sở dữ liệu, cách đặt chỉ mục SQL, cơ chế hoạt động của Redis Cache hoặc xử lý đồng thời khi đặt hàng). Nắm vững khung 4 bước trong bài viết này sẽ giúp bạn tạo ấn tượng vượt trội so với mặt bằng ứng viên mới ra trường.
Khi nào nên chọn Cơ sở dữ liệu Quan hệ (SQL) và khi nào nên chọn NoSQL?
Hãy bắt đầu với SQL (PostgreSQL, MySQL) làm lựa chọn mặc định khi dữ liệu có cấu trúc rõ ràng, cần mối quan hệ giữa nhiều thực thể và đòi hỏi giao dịch nguyên tử ACID (như đơn hàng, ví điện tử, quản lý tài khoản). Chỉ chuyển sang hoặc kết hợp NoSQL khi bài toán có đặc thù rõ rệt: cần thông lượng ghi cực lớn với truy vấn đơn giản theo khóa phân vùng (như lịch sử tin nhắn chat trên Cassandra/DynamoDB), hoặc cấu trúc tài liệu linh hoạt thay đổi liên tục (MongoDB).
Làm sao xử lý hiện tượng "Cache Stampede" khi một khóa cực nóng trên Redis vừa hết hạn TTL?
Khi một khóa đang nhận hàng nghìn truy vấn mỗi giây (ví dụ trang chủ sự kiện Flash Sale) đột ngột hết hạn TTL, hàng nghìn luồng sẽ cùng lúc bị Cache Miss và ập thẳng xuống cơ sở dữ liệu gây sập DB. Ba cách khắc phục phổ biến nhất là: sử dụng Khóa phân tán (Distributed Mutex / Singleflight) để chỉ cho phép đúng 1 luồng xuống DB lấy dữ liệu nạp lại Cache trong khi các luồng khác chờ; cộng thêm một độ lệch ngẫu nhiên (Jitter) vào thời gian TTL; hoặc dùng chiến lược làm mới chủ động ngầm trước khi khóa hết hạn (Logical Expiration).
Luyện LeetCode thực chiến theo pattern, giải bài trong 45 phút và mock interview cùng AI. 16 buổi online, lớp 7–12 học viên, chọn C++, Java hoặc Python.