- Danh sách chia năm nhóm theo thứ tự học: khóa học, tự xây từ đầu, thư viện nền, chạy mô hình ngôn ngữ lớn, ứng dụng.
- Số sao, năm tạo và giấy phép lấy từ API GitHub ngày 11/11/2026. Số sao đổi mỗi ngày; năm tạo cho biết kho đã tồn tại bao lâu, còn ngày cập nhật cho biết kho còn sống không.
- Không cần học cả 20 kho. Chọn một kho ở nhóm khóa học, một kho tự xây, rồi một thư viện nền là đủ cho năm đầu.
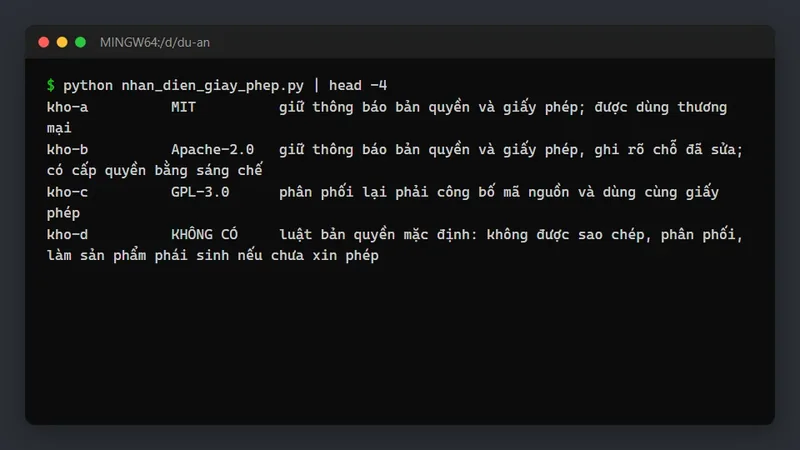
- Đọc giấy phép trước khi dùng code: phần lớn là MIT, Apache 2.0 hay BSD, nhưng có kho dùng AGPL hoặc giấy phép riêng.
Số liệu trong bài lấy bằng API công khai của GitHub (GET /repos/{chủ}/{tên}) ngày 11/11/2026, và mô tả của từng kho tóm tắt từ trang kho cùng ngày. "Năm" là năm kho được tạo trên GitHub, không phải năm ra đời của dự án hay bài báo gốc. Danh sách thiên về kho có tài liệu tốt cho người học, không phải xếp hạng theo sao.
Cách chọn 20 kho
Mỗi kho phải qua bốn điều kiện: có tài liệu hoặc ví dụ đủ để người mới chạy được, có giấy phép rõ (hoặc có tệp LICENSE để đọc), có người dùng đông, và hữu ích cho một giai đoạn học cụ thể. Một kho đã ngừng cập nhật vẫn được giữ nếu nội dung còn giá trị học, nhưng có ghi chú rõ. Cách tự tìm thêm kho theo bộ lọc nằm trong bài tìm repo AI hay.
Bảng tổng hợp
| Kho | Nhóm | Năm tạo | Sao | Giấy phép |
|---|---|---|---|---|
| microsoft/ML-For-Beginners | Khóa học | 2021 | 92.111 | MIT |
| microsoft/AI-For-Beginners | Khóa học | 2021 | 70.707 | MIT |
| microsoft/generative-ai-for-beginners | Khóa học | 2023 | 123.322 | MIT |
| d2l-ai/d2l-en | Khóa học | 2018 | 30.025 | NOASSERTION |
| karpathy/micrograd | Tự xây | 2020 | 18.818 | MIT |
| karpathy/nanoGPT | Tự xây | 2022 | 64.614 | MIT |
| karpathy/nanochat | Tự xây | 2025 | 60.433 | MIT |
| rasbt/LLMs-from-scratch | Tự xây | 2023 | 108.206 | NOASSERTION |
| scikit-learn/scikit-learn | Thư viện | 2010 | 68.139 | BSD-3-Clause |
| pytorch/pytorch | Thư viện | 2016 | 105.332 | NOASSERTION |
| tensorflow/tensorflow | Thư viện | 2015 | 201.446 | Apache-2.0 |
| keras-team/keras | Thư viện | 2015 | 64.421 | Apache-2.0 |
| huggingface/transformers | LLM | 2018 | 168.755 | Apache-2.0 |
| ollama/ollama | LLM | 2023 | 186.586 | MIT |
| ggml-org/llama.cpp | LLM | 2023 | 133.972 | MIT |
| vllm-project/vllm | LLM | 2023 | 96.694 | Apache-2.0 |
| langchain-ai/langchain | Ứng dụng | 2022 | 149.332 | MIT |
| openai/whisper | Ứng dụng | 2022 | 112.377 | MIT |
| ultralytics/ultralytics | Ứng dụng | 2022 | 63.284 | AGPL-3.0 |
| opencv/opencv | Ứng dụng | 2012 | 91.523 | Apache-2.0 |
NOASSERTION nghĩa là GitHub không khớp được tệp giấy phép của kho với một mẫu chuẩn. Với ba kho như vậy trong bảng, hãy mở tệp LICENSE đọc trực tiếp trước khi dùng code.
Nhóm 1: khóa học cho người mới
microsoft/ML-For-Beginners (2021). Chương trình học máy cổ điển: theo mô tả của kho là 12 tuần, 26 bài, 52 bài trắc nghiệm. Hợp với người đã biết Python cơ bản và muốn hiểu hồi quy, phân loại, phân cụm trước khi sang học sâu.
microsoft/AI-For-Beginners (2021). 12 tuần, 24 bài, đi rộng hơn: từ AI biểu tượng tới mạng nơ-ron, thị giác máy tính và xử lý ngôn ngữ.
microsoft/generative-ai-for-beginners (2023). 21 bài về xây ứng dụng AI tạo sinh: viết lời nhắc, gọi API mô hình, tìm kiếm theo ngữ nghĩa, agent.
d2l-ai/d2l-en (2018). Sách học sâu tương tác "Dive into Deep Learning", có code cho nhiều framework, kèm toán và thảo luận. Lưu ý: lần đẩy code gần nhất là ngày 18/08/2024, nên một số phiên bản thư viện trong sách có thể đã cũ. Nội dung lý thuyết vẫn rất đáng đọc.
Nhóm 2: tự xây mô hình từ đầu
karpathy/micrograd (2020). Một bộ máy tính đạo hàm tự động rất nhỏ cùng thư viện mạng nơ-ron bên trên, viết theo kiểu API giống PyTorch. Đọc xong vài trăm dòng code, bạn hiểu lan truyền ngược hoạt động thế nào.
karpathy/nanoGPT (2022). Kho ngắn gọn để huấn luyện và tinh chỉnh mô hình GPT cỡ vừa. README có ghi chú cập nhật tháng 11/2025 nói kho đã cũ và không còn được phát triển, chỉ giữ lại để tham khảo, và chỉ người đọc sang nanochat. Vẫn đáng đọc để hiểu cấu trúc GPT, nhưng đừng chọn làm nền cho dự án mới.
karpathy/nanochat (2025). Kho kế tiếp nanoGPT: dựng trọn một chatbot nhỏ từ huấn luyện tới giao diện trò chuyện, với chi phí tính toán thấp theo mô tả của tác giả.
rasbt/LLMs-from-scratch (2023). Code đi kèm sách "Build a Large Language Model (From Scratch)" của Sebastian Raschka (Manning, 2024): tự viết một mô hình kiểu GPT bằng PyTorch từng bước, từ tách từ, cơ chế chú ý, tới huấn luyện trước và tinh chỉnh.
Nhóm 3: thư viện nền
scikit-learn/scikit-learn (2010). Thư viện học máy cổ điển của Python: hồi quy, cây quyết định, SVM, phân cụm, đánh giá mô hình. Là kho lâu đời nhất trong danh sách và vẫn được cập nhật hằng ngày.
pytorch/pytorch (2016). Framework học sâu phổ biến trong nghiên cứu, tính toán tensor có tăng tốc GPU. API trả NOASSERTION; tệp LICENSE của PyTorch là giấy phép kiểu BSD, hãy mở ra đọc.
tensorflow/tensorflow (2015). Framework học máy của Google, kho có nhiều sao nhất trong danh sách (201.446 sao ngày 11/11/2026).
keras-team/keras (2015). API học sâu cấp cao, khẩu hiệu "Deep Learning for humans". Keras 3 chạy được trên nhiều backend như JAX, TensorFlow và PyTorch.
Nhóm 4: mô hình ngôn ngữ lớn
huggingface/transformers (2018). Thư viện định nghĩa mô hình cho văn bản, hình ảnh, âm thanh và đa phương thức, dùng cho cả suy luận lẫn huấn luyện. Thường đi cùng kho mô hình trên Hugging Face; xem Hugging Face là gì.
ollama/ollama (2023). Chạy các mô hình mở trên máy của bạn bằng vài lệnh. Cách nhanh nhất để thử một mô hình ngôn ngữ cục bộ.
ggml-org/llama.cpp (2023). Suy luận mô hình ngôn ngữ lớn bằng C/C++, chạy được trên máy không có GPU mạnh. Nhiều công cụ chạy mô hình cục bộ dựa trên nó.
vllm-project/vllm (2023). Bộ máy phục vụ mô hình ngôn ngữ lớn với thông lượng cao và tiết kiệm bộ nhớ, dùng khi cần phục vụ nhiều người cùng lúc.
Nhóm 5: ứng dụng
langchain-ai/langchain (2022). Khung để xây ứng dụng và agent dùng mô hình ngôn ngữ, kết nối mô hình với công cụ và dữ liệu.
openai/whisper (2022). Mô hình nhận dạng giọng nói, hỗ trợ nhiều ngôn ngữ trong đó có tiếng Việt. Code và trọng số mô hình đều công bố với giấy phép MIT.
ultralytics/ultralytics (2022). Bộ YOLO cho phát hiện vật thể, phân đoạn, phân loại ảnh, ước lượng tư thế. Giấy phép là AGPL-3.0: nếu bạn đưa phần mềm dùng kho này cho người khác dùng, kể cả qua mạng, phải công bố mã nguồn theo cùng giấy phép. Đọc kỹ trước khi dùng cho sản phẩm; xem đọc README và LICENSE.
opencv/opencv (2012). Thư viện thị giác máy tính kinh điển: đọc ảnh, video, xử lý ảnh, nhận diện. Dù bạn dùng mô hình học sâu nào, xử lý ảnh đầu vào thường vẫn cần OpenCV.
Tự cập nhật bảng bằng Python
Số sao trong bài sẽ cũ đi theo thời gian. Đoạn code dưới đây lập lại bảng cho danh sách kho bạn chọn: gọi API công khai của GitHub cho từng kho, lấy năm tạo, số sao, giấy phép và ngày cập nhật gần nhất, sắp theo số sao và ghi chú những kho hơn một năm chưa cập nhật hoặc đã lưu trữ. Dòng đầu bảng luôn ghi ngày xem. Chạy không tham số thì dùng ba kho mẫu với số liệu chụp ngày 11/11/2026; chạy python bang_repo.py --that karpathy/micrograd scikit-learn/scikit-learn để lấy số mới.
"""Lập bảng các kho GitHub: năm tạo, số sao, giấy phép, lần cập nhật gần nhất, kèm ngày xem.

Dùng API công khai của GitHub: GET https://api.github.com/repos/{chủ}/{tên} (không cần khóa; không đăng nhập
thì được khoảng 60 yêu cầu mỗi giờ). Chạy không tham số: lập bảng từ dữ liệu mẫu, không cần mạng.
Chạy với --that chu/ten chu/ten ...: gọi API thật.
"""
import json
import sys
import urllib.request
from datetime import date


def tom_tat(d, hom_nay):
    """Rút các trường cần thiết từ phản hồi API của một kho."""
    ngay_day = date.fromisoformat(d["pushed_at"][:10])
    return {
        "ten": d["full_name"],
        "nam": int(d["created_at"][:4]),
        "sao": d["stargazers_count"],
        "giay_phep": (d.get("license") or {}).get("spdx_id") or "không có",
        "cap_nhat": ngay_day.isoformat(),
        "lau_chua_cap_nhat": (hom_nay - ngay_day).days > 365,
        "luu_tru": d.get("archived", False),
    }


def so_viet(n):
    return f"{n:,}".replace(",", ".")


def bang_markdown(cac_kho, hom_nay):
    dong = [f"Số liệu xem ngày {hom_nay.strftime('%d/%m/%Y')}", "",
            "| Kho | Năm tạo | Sao | Giấy phép | Cập nhật gần nhất |", "|---|---|---|---|---|"]
    for k in sorted(cac_kho, key=lambda k: -k["sao"]):
        ghi_chu = " (lưu trữ)" if k["luu_tru"] else (" (hơn 1 năm)" if k["lau_chua_cap_nhat"] else "")
        dong.append(f"| {k['ten']} | {k['nam']} | {so_viet(k['sao'])} | {k['giay_phep']} | {k['cap_nhat']}{ghi_chu} |")
    return "\n".join(dong)


MAU = [  # ba kho thật, số liệu chụp lại từ API ngày 11/11/2026
    {"full_name": "karpathy/micrograd", "created_at": "2020-04-13T00:00:00Z", "stargazers_count": 18818,
     "license": {"spdx_id": "MIT"}, "pushed_at": "2026-08-03T00:00:00Z", "archived": False},
    {"full_name": "scikit-learn/scikit-learn", "created_at": "2010-08-17T00:00:00Z", "stargazers_count": 68139,
     "license": {"spdx_id": "BSD-3-Clause"}, "pushed_at": "2026-11-11T00:00:00Z", "archived": False},
    {"full_name": "d2l-ai/d2l-en", "created_at": "2018-10-09T00:00:00Z", "stargazers_count": 30025,
     "license": {"spdx_id": "NOASSERTION"}, "pushed_at": "2024-08-18T00:00:00Z", "archived": False},
]


def chay_thu():
    hom_nay = date(2026, 11, 11)
    bang = bang_markdown([tom_tat(d, hom_nay) for d in MAU], hom_nay)
    print(bang)
    return bang


def lay_that(ten_kho):
    yeu_cau = urllib.request.Request("https://api.github.com/repos/" + ten_kho,
                                     headers={"Accept": "application/vnd.github+json"})
    with urllib.request.urlopen(yeu_cau, timeout=20) as phan_hoi:
        return json.load(phan_hoi)


if __name__ == "__main__":
    if len(sys.argv) > 2 and sys.argv[1] == "--that":
        hom_nay = date.today()
        print(bang_markdown([tom_tat(lay_that(t), hom_nay) for t in sys.argv[2:]], hom_nay))
    else:
        chay_thu()
Với dữ liệu mẫu, d2l-ai/d2l-en được đánh dấu "hơn 1 năm" vì lần cập nhật gần nhất là tháng 8/2024. Không đăng nhập, API cho khoảng 60 yêu cầu mỗi giờ, đủ cho bảng 20 kho.
Học theo thứ tự nào
Một lộ trình gợi ý cho người mới biết Python:
- Một kho ở nhóm khóa học, ví dụ ML-For-Beginners, song song với scikit-learn.
- micrograd để hiểu lan truyền ngược, rồi PyTorch.
- LLMs-from-scratch hoặc nanochat để hiểu mô hình ngôn ngữ từ bên trong.
- transformers và ollama để dùng mô hình có sẵn.
- Chọn một hướng ứng dụng (giọng nói, thị giác, agent) và làm một dự án nhỏ, đưa lên GitHub làm hồ sơ.
Mỗi bước, chạy được ví dụ nhỏ trước theo bài chạy dự án AI từ GitHub, rồi mới đọc sâu vào code.
- Gắn sao cả 20 kho rồi không chạy kho nào.
- Chọn nanoGPT làm nền dự án mới dù README đã ghi kho không còn phát triển.
- Dùng code AGPL trong sản phẩm mà không đọc điều kiện của giấy phép.
- Chép số sao từ bài viết cũ mà không ghi ngày xem.
- Nhảy thẳng vào kho phục vụ mô hình như vLLM khi chưa hiểu mô hình hoạt động thế nào.
Câu hỏi thường gặp
Vì sao không xếp hạng theo số sao?
Số sao đo độ chú ý, không đo mức phù hợp cho người học. Bảng có số sao để tham khảo, nhưng thứ tự trong bài theo lộ trình học.
Năm trong bảng là năm gì?
Là năm kho được tạo trên GitHub. Một số dự án có lịch sử dài hơn (ví dụ OpenCV có từ trước khi lên GitHub), nên năm tạo kho có thể muộn hơn năm dự án ra đời.
Máy yếu có học được các kho này không?
Nhóm khóa học, micrograd và scikit-learn chạy tốt trên máy thường. Kho huấn luyện mô hình lớn cần GPU; có thể dùng dịch vụ notebook trên mây hoặc phiên bản nhỏ của mô hình.
Có kho nào bằng tiếng Việt không?
Một số kho khóa học có bản dịch do cộng đồng đóng góp; xem thư mục dịch trong từng kho. Code và tài liệu gốc chủ yếu bằng tiếng Anh.
Học tiếp
- Tự tìm thêm kho bằng bộ lọc tìm kiếm: tìm repo AI hay.
- Kiểm giấy phép trước khi dùng code: đọc README và LICENSE.
- Cài và chạy kho đã chọn: chạy dự án AI từ GitHub.
- Xem lại toàn bộ chủ đề: GitHub cho người học AI.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.