- Triết lý sức mạnh đám đông: Kết hợp dự đoán của hàng trăm cây quyết định riêng lẻ luôn cho độ chính xác và tính ổn định vượt trội hơn bất kỳ cây đơn lẻ nào.
- Kỹ thuật Bagging (Bootstrap Aggregating): Mỗi cây được huấn luyện trên một tập dữ liệu con được tạo ra bằng cách lấy mẫu có hoàn lại từ tập dữ liệu gốc.
- Ngẫu nhiên hóa đặc trưng: Tại mỗi nút phân nhánh, chỉ một tập con ngẫu nhiên gồm \(m \approx \sqrt{D}\) đặc trưng được xem xét, giúp triệt tiêu sự tương quan giữa các cây.
- Đánh giá Out-of-Bag (OOB): Tự động đánh giá hiệu năng mô hình trên ~36.8% mẫu dữ liệu không được chọn vào bootstrap mà không cần tập kiểm định riêng.
Random Forest và Triết lý Ensemble Learning
Trong ngạn ngữ có câu: "Một cây làm chẳng nên non, ba cây chụm lại nên hòn núi cao". Đây chính là tư tưởng cốt lõi của Ensemble Learning (Học kết hợp) trong học máy. Thay vì cố gắng tìm kiếm một mô hình đơn lẻ hoàn hảo, ta xây dựng một tập hợp nhiều mô hình cơ sở (Base Learners) và kết hợp các dự đoán của chúng lại với nhau để đạt được kết quả vượt trội.
Một cây quyết định đơn lẻ (Decision Tree) có nhược điểm chí mạng là phương sai rất cao (High Variance): cây rất dễ bị quá khớp với dữ liệu huấn luyện và cực kỳ nhạy cảm với nhiễu. Random Forest (Rừng ngẫu nhiên), do nhà thống kê học Leo Breiman đề xuất năm 2001, đã khắc phục hoàn toàn nhược điểm này bằng cách kết hợp hàng trăm cây quyết định độc lập theo cơ chế biểu quyết dân chủ.
Trong thực tế công nghiệp, Random Forest là một trong những thuật toán được tin dùng nhiều nhất. Nó hoạt động xuất sắc mà không đòi hỏi nhiều công sức tinh chỉnh siêu tham số phức tạp, có khả năng xử lý tốt tập dữ liệu có hàng ngàn đặc trưng, và hiếm khi bị quá khớp ngay cả khi dữ liệu có nhiều biến động bất thường.
Hai trụ cột của Random Forest
Để việc kết hợp nhiều cây đạt hiệu quả cao nhất, các cây trong rừng phải càng độc lập và ít tương quan với nhau càng tốt. Nếu tất cả các cây đều mắc cùng một lỗi giống nhau, việc biểu quyết sẽ hoàn toàn vô nghĩa. Random Forest đạt được sự đa dạng này nhờ hai cơ chế ngẫu nhiên hóa tinh tế:
1. Kỹ thuật Bootstrap Aggregating (Bagging)
Giả sử tập dữ liệu huấn luyện gốc có \(N\) mẫu. Đối với mỗi cây thứ \(b \in \{1, \dots, B\}\) trong rừng:
- Ta lấy mẫu ngẫu nhiên \(N\) lần có hoàn lại (with replacement) từ tập dữ liệu gốc.
- Do lấy mẫu có hoàn lại, một số mẫu sẽ xuất hiện nhiều lần trong tập con, trong khi một số mẫu khác sẽ không bao giờ được chọn.
- Xác suất một mẫu cụ thể không được chọn trong bất kỳ lần bốc thăm nào là:
\[\lim_{N \to \infty} \left( 1 - \frac{1}{N} \right)^N = \frac{1}{e} \approx 0.368 = 36.8\%\]
Khoảng 36.8% mẫu bị bỏ sót này được gọi là tập dữ liệu Out-of-Bag (OOB), đóng vai trò như một tập kiểm thử tự nhiên để đánh giá mô hình mà không cần chia tập train/validation. Nhờ đó, chúng ta có thể ước lượng độ chính xác tổng quát hóa của toàn bộ khu rừng hoàn toàn miễn phí mà không làm hao hụt dữ liệu huấn luyện quý giá.
2. Ngẫu nhiên hóa không gian đặc trưng (Feature Subsampling)
Nếu một vài đặc trưng trong dữ liệu có tính quyết định quá mạnh (ví dụ đặc trưng \(x_1\)), hầu hết các cây trong Bagging thông thường đều sẽ chọn \(x_1\) làm nút gốc, khiến các cây trở nên tương quan chặt chẽ với nhau.
Random Forest ngăn chặn điều này bằng quy tắc: tại mỗi nút phân nhánh của mỗi cây:
- Thuật toán không duyệt qua toàn bộ \(D\) đặc trưng.
- Thay vào đó, nó chọn ngẫu nhiên một tập con gồm \(m\) đặc trưng (thông thường \(m = \lfloor \sqrt{D} \rfloor\) cho bài toán phân loại và \(m = \lfloor D/3 \rfloor\) cho bài toán hồi quy).
- Cây chỉ được phép chọn ngưỡng cắt tối ưu trong số \(m\) đặc trưng này.
Quy tắc này buộc các cây phải khám phá và học các đặc trưng tiềm năng khác, tạo ra sự đa dạng tối đa trong toàn bộ khu rừng.
Cơ chế tổng hợp dự đoán (Aggregating)
Khi cần dự đoán nhãn cho một mẫu dữ liệu mới \(x\):
- Bài toán phân loại: Mỗi cây trong rừng sẽ bỏ một phiếu cho một nhãn lớp. Kết quả cuối cùng là nhãn nhận được đa số phiếu bầu (Majority Voting):
\[\hat{y} = \arg\max_k \sum_{b=1}^B \mathbb{I}(\hat{y}_b(x) = k)\]
- Bài toán hồi quy: Lấy trung bình cộng dự đoán của toàn bộ \(B\) cây:
\[\hat{y} = \frac{1}{B} \sum_{b=1}^B \hat{y}_b(x)\]
Về mặt toán học, nếu mỗi cây có phương sai là \(\sigma^2\) và hệ số tương quan giữa hai cây bất kỳ là \(\rho\), phương sai của mô hình kết hợp \(B\) cây là:
\[\text{Var}(\text{Ensemble}) = \rho \sigma^2 + \frac{1 - \rho}{B} \sigma^2\]
Khi số lượng cây \(B\) tăng lên lớn, số hạng thứ hai \(\frac{1 - \rho}{B} \sigma^2 \to 0\). Đồng thời, cơ chế chọn đặc trưng ngẫu nhiên làm giảm hệ số tương quan \(\rho\) xuống mức rất nhỏ. Kết quả là phương sai của Random Forest thấp hơn rất nhiều lần so với một cây đơn lẻ! Mô hình vừa giữ được độ chệch thấp của các cây sâu, vừa có phương sai cực thấp của bộ kết hợp.
Đánh giá Out-Of-Bag (OOB Error) và Kiểm định mô hình
Hai ưu điểm độc nhất giúp Random Forest trở thành công cụ phân tích dữ liệu hàng đầu là khả năng tự kiểm định không cần tập validation riêng và tính toán độ quan trọng của các đặc trưng:
- Đánh giá Out-Of-Bag (OOB): Khi áp dụng kỹ thuật Bootstrap lấy mẫu có hoàn lại, xác suất một quan sát bất kỳ không được chọn vào tập huấn luyện của một cây cụ thể xấp xỉ \((1 - 1/N)^N \approx 1/e \approx 36.8\%\). Những mẫu này được gọi là mẫu Out-Of-Bag (OOB). Mô hình có thể dùng ngay các mẫu OOB này để đo lường sai số dự đoán trung bình mà không cần trích riêng một tập validation, tiết kiệm tài nguyên dữ liệu quý giá.
- Tính toán trực tiếp trong quá trình huấn luyện: Với mỗi mẫu, chỉ gộp phiếu của những cây không có mẫu đó trong tập bootstrap của mình (bộ phân loại out-of-bag); tỷ lệ lỗi của bộ phân loại này trên toàn tập huấn luyện là ước lượng OOB, phản ánh khá sát sai số trên một tập kiểm thử độc lập.
Chủ đề này nằm trong Lecture 13 - Hyperparameter Tuning & Ensemble Methods của Khóa AI. Xem đề cương
Cài đặt mô phỏng thuật toán
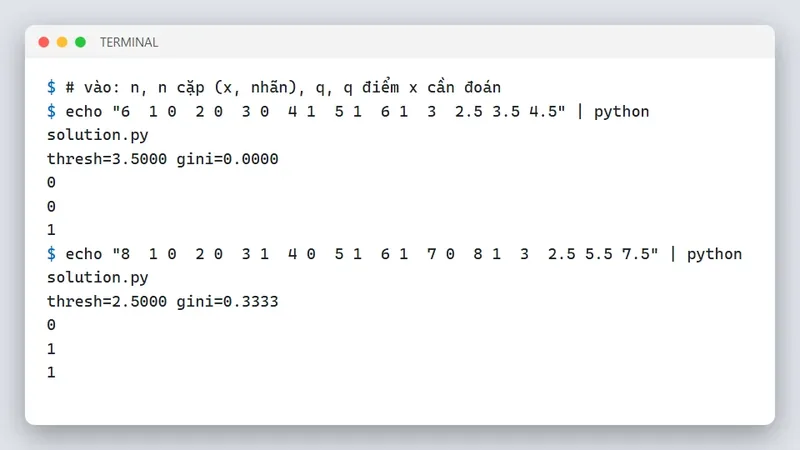
Dưới đây là mã nguồn cài đặt rút gọn bằng Python và C++17: Bagging các cây một tầng (stump) trên dữ liệu một đặc trưng, minh họa quy trình tạo các cây con trên tập mẫu bootstrap và tổng hợp kết quả bằng biểu quyết đa số. Vì dữ liệu chỉ có một đặc trưng nên code chưa có bước chọn ngẫu nhiên đặc trưng ở mỗi nút của Random Forest.
# Random Forest rut gon: moi cay la mot cay mot tang (stump) hoc tren mot mau
# bootstrap boc CO HOAN LAI tu du lieu goc, roi cac cay bo phieu da so
import sys

def gini(labels):
    if not labels: return 0.0
    n = len(labels)
    c0 = sum(1 for y in labels if y == 0)
    c1 = n - c0
    p0 = c0 / n
    p1 = c1 / n
    return 1.0 - (p0 * p0 + p1 * p1)

def fit_stump(pts):
    pts = sorted(pts, key=lambda p: p[0])
    n = len(pts)
    best_g = 1e9
    best_t = pts[0][0]
    best_l, best_r = 0, 0
    for i in range(n - 1):
        if pts[i][0] == pts[i+1][0]: continue
        thresh = (pts[i][0] + pts[i+1][0]) / 2.0
        left = [p[1] for p in pts if p[0] <= thresh]
        right = [p[1] for p in pts if p[0] > thresh]
        g = (len(left) * gini(left) + len(right) * gini(right)) / n
        if g < best_g:
            best_g = g
            best_t = thresh
            best_l = 1 if sum(left) * 2 >= len(left) else 0
            best_r = 1 if sum(right) * 2 >= len(right) else 0
    return best_t, best_l, best_r

def main():
    data = sys.stdin.read().split()
    if not data: return
    it = iter(data)
    n = int(next(it))
    num_trees = int(next(it))
    pts = []
    for _ in range(n):
        x = float(next(it))
        y = int(next(it))
        pts.append((x, y))

    trees = []
    for b in range(num_trees):
        # Bootstrap: boc n lan CO HOAN LAI (mot diem co the bi boc nhieu lan,
        # diem khac khong duoc boc). Dung bo sinh so gia ngau nhien LCG cung
        # cong thuc voi ban C++ de hai ban cho cung ket qua.
        state = 12345 + b
        sub_pts = []
        for _ in range(n):
            state = (1103515245 * state + 12345) % 2147483648
            # Lay bit cao (state >> 16): bit thap cua LCG mod 2^31 lap chu ky ngan, nen state % n voi
            # n = 2^k chi cho mot hoan vi cua n diem (khong diem nao bi boc 2 lan).
            sub_pts.append(pts[(state >> 16) % n])
        trees.append(fit_stump(sub_pts))

    q = int(next(it))
    q_xs = [float(next(it)) for _ in range(q)]

    print(f"trees={num_trees}")
    for b, (t, l, r) in enumerate(trees, 1):
        print(f"cay {b}: nguong={t:.4f} trai={l} phai={r}")
    for qx in q_xs:
        votes = [l if qx <= t else r for t, l, r in trees]
        pred = 1 if sum(votes) * 2 >= len(votes) else 0
        print(f"{pred}")

if __name__ == "__main__":
    main()
#include <iostream>
#include <vector>
#include <algorithm>
#include <iomanip>

using namespace std;

struct Point {
    double x;
    int y;
};

double gini(const vector<int>& labels) {
    if (labels.empty()) return 0.0;
    int n = labels.size();
    int c0 = 0;
    for (int y : labels) if (y == 0) c0++;
    int c1 = n - c0;
    double p0 = (double)c0 / n;
    double p1 = (double)c1 / n;
    return 1.0 - (p0 * p0 + p1 * p1);
}

void fit_stump(vector<Point> pts, double &best_t, int &best_l, int &best_r) {
    sort(pts.begin(), pts.end(), [](const Point& a, const Point& b) { return a.x < b.x; });
    int n = pts.size();
    double best_g = 1e9;
    best_t = pts[0].x;
    best_l = 0; best_r = 0;
    for (int i = 0; i < n - 1; ++i) {
        if (pts[i].x == pts[i+1].x) continue;
        double thresh = (pts[i].x + pts[i+1].x) / 2.0;
        vector<int> left, right;
        for (const auto& p : pts) {
            if (p.x <= thresh) left.push_back(p.y);
            else right.push_back(p.y);
        }
        double g = (left.size() * gini(left) + right.size() * gini(right)) / n;
        if (g < best_g) {
            best_g = g;
            best_t = thresh;
            int sum_l = 0; for (int v : left) sum_l += v;
            int sum_r = 0; for (int v : right) sum_r += v;
            best_l = (sum_l * 2 >= (int)left.size()) ? 1 : 0;
            best_r = (sum_r * 2 >= (int)right.size()) ? 1 : 0;
        }
    }
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, num_trees;
    if (!(cin >> n >> num_trees)) return 0;
    vector<Point> pts(n);
    for (int i = 0; i < n; ++i) cin >> pts[i].x >> pts[i].y;

    vector<double> tree_t(num_trees);
    vector<int> tree_l(num_trees), tree_r(num_trees);

    for (int b = 0; b < num_trees; ++b) {
        // Bootstrap: boc n lan CO HOAN LAI bang bo sinh so gia ngau nhien LCG,
        // cung cong thuc voi ban Python
        vector<Point> sub_pts(n);
        long long state = 12345 + b;
        for (int i = 0; i < n; ++i) {
            state = (1103515245LL * state + 12345) % 2147483648LL;
            // Lay bit cao (state >> 16): bit thap cua LCG mod 2^31 lap chu ky ngan, nen state % n voi
            // n = 2^k chi cho mot hoan vi cua n diem (khong diem nao bi boc 2 lan).
            sub_pts[i] = pts[(state >> 16) % n];
        }
        fit_stump(sub_pts, tree_t[b], tree_l[b], tree_r[b]);
    }

    int q;
    cin >> q;
    vector<double> q_xs(q);
    for (int i = 0; i < q; ++i) cin >> q_xs[i];

    cout << fixed << setprecision(4);
    cout << "trees=" << num_trees << "\n";
    for (int b = 0; b < num_trees; ++b) {
        cout << "cay " << b + 1 << ": nguong=" << tree_t[b]
             << " trai=" << tree_l[b] << " phai=" << tree_r[b] << "\n";
    }
    for (int i = 0; i < q; ++i) {
        int sum_votes = 0;
        for (int b = 0; b < num_trees; ++b) {
            int vote = (q_xs[i] <= tree_t[b]) ? tree_l[b] : tree_r[b];
            sum_votes += vote;
        }
        int pred = (sum_votes * 2 >= num_trees) ? 1 : 0;
        cout << pred << "\n";
    }
    return 0;
}
Đánh giá tầm quan trọng của đặc trưng (Feature Importance)
Một trong những tính năng giá trị nhất của Random Forest là khả năng xếp hạng mức độ quan trọng của từng biến đầu vào đối với bài toán:
- Mean Decrease Impurity (MDI): Tính tổng độ suy giảm của chỉ số Gini Impurity (hoặc Entropy) tạo ra bởi đặc trưng \(j\) trên toàn bộ các nút phân nhánh của tất cả các cây trong rừng. Đặc trưng nào giúp các nút trở nên thuần khiết nhiều nhất sẽ có điểm MDI cao nhất. Phương pháp này rất nhanh vì được tính toán tự động trong quá trình huấn luyện.
- Permutation Feature Importance (PFI): Tráo đổi ngẫu nhiên (shuffle) các giá trị của đặc trưng \(j\) trên tập dữ liệu kiểm tra OOB để làm mất mối tương quan của nó với nhãn. Nếu sau khi tráo đổi, độ chính xác của mô hình bị sụt giảm nghiêm trọng, điều đó chứng tỏ đặc trưng \(j\) có vai trò sống còn đối với quyết định của mô hình.
- MDI thiên lệch với các biến có nhiều giá trị: Phương pháp MDI có xu hướng đánh giá cao quá mức các đặc trưng số liên tục hoặc đặc trưng phân loại có nhiều nhóm giá trị khác nhau (high-cardinality). Trong các bài toán thực tế nhạy cảm, nên sử dụng Permutation Feature Importance để có kết quả khách quan nhất.
- Thời gian suy luận (Inference Latency): Vì phải duyệt qua hàng trăm cây quyết định lớn, thời gian dự đoán của Random Forest có thể chậm hơn so với các mô hình tuyến tính đơn giản. Trong các hệ thống giao dịch tần suất cao hoặc thiết bị nhúng IoT, cần cân nhắc số lượng cây vừa đủ (khoảng 50 đến 100 cây) để đảm bảo tốc độ phản hồi.
Câu hỏi thường gặp
Tăng số lượng cây trong Random Forest có làm mô hình bị Overfitting không?
Không bao giờ! Khác với Gradient Boosting, việc tăng số lượng cây \(B\) trong Random Forest chỉ làm giảm phương sai và giúp kết quả dự đoán hội tụ ổn định hơn về mặt thống kê. Bạn có thể tăng số cây lên 500 hoặc 1.000 mà không lo ngại mô hình bị quá khớp; giới hạn duy nhất chỉ là thời gian tính toán và bộ nhớ RAM.
Random Forest khác gì so với Gradient Boosting (XGBoost)?
- Random Forest (Bagging): Xây dựng các cây độc lập song song với nhau; mỗi cây đều sâu đầy đủ; mục tiêu chính là giảm phương sai (variance).
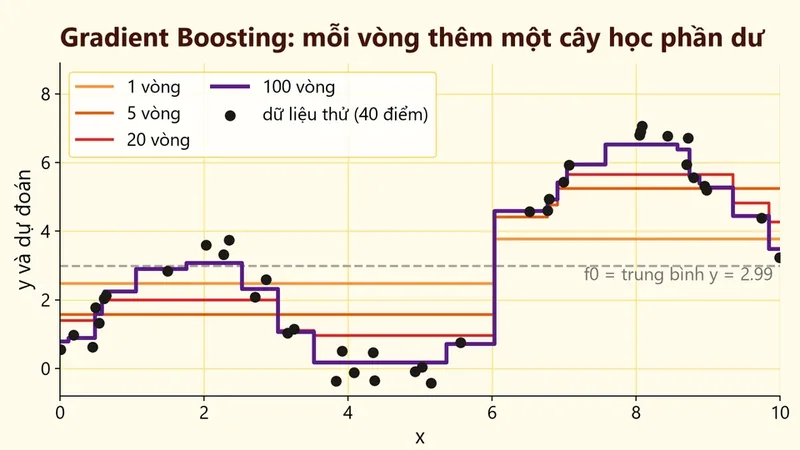
- Gradient Boosting (Boosting): Xây dựng các cây tuần tự nối tiếp nhau; mỗi cây sau học cách sửa sai cho cây trước; các cây thường rất nông; mục tiêu chính là giảm độ chệch (bias).
Random Forest có xử lý được dữ liệu bị mất cân bằng lớp (Imbalanced Data) không?
Có thể xử lý rất tốt nếu kết hợp với tham số class_weight="balanced" (tự động gán trọng số phạt lớn hơn cho lớp thiểu số) hoặc kỹ thuật Balanced Random Forest (lấy mẫu bootstrap cân bằng giữa các lớp).
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.