- AI sinh dữ liệu mẫu nhanh và đa dạng, nhất là tên tiếng Việt và các trường hợp biên mà ta hay quên.
- Mô tả rõ khuôn dữ liệu (các trường, kiểu, khoảng giá trị) và quy ước dữ liệu giả: email chỉ dùng tên miền dành cho ví dụ, số điện thoại theo một mẫu dễ nhận ra.
- Không dùng thẳng thứ mô hình trả về. Một hàm soát nhỏ loại dòng hỏng và nói rõ vì sao.
- Sinh một lần rồi lưu thành tệp. Bài thử đọc tệp đó, không gọi mô hình mỗi lần chạy.
Bài này dùng Python thuần, không cần thư viện ngoài. Phần gọi mô hình dùng tính năng trả về theo khuôn JSON mà bài AI trả về JSON đã giới thiệu. Trang tài liệu về structured outputs của Claude, RFC 2606 và tài liệu module random của Python được đọc ngày 11/11/2026. Toàn bộ học sinh trong bài là dữ liệu giả lập.
Vì sao cần dữ liệu mẫu
Một chương trình chạy đúng với ba dòng bạn gõ tay chưa chắc chạy đúng với lớp bốn mươi học sinh. Lỗi hay nằm ở chỗ ít ai nghĩ tới: họ tên dài hơn độ rộng cột, tên có ký tự như "Ỷ" hay "Ữ", điểm đúng bằng 0 làm phép chia lệch, điểm 10 lọt ra ngoài khoảng xếp loại, ô bỏ trống khiến hàm tính trung bình báo lỗi. Muốn bắt những lỗi này, ta cần một bộ dữ liệu vừa đủ nhiều, vừa có chủ đích.
Dùng dữ liệu thật để thử là cách nhanh nhất nhưng sai về nguyên tắc. Bảng điểm thật có tên, ngày sinh, số điện thoại phụ huynh. Đem chúng vào máy cá nhân, vào kho code, hay dán vào công cụ AI là đưa thông tin cá nhân đi xa hơn mức cần. Bài dùng AI phân tích dữ liệu an toàn đã nói về chuyện che cột nhạy cảm; với việc thử chương trình, cách sạch nhất là không đụng tới dữ liệu thật mà dùng dữ liệu giả có hình dạng giống thật.
AI giúp được gì, và không giúp được gì
Mô hình ngôn ngữ giỏi ở phần khó tự viết: tên tiếng Việt nghe tự nhiên, đủ họ, tên đệm, tên ghép; câu nhận xét của giáo viên có giọng khác nhau; địa chỉ có số nhà, tên đường, phường. Bạn chỉ cần nói "thêm vài trường hợp biên" là nó tự nghĩ ra tên rất dài, điểm 0, điểm 10. Với một sinh viên đang làm đồ án, đây là cách có được bộ dữ liệu trông thật chỉ trong một phút.
Điểm yếu cũng rõ. Mô hình không đảm bảo mọi dòng đúng luật bạn đặt ra: thỉnh thoảng nó viết email đuôi gmail.com dù bạn dặn example.com, cho điểm 11, hoặc lặp lại một mã. Nó cũng có thể "nhớ" ra một tên và số điện thoại trông như của người có thật. Thêm nữa, mỗi lần gọi lại ra một bộ khác, nên một bài thử hôm nay qua, mai có thể trượt chỉ vì dữ liệu đổi. Cả ba điểm này đều xử lý được bằng code, như các phần dưới.
Mô tả dữ liệu cần sinh
Một yêu cầu tốt gồm hai phần. Phần thứ nhất là khuôn: các trường, kiểu của từng trường, trường nào bắt buộc. Khi gửi khuôn này dưới dạng JSON Schema qua tính năng structured outputs, trong hầu hết trường hợp câu trả lời của mô hình đúng cấu trúc đó: đủ trường bắt buộc, đúng kiểu, không thêm trường lạ. Tài liệu Claude nêu hai ngoại lệ: mô hình từ chối (lý do dừng là refusal) hoặc câu trả lời bị cắt vì chạm giới hạn token (lý do dừng là max_tokens); khi đó đầu ra có thể không khớp khuôn, nên xem lý do dừng trước khi đọc. Khuôn cũng không giữ được mọi quy ước về giá trị: tài liệu xếp các ràng buộc số như minimum, maximum vào mục không hỗ trợ, nên điểm từ 0 đến 10 không ghi được vào khuôn, còn quy ước email thuộc example.com chỉ nằm trong lời dặn. Những điều đó bạn vẫn phải tự soát.
Phần thứ hai là quy ước bằng lời. Trong ví dụ của bài, chỉ dẫn yêu cầu tên tiếng Việt đa dạng, email dạng tên@example.com, số điện thoại dạng 0900000 kèm ba chữ số, điểm Toán từ 0 đến 10 có một chữ số thập phân, và vài trường hợp biên. Chọn example.com không phải ngẫu nhiên: RFC 2606 dành riêng ba tên miền example.com, example.net, example.org cho mục đích làm ví dụ, nên một email gửi nhầm tới đó không tới tay ai. Số điện thoại thì Việt Nam không có dải dành riêng tương tự, vì vậy ta tự quy ước một mẫu dễ nhận ra và tuyệt đối không gọi hay nhắn tới các số này từ chương trình thử.
Ví dụ bằng Python
Chương trình mẫu có ba phần. Biến SCHEMA là khuôn JSON gửi kèm yêu cầu. Hàm soat kiểm từng dòng mô hình trả về: điểm có nằm trong 0 đến 10, email có thuộc tên miền ví dụ, số điện thoại có theo mẫu giả, mã có bị trùng; dòng nào hỏng thì bị loại kèm lý do. Hàm sinh_cuc_bo là cách không cần AI, dùng module random với hạt giống cố định.
"""Dùng AI sinh dữ liệu mẫu (học sinh giả) để thử chương trình, rồi SOÁT trước khi dùng.

- SCHEMA: khuôn JSON gửi kèm yêu cầu (structured outputs) để mô hình trả đúng cấu trúc.
- soat: kiểm từng dòng: đủ trường, điểm trong 0-10, email chỉ dùng tên miền dành cho ví dụ (example.com, theo RFC 2606),
  số điện thoại theo mẫu giả 0900000xxx, mã không trùng. Dòng hỏng bị loại kèm lý do.
- sinh_cuc_bo: cách không cần AI, dùng random có hạt giống để lần nào chạy cũng ra cùng dữ liệu.
"""
import random
import re

SCHEMA = {
    "type": "object",
    "properties": {"hoc_sinh": {"type": "array", "items": {
        "type": "object",
        "properties": {"ma": {"type": "string"}, "ho_ten": {"type": "string"}, "email": {"type": "string"},
                       "dien_thoai": {"type": "string"}, "diem_toan": {"type": "number"}},
        "required": ["ma", "ho_ten", "email", "dien_thoai", "diem_toan"], "additionalProperties": False}}},
    "required": ["hoc_sinh"], "additionalProperties": False,
}
CHI_DAN = ("Sinh {n} học sinh GIẢ để thử phần mềm: tên tiếng Việt đa dạng (có dấu, tên ghép), email dạng ten@example.com, "
           "số điện thoại dạng 0900000xxx, điểm Toán từ 0 đến 10 có một chữ số thập phân, gồm vài trường hợp biên (0, 10, tên rất dài).")


def soat(ds):
    tot, loai, da_co = [], [], set()
    for d in ds:
        ly_do = []
        if not 0 <= d["diem_toan"] <= 10:
            ly_do.append("điểm ngoài 0-10")
        if not re.fullmatch(r"[\w.+-]+@example\.(com|org|net)", d["email"]):
            ly_do.append("email không phải tên miền ví dụ")
        if not re.fullmatch(r"0900000\d{3}", d["dien_thoai"]):
            ly_do.append("số điện thoại không theo mẫu giả")
        if d["ma"] in da_co:
            ly_do.append("trùng mã")
        da_co.add(d["ma"])
        (loai if ly_do else tot).append((d["ma"], ly_do))
    return [m for m, _ in tot], loai


HO = ["Nguyễn", "Trần", "Lê", "Phạm", "Hoàng", "Vũ"]
TEN = ["An", "Bình", "Chi", "Dũng", "Gia Hân", "Minh Khoa", "Ngọc Ánh"]


def sinh_cuc_bo(n, hat_giong=2026):
    r = random.Random(hat_giong)
    return [{"ma": f"HS{i:03d}", "ho_ten": f"{r.choice(HO)} {r.choice(TEN)}", "email": f"hs{i:03d}@example.com",
             "dien_thoai": f"0900000{i:03d}", "diem_toan": round(r.uniform(0, 10), 1)} for i in range(1, n + 1)]


def chay_thu():
    tra_ve_mo_hinh = [  # giả lập câu trả lời của mô hình, có vài dòng hỏng
        {"ma": "HS001", "ho_ten": "Nguyễn Thị Ngọc Ánh", "email": "anh@example.com", "dien_thoai": "0900000001", "diem_toan": 10.0},
        {"ma": "HS002", "ho_ten": "Trần Bình", "email": "binh@gmail.com", "dien_thoai": "0900000002", "diem_toan": 7.5},
        {"ma": "HS003", "ho_ten": "Lê Chi", "email": "chi@example.com", "dien_thoai": "0912345678", "diem_toan": 11.0},
        {"ma": "HS001", "ho_ten": "Phạm Dũng", "email": "dung@example.com", "dien_thoai": "0900000004", "diem_toan": 0.0},
    ]
    tot, loai = soat(tra_ve_mo_hinh)
    dong = [f"Giữ: {', '.join(tot)}"] + [f"Loại {m}: {'; '.join(l)}" for m, l in loai]
    a, b = sinh_cuc_bo(3), sinh_cuc_bo(3)
    dong.append(f"Sinh cục bộ 3 dòng, chạy hai lần giống nhau: {a == b}; dòng đầu {a[0]['ma']} {a[0]['ho_ten']} {a[0]['diem_toan']}")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Để chạy được mà không cần khóa API, phần thử dùng một danh sách giả lập bốn dòng như mô hình có thể trả về, trong đó cố ý có ba dòng hỏng. Kết quả: giữ lại một dòng là HS001; loại HS002 vì email đuôi gmail.com; loại HS003 vì điểm 11 và số điện thoại không theo mẫu; loại dòng HS001 thứ hai vì trùng mã. Hàm soát không sửa giúp mà chỉ báo lý do, vì sửa tự động dễ che mất lỗi của chính chỉ dẫn. Nếu thấy nhiều dòng bị loại cùng một lý do, nên sửa câu chỉ dẫn rồi sinh lại.
Phần cuối chạy sinh_cuc_bo hai lần với cùng hạt giống và so sánh: hai bộ giống hệt nhau. Tài liệu module random giải thích rằng khi đặt cùng hạt giống, dãy số sinh ra lặp lại y như cũ. Lưu ý tài liệu cũng cảnh báo module này không dùng cho mục đích bảo mật; với dữ liệu thử thì không sao.
Sinh một lần, dùng nhiều lần
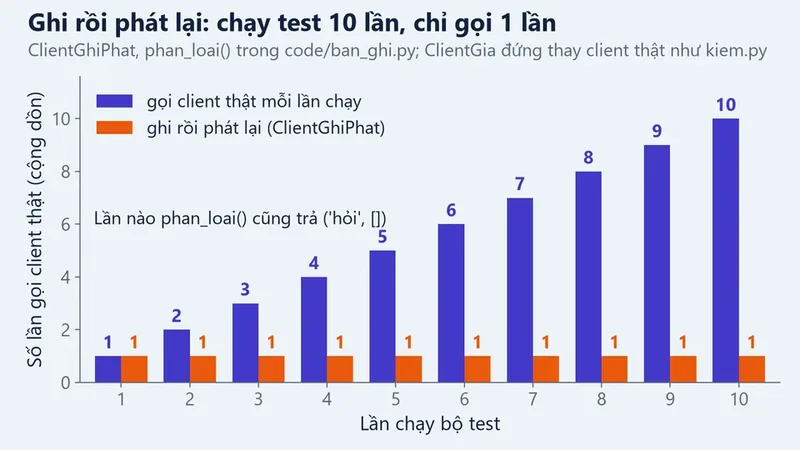
Một bài thử tốt phải cho cùng kết quả mỗi lần chạy. Nếu mỗi lần thử lại gọi mô hình sinh dữ liệu mới, bạn sẽ gặp bài thử lúc qua lúc trượt mà không rõ vì code hay vì dữ liệu. Cách làm đúng là sinh một lần, soát, rồi ghi ra tệp JSON hoặc CSV đặt cạnh code thử. Từ đó trở đi, bài thử chỉ đọc tệp.
Khi cần thêm trường hợp mới, bạn sinh bổ sung, soát, rồi nối vào tệp và ghi chú vì sao thêm. Như vậy tệp dữ liệu mẫu trở thành một phần của dự án, có lịch sử trong git, ai trong nhóm cũng chạy ra cùng kết quả. Bài viết test cho ứng dụng AI dùng cùng ý tưởng cho câu trả lời của mô hình: ghi lại một lần, phát lại khi thử.
Với dữ liệu lớn, ví dụ vài nghìn dòng để thử tốc độ, hãy để mô hình sinh vài chục dòng mẫu có chất lượng, rồi dùng code nhân rộng bằng cách trộn họ, tên đệm, tên và điểm theo hạt giống cố định. Gọi mô hình cho từng nghìn dòng vừa tốn tiền vừa khó soát.
Khi nào không cần AI
Không phải lúc nào cũng nên gọi mô hình. Nếu chỉ cần cột số, ngày tháng hay mã tăng dần, vài dòng Python với random là đủ, chạy tức thì và không tốn đồng nào. Thư viện Faker cũng sinh sẵn tên, địa chỉ, email giả cho nhiều ngôn ngữ. AI đáng dùng khi bạn cần nội dung có ngữ nghĩa: câu nhận xét học bạ, câu hỏi của khách hàng, đoạn văn có lỗi chính tả có chủ đích để thử bộ sửa lỗi, hay một bộ dữ liệu có các tình huống khó mà bạn chỉ mô tả được bằng lời.
Một cách kết hợp hay dùng: code sinh phần cấu trúc (mã, điểm, ngày) theo hạt giống, còn mô hình chỉ điền phần chữ. Như vậy phần dễ sai được kiểm soát chặt, phần cần sáng tạo thì mô hình lo.
Quy trình gọn cho một đồ án
Giả sử bạn làm đồ án quản lý thư viện trường. Bước một, viết ra các trường của bảng sách và bảng mượn trả, kèm luật của từng trường: mã sách duy nhất, ngày trả không trước ngày mượn, số lượng không âm. Bước hai, biến các luật đó thành JSON Schema và một hàm soát như ví dụ trên. Bước ba, nhờ mô hình sinh vài chục dòng, yêu cầu rõ các trường hợp biên: sách mượn quá hạn, sách chưa ai mượn, tên sách có dấu ngoặc kép. Bước bốn, chạy hàm soát, đọc lý do các dòng bị loại, chỉnh chỉ dẫn nếu cần. Bước năm, lưu tệp và viết bài thử đọc từ tệp đó.
Cả quy trình mất khoảng nửa giờ, và bạn có một bộ dữ liệu dùng được tới cuối học kỳ. Khi giảng viên hỏi dữ liệu thử lấy từ đâu, bạn có câu trả lời rõ ràng: sinh bằng AI, soát bằng code, toàn bộ là dữ liệu giả.
Những lỗi hay gặp
Lỗi thứ nhất là tin mô hình hiểu "giả" giống bạn. Nó có thể dùng tên người nổi tiếng hoặc ghép ra một số điện thoại có thật. Hàm soát với mẫu cố định chặn được phần lớn, phần còn lại cần mắt người đọc qua một lượt. Lỗi thứ hai là chỉ sinh dữ liệu đẹp: tên ngắn, điểm trung bình, không ô trống. Dữ liệu như vậy làm bài thử qua dễ dàng nhưng không bắt được lỗi nào. Hãy yêu cầu rõ các trường hợp biên và đếm xem bộ dữ liệu có đủ chưa.
Lỗi thứ ba là để dữ liệu mẫu và dữ liệu thật lẫn nhau, ví dụ cùng nằm trong một thư mục, cùng tên tệp. Đặt tên rõ như hoc_sinh_mau.json, để trong thư mục riêng của phần thử, và ghi một dòng đầu tệp rằng đây là dữ liệu giả lập.
- Dùng dữ liệu thật của học sinh hay khách hàng để thử chương trình.
- Đưa thẳng câu trả lời của mô hình vào bài thử mà không soát.
- Gọi mô hình sinh dữ liệu mới ở mỗi lần chạy thử.
- Để email giả dùng tên miền có thật, có thể gửi nhầm tới người khác.
- Quên ghi chú rằng tệp là dữ liệu giả lập.
Câu hỏi thường gặp
Dữ liệu do AI sinh có phải là dữ liệu tổng hợp không?
Có, đó là một dạng dữ liệu tổng hợp. Với việc thử chương trình, điều quan trọng là đúng hình dạng và đủ trường hợp biên.
Mô hình có thể sinh ra thông tin của người thật không?
Có thể, nhất là tên người nổi tiếng. Soát bằng mẫu cố định và đọc lại một lượt trước khi lưu.
Nên sinh bao nhiêu dòng?
Vài chục dòng có chủ đích thường đủ để thử logic. Cần nhiều hơn để đo tốc độ thì nhân rộng bằng code.
Không có khóa API thì làm sao?
Dùng random với hạt giống cố định hoặc thư viện Faker; hoặc dán khuôn vào giao diện trò chuyện rồi soát kết quả.
Học tiếp
- Ép mô hình trả đúng khuôn: AI trả về JSON.
- Ghi lại và phát lại khi thử: viết test cho ứng dụng AI.
- Làm việc với bảng dữ liệu thật mà không lộ thông tin: dùng AI phân tích dữ liệu an toàn.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.