- Truyền dần gửi câu trả lời thành nhiều sự kiện qua kênh server-sent events, mỗi sự kiện mang một đoạn chữ, nên người dùng thấy chữ ngay.
- Thư viện Python có sẵn hàm truyền dần: duyệt từng đoạn chữ, và lấy tin nhắn hoàn chỉnh khi xong, không phải tự ghép sự kiện.
- Lỗi có thể đến giữa luồng dưới dạng một sự kiện lỗi, sau khi đã nhận mã 200. Chương trình phải xử lý riêng trường hợp này.
- Với yêu cầu kéo dài hơn mười phút, truyền dần giúp đường truyền không bị đóng giữa chừng.
Bài này dựa trên trang Streaming messages và mục Long requests trong trang lỗi API của Anthropic, đọc ngày 11/11/2026. Người chưa từng gửi yêu cầu tới mô hình nên bắt đầu từ bài gọi API đầu tiên.
Vì sao truyền dần
Có hai lý do. Thứ nhất là trải nghiệm: người dùng đọc được phần đầu trong lúc mô hình còn viết phần sau, cảm giác nhanh hơn nhiều dù tổng thời gian như nhau. Đây là lý do mọi giao diện chat đều hiện chữ dần. Thứ hai là độ bền kết nối. Một yêu cầu không truyền dần giữ đường truyền im lặng suốt lúc mô hình viết; mạng ở giữa có thể coi là treo và đóng lại. Trang lỗi của Anthropic vì vậy khuyên chọn truyền dần, hoặc gửi theo lô, cho việc kéo dài hơn mười phút, và thư viện chính thức sẽ chặn lời gọi thường khi ước tính nó vượt ngưỡng ấy.
Với câu trả lời ngắn trong chương trình chạy nền, không có người chờ, gọi thường đơn giản hơn và đủ dùng. Một cách nghĩ đơn giản: nếu có người đang nhìn màn hình chờ chữ, hãy truyền dần; nếu kết quả chỉ được ghi vào tệp hay cơ sở dữ liệu, gọi thường cho gọn, trừ khi câu trả lời rất dài.
Truyền dần cũng mở ra vài khả năng khác. Chương trình có thể dừng sớm khi thấy câu trả lời đi sai hướng, tiết kiệm token. Giao diện có thể hiện trạng thái như "đang tìm kiếm" hay "đang chạy code" khi luồng báo mô hình bắt đầu dùng công cụ, thay vì một vòng quay chung chung.
Luồng sự kiện
Tài liệu mô tả mỗi luồng theo một trình tự cố định. Đầu tiên là sự kiện mở tin nhắn, chứa một tin nhắn có nội dung rỗng. Tiếp theo là các khối nội dung; mỗi khối có một sự kiện bắt đầu, nhiều sự kiện cập nhật (delta), và một sự kiện kết thúc, kèm chỉ số khớp vị trí của khối trong tin nhắn cuối. Sau đó là một hoặc nhiều sự kiện cập nhật tin nhắn, mang lý do dừng và số token đầu ra. Cuối cùng là sự kiện kết thúc tin nhắn. Xen kẽ có thể có các sự kiện ping giữ kết nối.
Mỗi sự kiện cập nhật mang một loại delta. Với chữ, delta chứa một đoạn chữ. Với công cụ, delta chứa một mảnh JSON tham số chưa hoàn chỉnh, phải ghép đủ mới đọc được. Với chế độ suy nghĩ, có delta riêng cho phần suy nghĩ.
Dùng thư viện Python
Bạn hiếm khi phải tự đọc từng sự kiện. Thư viện anthropic có hàm truyền dần trả về một đối tượng luồng. Duyệt thuộc tính đoạn chữ của nó để nhận từng mảnh chữ và in ngay; khi xong, gọi hàm lấy tin nhắn cuối để có tin nhắn hoàn chỉnh như khi gọi thường, gồm cả số token. Tài liệu còn có cách cho thư viện tự gom luồng và chỉ trả về tin nhắn cuối, hữu ích khi bạn cần yêu cầu dài mà không cần hiện dần.
Lỗi giữa luồng
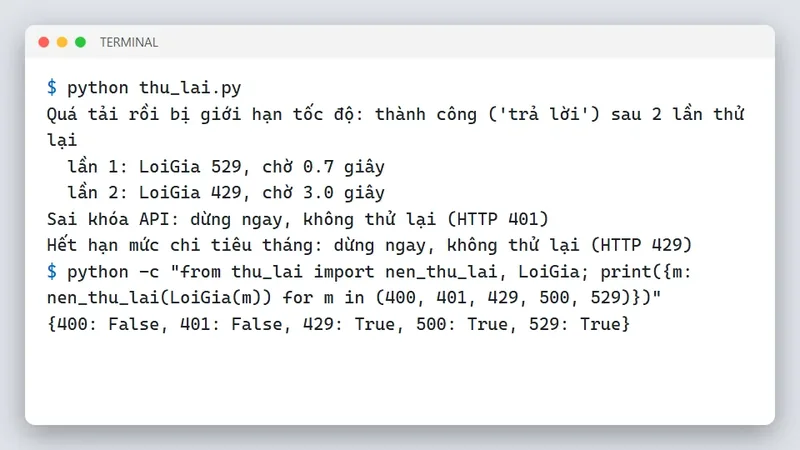
Điểm khác biệt quan trọng: với truyền dần, lỗi có thể xảy ra sau khi máy chủ đã trả mã 200 và đã gửi một phần chữ. Tài liệu ví dụ lúc tải cao có thể nhận sự kiện lỗi quá tải ngay trong luồng. Vì vậy cơ chế bắt lỗi theo mã HTTP như trong bài xử lý lỗi khi gọi API AI không đủ: chương trình phải xử lý cả sự kiện lỗi trong luồng, và giao diện phải biết hiển thị câu trả lời dở dang.
Tài liệu đưa ra cách khôi phục: lưu mọi phần đã nhận trước khi lỗi, gửi một yêu cầu mới để viết tiếp. Với mô hình từ Claude 4.6 trở đi, yêu cầu mới là một tin nhắn của người dùng chứa phần đã nhận và lời dặn viết tiếp từ chỗ bị ngắt. Khối công cụ và khối suy nghĩ không khôi phục từng phần được; chỉ tiếp tục được từ khối chữ gần nhất.
Ví dụ bằng Python
Chương trình mẫu có ba phần. Hàm ghep_su_kien ghép một danh sách sự kiện (dạng dữ liệu như trong luồng) thành chữ, lý do dừng và lỗi nếu có, bỏ qua ping và các delta không phải chữ. Hàm yeu_cau_noi_tiep tạo tin nhắn viết tiếp theo cách tài liệu gợi ý, gộp vào một tin của người dùng vì API không nhận hai tin liền nhau cùng vai. Hàm in_dan dùng hàm truyền dần của thư viện để in từng đoạn và đọc tin nhắn cuối, rồi xem lý do dừng trong tin nhắn đó để báo rõ nếu câu trả lời bị cắt vì chạm max_tokens hay bị từ chối. max_tokens để rộng vì phần suy nghĩ của mô hình cũng tính vào đó.
"""Truyền dần câu trả lời (streaming): in chữ ngay khi có, ghép sự kiện SSE, xử lý lỗi giữa chừng, nối tiếp phần còn thiếu.

Luồng sự kiện theo tài liệu Anthropic (đọc 11/11/2026): message_start -> mỗi khối nội dung có content_block_start,
nhiều content_block_delta, content_block_stop -> message_delta (có stop_reason) -> message_stop; xen kẽ có thể có ping;
lỗi có thể đến GIỮA luồng dưới dạng sự kiện error (ví dụ overloaded_error) dù đã nhận mã 200.
Với Claude 4.6 trở đi, nối tiếp sau lỗi bằng một tin của người dùng chứa phần đã nhận và yêu cầu viết tiếp.
Cài: python -m pip install anthropic ; đặt ANTHROPIC_API_KEY để chạy thật.
"""
import os
import sys


def ghep_su_kien(cac_su_kien):
    """Ghép các sự kiện (dạng dict như dữ liệu SSE) thành (chữ, lý do dừng, lỗi)."""
    chu, ly_do, loi = "", None, None
    for sk in cac_su_kien:
        loai = sk["type"]
        if loai == "content_block_delta" and sk["delta"]["type"] == "text_delta":
            chu += sk["delta"]["text"]
        elif loai == "message_delta":
            ly_do = sk["delta"].get("stop_reason")
        elif loai == "error":
            loi = sk["error"]["type"]
            break
    return chu, ly_do, loi


def yeu_cau_noi_tiep(cau_hoi, phan_da_co):
    """Tin nhắn để viết tiếp sau khi luồng bị ngắt (cách gợi ý cho Claude 4.6 trở đi)."""
    # Một tin duy nhất của người dùng (API không nhận hai tin liền nhau cùng vai).
    return [{"role": "user", "content": f"{cau_hoi}\n\nCâu trả lời trước của bạn bị ngắt, kết thúc ở: [{phan_da_co}]. "
                                        "Hãy viết tiếp từ chỗ đó, không lặp lại phần đã có."}]


class KhongCoCauTraLoi(Exception):
    """Luồng kết thúc mà câu trả lời chưa trọn vẹn."""


def in_dan(client, cau_hoi, ghi=print, mo_hinh="claude-haiku-5-5"):
    """In từng đoạn chữ ngay khi mô hình sinh ra; trả về (toàn bộ chữ, token vào, token ra).
    Câu trả lời bị cắt, bị từ chối hay không có chữ thì ném KhongCoCauTraLoi (sau khi đã in phần nhận được)."""
    # Haiku 5.5 suy nghĩ trước khi trả lời, và token suy nghĩ tính vào max_tokens dù không hiện ra, nên để rộng chỗ.
    # max_tokens chỉ là mức trần: bạn trả tiền cho số token thật sự sinh ra; truyền dần nên không lo hết giờ chờ.
    with client.messages.stream(model=mo_hinh, max_tokens=16000,
                                messages=[{"role": "user", "content": cau_hoi}]) as luong:
        for doan in luong.text_stream:
            ghi(doan, end="", flush=True)
        cuoi = luong.get_final_message()
    ghi()
    # Lý do dừng có ở tin nhắn cuối (sự kiện message_delta): xem nó trước khi coi phần đã in là câu trả lời xong.
    if cuoi.stop_reason in ("max_tokens", "model_context_window_exceeded"):
        raise KhongCoCauTraLoi(f"câu trả lời bị cắt giữa chừng ({cuoi.stop_reason})")
    if cuoi.stop_reason == "refusal":
        raise KhongCoCauTraLoi("mô hình từ chối trả lời")
    chu = "".join(k.text for k in cuoi.content if k.type == "text")
    if not chu.strip():
        raise KhongCoCauTraLoi("mô hình không trả về chữ nào")
    return chu, cuoi.usage.input_tokens, cuoi.usage.output_tokens


def chay_thu():
    su_kien = [{"type": "message_start", "message": {"content": []}}, {"type": "ping"},
               {"type": "content_block_start", "index": 0, "content_block": {"type": "text", "text": ""}},
               {"type": "content_block_delta", "index": 0, "delta": {"type": "text_delta", "text": "Đệ quy là "}},
               {"type": "content_block_delta", "index": 0, "delta": {"type": "text_delta", "text": "hàm tự gọi"}},
               {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}]
    chu, ly_do, loi = ghep_su_kien(su_kien)
    dong = [f"Nhận được: '{chu}', lý do dừng: {ly_do}, lỗi giữa luồng: {loi}"]
    tin = yeu_cau_noi_tiep("Đệ quy là gì?", chu)
    dong.append(f"Yêu cầu nối tiếp: {len(tin)} tin, có phần đã nhận: {chu in tin[0]['content']}")
    du = su_kien[:5] + [{"type": "content_block_stop", "index": 0},
                        {"type": "message_delta", "delta": {"stop_reason": "end_turn"}}, {"type": "message_stop"}]
    dong.append("Luồng đầy đủ: '{}', lý do dừng: {}, lỗi: {}".format(*ghep_su_kien(du)))
    print("\n".join(dong))
    return dong


def main(cau_hoi):
    if not os.environ.get("ANTHROPIC_API_KEY"):
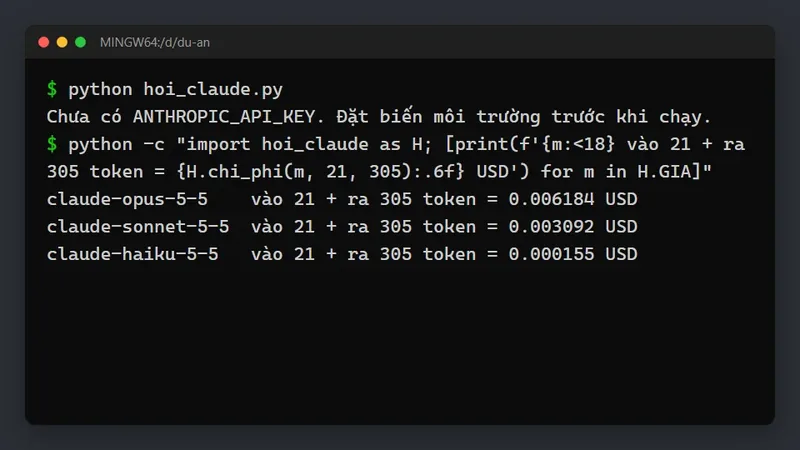
        sys.exit("Chưa có ANTHROPIC_API_KEY. Đặt biến môi trường trước khi chạy.")
    import anthropic
    try:
        _, vao, ra = in_dan(anthropic.Anthropic(), cau_hoi)
    except KhongCoCauTraLoi as e:
        sys.exit(f"Chưa có câu trả lời trọn vẹn: {e}.")
    except anthropic.APIStatusError as e:
        sys.exit(f"API báo lỗi {e.status_code}: {e.message}")
    except anthropic.APIConnectionError:
        sys.exit("Không kết nối được tới API. Kiểm tra mạng rồi thử lại.")
    print(f"[token vào {vao}, token ra {ra}]")


if __name__ == "__main__":
    main(" ".join(sys.argv[1:])) if len(sys.argv) > 1 else chay_thu()
Phần chạy thử giả lập hai luồng. Luồng thứ nhất có ping, hai đoạn chữ "Đệ quy là " và "hàm tự gọi", rồi một sự kiện lỗi quá tải: chương trình ghép được phần đã nhận, ghi nhận lỗi, chưa có lý do dừng, và tạo yêu cầu viết tiếp chứa phần đó. Luồng thứ hai đầy đủ tới sự kiện kết thúc, có lý do dừng là kết thúc lượt bình thường.
Đo độ trễ cho đúng
Khi so sánh mô hình hay cấu hình, có hai con số đáng đo với truyền dần. Thời gian tới đoạn chữ đầu tiên cho biết người dùng phải chờ bao lâu trước khi thấy phản hồi; đây là con số quyết định cảm giác nhanh hay chậm. Tổng thời gian tới sự kiện kết thúc cho biết bao lâu mới có câu trả lời đầy đủ, quan trọng khi chương trình cần cả câu trả lời để làm bước tiếp. Một mô hình có thể có thời gian tới đoạn đầu ngắn nhưng tổng thời gian dài vì viết nhiều; giới hạn độ dài câu trả lời rút ngắn con số thứ hai. Ghi cả hai con số cho mỗi lần gọi trong nhật ký để theo dõi theo thời gian, và so sánh trước, sau mỗi lần đổi mô hình hay đổi chỉ dẫn hệ thống.
Truyền dần qua dịch vụ của bạn
Trong ứng dụng web, trình duyệt không gọi thẳng API mô hình mà gọi dịch vụ của bạn, nơi giữ khóa API. Dịch vụ gọi mô hình ở chế độ truyền dần và chuyển tiếp từng đoạn cho trình duyệt, thường cũng bằng server-sent events. Các khung giao diện Python như Streamlit và Gradio đã làm sẵn phần này: bạn chỉ cần một hàm sinh trả từng đoạn, xem bài chatbot Streamlit. Nhớ đặt thời gian chờ hợp lý ở mọi tầng trung gian, vì một số máy chủ trung gian mặc định cắt kết nối giữ lâu.
- Chỉ bắt lỗi theo mã HTTP, bỏ qua sự kiện lỗi trong luồng.
- Tự ghép mảnh JSON tham số công cụ rồi đọc khi chưa đủ.
- Gửi lại cả câu hỏi từ đầu khi luồng bị ngắt, tốn token cho phần đã nhận.
- Dùng gọi thường cho câu trả lời rất dài và bị cắt kết nối.
- Không báo cho người dùng khi câu trả lời bị dở dang.
Câu hỏi thường gặp
Truyền dần có đắt hơn không?
Không. Token tính như gọi thường; chỉ cách nhận kết quả khác.
Có dùng truyền dần với công cụ được không?
Được. Tham số công cụ đến dần dưới dạng mảnh JSON; thư viện ghép giúp bạn.
Số token lấy ở đâu khi truyền dần?
Trong tin nhắn cuối mà thư viện trả về, hoặc trong sự kiện cập nhật tin nhắn cuối luồng.
SSE khác WebSocket thế nào?
SSE là kênh một chiều từ máy chủ tới máy khách trên HTTP, đủ cho việc hiện chữ dần. WebSocket hai chiều, phức tạp hơn.
Học tiếp
- Giao diện chat có chữ hiện dần: chatbot Streamlit.
- Lỗi theo mã HTTP và thử lại: xử lý lỗi khi gọi API AI.
- Bắt đầu từ yêu cầu đơn giản nhất: bài gọi API đầu tiên.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.