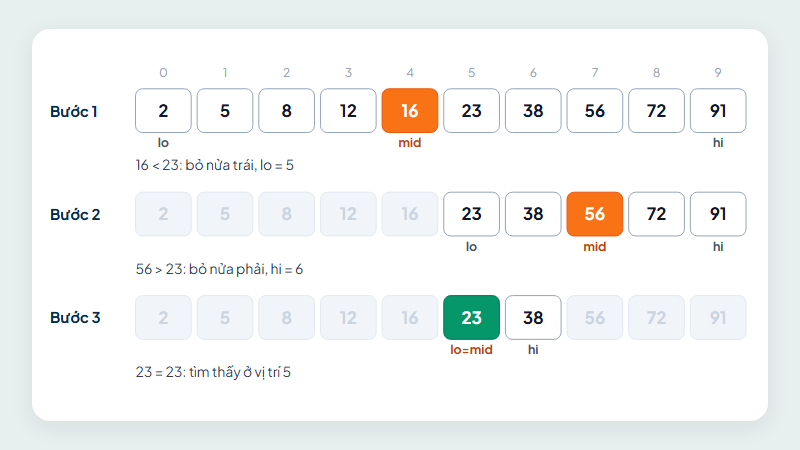
- Hoạt động trên mọi mảng bất kỳ (không cần sắp xếp trước) và trên cả danh sách liên kết với độ phức tạp thời gian O(n), bộ nhớ phụ O(1).
- Khi mảng chưa sắp xếp và bạn chỉ cần tìm 1 lần (hoặc dưới
log₂ nlần), tìm kiếm tuyến tínhO(n)nhanh hơn hẳn việc sắp xếpO(n log n)rồi mới tìm kiếm nhị phân. - Kỹ thuật lính canh (Sentinel Linear Search) đặt thêm
xvào cuối mảng để loại bỏ hoàn toàn phép kiểm tra biên ở mỗi bước lặp. - Mọi bài toán tìm vị trí đầu tiên, vị trí cuối cùng, hay tìm đồng thời giá trị lớn nhất và lớn thứ hai (
max1,max2) đều giải quyết gọn trong 1 vòng duyệt tuyến tính duy nhất.
Tìm kiếm tuyến tính (Linear Search) hoạt động như thế nào?
Khi một dãy dữ liệu chưa có thứ tự — chẳng hạn danh sách mã hóa đơn phát sinh trong ngày a = [14, 7, 25, 7, 9, 30] — ta không thể loại bỏ nửa trái hay nửa phải mảng. Cách duy nhất đảm bảo không bỏ sót đáp án là duyệt tuần tự (sequential scan):
- Bắt đầu từ phần tử đầu tiên ở chỉ số
i = 0. - So sánh
a[i]vớix: nếua[i] == xthì trả về ngay chỉ sối; nếu khác thì tăngilên1. - Nếu đi hết mảng (
i == n) mà chưa gặpx, kết luậnxkhông tồn tại và trả về-1.
Độ phức tạp của thuật toán:
- Tốt nhất — O(1):
a[0] == x, chỉ tốn1phép so sánh. - Xấu nhất và trung bình — O(n):
xnằm ở cuối mảng, không có trong mảng (tốnnlần so sánh), hoặc xuất hiện ngẫu nhiên (trung bình(n + 1) / 2lần so sánh).
Bài toán thực tế: Khi nào Tìm kiếm tuyến tính đánh bại Tìm kiếm nhị phân?
Một hiểu lầm rất phổ biến của người mới học là: “Vì Tìm kiếm nhị phân (Binary Search) chỉ mất O(log n) còn Tìm kiếm tuyến tính mất O(n), nên gặp bài tìm kiếm nào cũng nên sắp xếp mảng rồi tìm nhị phân cho nhanh!”
Hãy làm một phép tính chi phí thực tế khi mảng ban đầu chưa được sắp xếp và bạn cần thực hiện Q lần tra cứu:
- Phương án 1 — Dùng thẳng Tìm kiếm tuyến tính: Không tốn thời gian chuẩn bị. Với
Qlần tìm, tổng chi phí làO(Q · n). Đặc biệt nếu chỉ tìm 1 lần (Q = 1), chi phí chỉ làO(n). - Phương án 2 — Sắp xếp trước rồi mới Tìm kiếm nhị phân: Bước sắp xếp ban đầu bằng Quick Sort hoặc Merge Sort đã ngốn ngay
O(n log n)phép tính, sau đó mỗi truy vấn tốn thêmO(log n). Tổng chi phí làO((n + Q) log n).
Số lần tìm kiếm Q trên mảng n = 1.000.000 chưa sắp xếp |
Phương án 1: Tìm tuyến tính O(Q · n) |
Phương án 2: Sắp xếp + Nhị phân O((n + Q) log n) |
Phương án nào thắng? |
|---|---|---|---|
Chỉ tìm 1 lần (Q = 1) |
Tối đa 10⁶ bước (trung bình 5 × 10⁵ bước) |
Sắp xếp mất ≈ 2 × 10⁷ bước + tìm 20 bước |
Tìm tuyến tính nhanh gấp ~20 lần! |
Tìm 5 lần (Q = 5) |
Tối đa 5 × 10⁶ bước |
≈ 2 × 10⁷ bước |
Tìm tuyến tính vẫn nhanh hơn! |
Tìm 100.000 lần (Q = 10⁵) |
Tới 10¹¹ bước (Quá thời gian TLE) |
≈ 2.2 × 10⁷ bước (Chạy dưới 0.1 giây) |
Sắp xếp + Nhị phân thắng áp đảo! |
Như vậy, ngưỡng chuyển giao nằm ở khoảng Q ≈ log₂ n: nếu mảng chưa có thứ tự và bạn chỉ cần tìm kiếm một hoặc vài lần (hoặc mảng liên tục bị chèn/xóa phần tử), Tìm kiếm tuyến tính là lựa chọn tối ưu nhất vì cận dưới lý thuyết cho 1 lần tìm trên mảng chưa sắp xếp chính là Ω(n).
Ba biến thể quan trọng: Vị trí đầu, vị trí cuối và Kỹ thuật lính canh (Sentinel)
Khi mảng có nhiều phần tử trùng nhau (ví dụ a = [14, 7, 25, 7, 9, 30] có hai số 7 ở chỉ số 1 và 3), cách bạn điều khiển hướng duyệt sẽ quyết định vị trí nào được trả về:
1. Tìm vị trí xuất hiện đầu tiên và cuối cùng
- Vị trí xuất hiện đầu tiên (
tim_vi_tri_dau): Choichạy từ0tăng dần lênn - 1, gặpa[i] == xđầu tiên thìreturn ingay. - Vị trí xuất hiện cuối cùng (
tim_vi_tri_cuoi): Thay vì duyệt xuôi từ đầu đến hết mảng và lưu biến tạm, cách nhanh hơn là duyệt ngược từ cuối mảng (i = n - 1) về0vàreturn ingay lần đầu tiên gặpa[i] == x.
2. Kỹ thuật lính canh (Sentinel Linear Search) của Donald Knuth
Trong vòng lặp tìm kiếm tuyến tính thông thường từ 0 đến n - 1, ở mỗi bước lặp CPU phải thực hiện 2 phép so sánh nhánh:
- Kiểm tra điều kiện biên xem chỉ số
iđã chạm tớinhay chưa. - Kiểm tra giá trị
a[i] == xxem đã tìm thấyxchưa.
Nhà khoa học máy tính Donald Knuth (The Art of Computer Programming, Tập 3) chỉ ra cách cắt bỏ một nửa số phép so sánh này bằng kỹ thuật lính canh (Sentinel):
- Đặt thêm chính giá trị
xvào vị trí cuối cùnga[n]làm “lính canh”. - Vì chắc chắn vòng lặp sẽ gặp
x(chậm nhất tạia[n]), ta bỏ hẳn phép kiểm tra biên và chỉ viếtwhile (a[i] != x) ++i;. - Khi vòng lặp dừng ở chỉ số
i: nếuinhỏ hơnnthì trả vềi; nếui == n(đụng lính canh) thì trả về-1.
Dưới đây là code cài đặt cả 3 hàm bằng C++ và Python:
#include <iostream>
#include <vector>
using namespace std;

// 1. Tìm vị trí xuất hiện đầu tiên của x (trả về -1 nếu không có)
int tim_vi_tri_dau(const vector<int>& a, int x) {
    for (int i = 0; i < (int)a.size(); ++i) {
        if (a[i] == x) {
            return i;
        }
    }
    return -1;
}

// 2. Tìm vị trí xuất hiện cuối cùng của x (duyệt ngược từ cuối về đầu)
int tim_vi_tri_cuoi(const vector<int>& a, int x) {
    for (int i = (int)a.size() - 1; i >= 0; --i) {
        if (a[i] == x) {
            return i;
        }
    }
    return -1;
}

// 3. Kỹ thuật lính canh (Sentinel Linear Search): bỏ kiểm tra i < n trong vòng lặp
int tim_linh_canh(vector<int> a, int x) {
    int n = (int)a.size();
    a.push_back(x); // Đặt lính canh x ở vị trí a[n]
    int i = 0;
    while (a[i] != x) {
        ++i; // Chắc chắn dừng vì có lính canh ở cuối
    }
    return (i < n) ? i : -1;
}

int main() {
    vector<int> a = {14, 7, 25, 7, 9, 30};

    // Test 1: Phần tử 7 xuất hiện nhiều lần (đầu tiên ở 1, cuối cùng ở 3)
    cout << "Dau(7): " << tim_vi_tri_dau(a, 7)
         << " | Cuoi(7): " << tim_vi_tri_cuoi(a, 7)
         << " | LinhCanh(7): " << tim_linh_canh(a, 7) << "\n";

    // Test 2: Phần tử 30 nằm ở cuối mảng (chỉ số 5)
    cout << "Dau(30): " << tim_vi_tri_dau(a, 30)
         << " | Cuoi(30): " << tim_vi_tri_cuoi(a, 30)
         << " | LinhCanh(30): " << tim_linh_canh(a, 30) << "\n";

    // Test 3: Phần tử 99 không tồn tại trong mảng (trả về -1)
    cout << "Dau(99): " << tim_vi_tri_dau(a, 99)
         << " | Cuoi(99): " << tim_vi_tri_cuoi(a, 99)
         << " | LinhCanh(99): " << tim_linh_canh(a, 99) << "\n";

    return 0;
}
def tim_vi_tri_dau(a: list[int], x: int) -> int:
    """1. Tìm vị trí xuất hiện đầu tiên của x (trả về -1 nếu không có)."""
    for i, val in enumerate(a):
        if val == x:
            return i
    return -1


def tim_vi_tri_cuoi(a: list[int], x: int) -> int:
    """2. Tìm vị trí xuất hiện cuối cùng của x (duyệt ngược từ cuối về đầu)."""
    for i in range(len(a) - 1, -1, -1):
        if a[i] == x:
            return i
    return -1


def tim_linh_canh(mang_goc: list[int], x: int) -> int:
    """3. Kỹ thuật lính canh (Sentinel Linear Search): bỏ kiểm tra i < n trong vòng lặp."""
    a = mang_goc[:]
    n = len(a)
    a.append(x)  # Đặt lính canh x ở vị trí a[n]
    i = 0
    while a[i] != x:
        i += 1  # Chắc chắn dừng vì có lính canh ở cuối
    return i if i < n else -1


if __name__ == "__main__":
    a = [14, 7, 25, 7, 9, 30]

    # Test 1: Phần tử 7 xuất hiện nhiều lần (đầu tiên ở 1, cuối cùng ở 3)
    print(
        f"Dau(7): {tim_vi_tri_dau(a, 7)} | "
        f"Cuoi(7): {tim_vi_tri_cuoi(a, 7)} | "
        f"LinhCanh(7): {tim_linh_canh(a, 7)}"
    )

    # Test 2: Phần tử 30 nằm ở cuối mảng (chỉ số 5)
    print(
        f"Dau(30): {tim_vi_tri_dau(a, 30)} | "
        f"Cuoi(30): {tim_vi_tri_cuoi(a, 30)} | "
        f"LinhCanh(30): {tim_linh_canh(a, 30)}"
    )

    # Test 3: Phần tử 99 không tồn tại trong mảng (trả về -1)
    print(
        f"Dau(99): {tim_vi_tri_dau(a, 99)} | "
        f"Cuoi(99): {tim_vi_tri_cuoi(a, 99)} | "
        f"LinhCanh(99): {tim_linh_canh(a, 99)}"
    )
(Lưu ý: Trong C++ thực chiến, thư viện chuẩn cung cấp sẵn hàm std::find(a.begin(), a.end(), x) trả về iterator tới vị trí đầu tiên bằng x; còn trong Python bạn có thể dùng a.index(x) sau khi kiểm tra if x in a:).
Ứng dụng kinh điển: Tìm số lớn nhất và lớn thứ hai chỉ trong 1 vòng duyệt
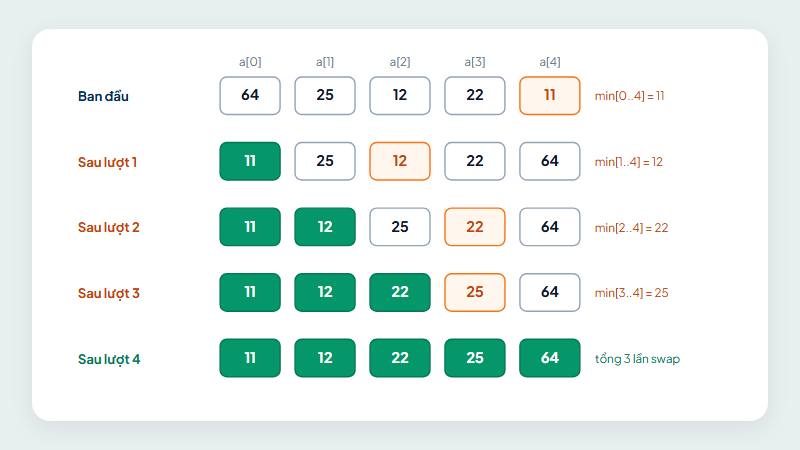
Tìm kiếm tuyến tính không chỉ dừng lại ở việc so khớp a[i] == x. Nó là khuôn mẫu cho mọi bài toán duyệt mảng một lượt (single-pass scan) để tìm phần tử cực trị thỏa mãn điều kiện, chẳng hạn như bước tìm min_idx bên trong Sắp xếp chọn (Selection Sort).
Một bài toán phỏng vấn và thi lập trình rất hay gặp là: “Cho mảng a gồm n số nguyên. Hãy tìm giá trị lớn nhất (max1) và giá trị lớn thứ hai phân biệt (max2) mà không được sắp xếp mảng và chỉ dùng đúng 1 vòng lặp.”
Để giải trong 1 lượt duyệt duy nhất, ta duy trì đồng thời hai biến max1 (nhà vô địch hiện tại) và max2 (á quân hiện tại). Khi xét đến phần tử val:
- Nếu
vallớn hơnmax1: Ta tìm thấy nhà vô địch mới! Trước khi cập nhậtmax1 = val, ta đẩy nhà vô địch cũ xuống làm á quân:max2 = max1;, rồi mới gánmax1 = val;. - Ngược lại, nếu
valnhỏ hơnmax1nhưng lớn hơnmax2: Phần tửvalkhông vượt qua đượcmax1(và cũng không bằngmax1), nhưng lại lớn hơn á quân hiện tại, nên ta cập nhậtmax2 = val;.
#include <climits>
#include <iostream>
#include <utility>
#include <vector>
using namespace std;

// Tìm giá trị lớn nhất (max1) và lớn thứ hai phân biệt (max2) chỉ trong 1 vòng duyệt
// Nếu không tồn tại max2 phân biệt, max2 giữ giá trị LLONG_MIN
pair<long long, long long> tim_hai_so_lon_nhat(const vector<long long>& a) {
    long long max1 = LLONG_MIN;
    long long max2 = LLONG_MIN;
    for (long long val : a) {
        if (val > max1) {
            max2 = max1; // Cựu vô địch lùi xuống làm á quân
            max1 = val;  // Tân vô địch mới
        } else if (val < max1 && val > max2) {
            max2 = val;  // Nhỏ hơn max1 nhưng vượt qua max2 hiện tại
        }
    }
    return {max1, max2};
}

void in_ket_qua(const vector<long long>& a) {
    auto [max1, max2] = tim_hai_so_lon_nhat(a);
    cout << "max1: " << max1 << " | max2: ";
    if (max2 == LLONG_MIN) cout << "NONE\n";
    else cout << max2 << "\n";
}

int main() {
    // Test 1: Mảng có giá trị lớn nhất lặp lại nhiều lần
    in_ket_qua({12, 35, 1, 10, 35, 34}); // max1: 35 | max2: 34

    // Test 2: Mảng số âm
    in_ket_qua({-10, -3, -25, -7});      // max1: -3 | max2: -7

    // Test 3: Mọi phần tử bằng nhau -> không có giá trị lớn thứ hai phân biệt
    in_ket_qua({8, 8, 8});               // max1: 8 | max2: NONE

    return 0;
}
def tim_hai_so_lon_nhat(a: list[int]) -> tuple[int | None, int | None]:
    """Tìm giá trị lớn nhất (max1) và lớn thứ hai phân biệt (max2) chỉ trong 1 vòng duyệt."""
    max1: int | None = None
    max2: int | None = None
    for val in a:
        if max1 is None or val > max1:
            max2 = max1  # Cựu vô địch lùi xuống làm á quân
            max1 = val   # Tân vô địch mới
        elif val < max1 and (max2 is None or val > max2):
            max2 = val   # Nhỏ hơn max1 nhưng vượt qua max2 hiện tại
    return max1, max2


def in_ket_qua(a: list[int]) -> None:
    max1, max2 = tim_hai_so_lon_nhat(a)
    print(f"max1: {max1} | max2: {'NONE' if max2 is None else max2}")


if __name__ == "__main__":
    # Test 1: Mảng có giá trị lớn nhất lặp lại nhiều lần
    in_ket_qua([12, 35, 1, 10, 35, 34])  # max1: 35 | max2: 34

    # Test 2: Mảng số âm
    in_ket_qua([-10, -3, -25, -7])       # max1: -3 | max2: -7

    # Test 3: Mọi phần tử bằng nhau -> không có giá trị lớn thứ hai phân biệt
    in_ket_qua([8, 8, 8])                # max1: 8 | max2: NONE
Cách 1 vòng duyệt chỉ mất O(n) thời gian và O(1) bộ nhớ, đồng thời xử lý đúng cả khi giá trị lớn nhất lặp lại nhiều lần ([12, 35, 1, 10, 35, 34] ra max1 = 35, max2 = 34) lẫn khi mọi phần tử bằng nhau ([8, 8, 8] báo NONE).
Lỗi hay gặp khi viết Tìm kiếm tuyến tính
- Viết
else return -1;ngay bên trong vòng lặpfor. Nếu đặtreturn -1trong nhánhelsecủa câu lệnhif (a[i] == x), hàm sẽ chỉ kiểm tra duy nhất phần tử đầu tiêna[0]rồi thoát ngay lập tức! Lệnhreturn -1bắt buộc phải nằm ở bên ngoài, phía sau vòng lặpfor, khi mọi phần tử từ0đếnn - 1đều đã được kiểm tra mà không khớp. - Khởi tạo
max_val = 0khi tìm giá trị lớn nhất trong mảng. Nếu đề bài cho mảng chứa toàn số âm (ví dụ[-10, -3, -25, -7]), việc khởi tạomax_val = 0sẽ khiến chương trình in ra kết quả sai là0(một con số không hề có trong mảng!). Hãy luôn khởi tạo bằng phần tử đầu tiêna[0], hoặc bằng hằng số âm vô cùng (LLONG_MIN/INT_MINtrong C++,Nonehoặc-math.inftrong Python). - Gọi thẳng
a.index(x)trong Python mà không kiểm tra trước. Phương thứclist.index(x)của Python sẽ ném ngoại lệValueError: x is not in listvà làm dừng chương trình nếuxkhông tồn tại. Hãy kiểm traif x in a:trước khi gọi.
Luyện ngay trên Big-O Coding
Thực hành ngay các bài toán duyệt mảng tuyến tính, tìm cực trị và đếm điều kiện trên hệ thống Big-O Coding:
Câu hỏi thường gặp
Nếu mảng đã được sắp xếp tăng dần nhưng vẫn dùng Tìm kiếm tuyến tính thì có dừng sớm được không?
Có. Khi mảng đã tăng dần, trong lúc duyệt từ trái sang phải để tìm x, ngay khi gặp phần tử a[i] lớn hơn x, bạn có thể break và kết luận ngay x không tồn tại trong mảng mà không cần đi hết phần còn lại. Tuy nhiên, trên mảng đã sắp xếp bạn nên dùng Tìm kiếm nhị phân để đạt O(log n).
Tìm kiếm tuyến tính có dùng được trên Danh sách liên kết (Linked List) không?
Có, và đây là ưu thế lớn của Tìm kiếm tuyến tính. Trên danh sách liên kết đơn, ta không thể nhảy thẳng tới phần tử ở giữa a[mid] trong O(1) nên Tìm kiếm nhị phân không hoạt động hiệu quả, trong khi Tìm kiếm tuyến tính vẫn chạy tự nhiên qua từng nút với độ phức tạp O(n).
Muốn liệt kê tất cả các vị trí xuất hiện của x trong mảng thì làm thế nào?
Thay vì return i ngay lần đầu gặp a[i] == x, bạn tạo một mảng kết quả vi_tri rỗng, duyệt i từ 0 đến n - 1, mỗi khi thấy a[i] == x thì thêm i vào vi_tri (push_back trong C++ hoặc append trong Python).
Khóa Green cho người mới, sinh viên năm 1–2: xây nền tảng lập trình và thuật toán vững chắc, biết dùng AI hỗ trợ. 16 buổi online, học thử buổi 1 miễn phí.