- Cả
std::vector(C++) vàlist(Python) đều là mảng động (Dynamic Array) lưu dữ liệu trên các ô nhớ liên tiếp, cho phép truy cập phần tử bất kỳa[i]trong O(1). - Nhờ cơ chế tăng dung lượng theo cấp số nhân khi cần, thao tác thêm vào cuối
push_back()/append()có độ phức tạp trung bình khấu hao (amortized) là O(1). - Ngược lại, việc chèn (
insert) hoặc xóa (erase/pop(i)) ở đầu hay giữa mảng phải dồn toàn bộ các phần tử phía sau nên tốn O(n). - Trong C++, khi truyền
vectorvào hàm, nên truyền theo tham chiếu nếu không cần bản sao (const vector<int>& ahoặcvector<int>& a); nếu viếtvector<int> asẽ bị chép lại toàn bộ mảng mấtO(n)ở mỗi lần gọi hàm!
Bản chất Mảng động (Dynamic Array): Phân biệt size và capacity
Trong ngôn ngữ C truyền thống, khi khai báo một mảng tĩnh như int a[100];, kích thước của mảng bị khóa cứng ngay từ lúc biên dịch. Nếu dữ liệu thực tế có 100.000 phần tử thì mảng bị tràn, còn nếu chỉ có 5 phần tử thì 95 ô nhớ còn lại bị bỏ phí.
Để giải quyết bài toán đó, std::vector trong C++ (thuộc thư viện <vector>) và list trong Python sử dụng cấu trúc mảng động (Dynamic Array). Bên trong mỗi đối tượng vector luôn quản lý 3 thông tin cốt lõi:
- Con trỏ
data: Trỏ tới địa chỉ ô nhớ đầu tiên của vùng nhớ liên tiếp trên bộ nhớ Heap. - Kích thước thực tế (
size): Số lượng phần tử đang thực sự có mặt trong mảng (lấy bằnga.size()trong C++ hoặclen(a)trong Python). - Dung lượng đã cấp phát (
capacity): Tổng số ô nhớ màvectorđã xin hệ điều hành đặt chỗ trước (lấy bằnga.capacity()trong C++). Ta luôn có bất đẳng thức:size <= capacity(capacity >= size).
Chừng nào size < capacity (capacity > size), vùng nhớ đặt trước vẫn còn các ô trống ở cuối. Lúc này, khi bạn gọi a.push_back(x) (C++) hoặc a.append(x) (Python), chương trình chỉ việc ghi thẳng giá trị x vào ô trống ngay tại chỉ số a[size] rồi tăng size lên 1 — thao tác này tốn đúng O(1)!
Vì sao push_back có lúc phải chép lại mảng O(n) nhưng trung bình vẫn là O(1)?
Câu hỏi thú vị nhất trong các buổi phỏng vấn là: "Điều gì xảy ra khi mảng đã đầy khít (size == capacity) mà ta vẫn gọi tiếp push_back(x)?"
Vì các ô nhớ của mảng động bắt buộc phải nằm liền kề nhau mà vùng nhớ ngay phía sau có thể đã bị biến khác chiếm chỗ, vector không thể chỉ xin thêm 1 ô lẻ tẻ. Thay vào đó, nó thực hiện quy trình tăng dung lượng; dưới đây chọn mô hình nhân đôi để dễ chứng minh:
- Trong mô hình minh họa, xin vùng mới với
new_capacity = max(1, capacity * 2). Chuẩn C++ không ấn định hệ số tăng củavector; CPython cũng có chính sách cấp dư riêng. Các mốc 1, 2, 4, 8 ở hình và code không phải cam kết của mọi thư viện. - Sao chép toàn bộ
sizephần tử từ vùng nhớ cũ sang vùng nhớ mới, rồi thêm phần tử mớixvào tiếp theo. - Giải phóng vùng nhớ cũ.
Nghe qua, bước sao chép toàn bộ mảng cũ tốn tới O(n) thao tác! Vậy tại sao người ta vẫn khẳng định push_back() có độ phức tạp thuật toán là O(1)?
Hãy cộng tổng số lần sao chép khi ta thêm liên tiếp n phần tử từ đầu (giả sử capacity khởi đầu bằng 1 và nhân đôi ở các mốc lũy thừa của 2 là 1, 2, 4, 8, ..., 2ᵏ < n):
\[\begin{aligned}
& \text{Tổng số lần chép phần tử cũ} \\
&= 1 + 2 + 4 + 8 + \dots + 2^k \\
&= 2^{k + 1} - 1 < 2n
\end{aligned}\]
Như vậy, trong suốt quá trình thực hiện n lệnh push_back, tổng công sức (bao gồm n lần ghi phần tử mới cộng với chưa tới 2n lần chép phần tử cũ khi mở rộng mảng) luôn nhỏ hơn 3n thao tác! Chia đều tổng chi phí < 3n đó cho n lần gọi hàm (phương pháp này gọi là phân tích khấu hao — Amortized Analysis), mỗi lệnh push_back() trung bình chỉ tốn chưa tới 3 thao tác, tức là O(1) khấu hao (Amortized O(1))!
Hãy chạy đoạn code mô phỏng quá trình nhân đôi capacity và đếm số lần sao chép dưới đây:
#include <iostream>
#include <vector>
using namespace std;

// Mô phỏng cơ chế nhân đôi capacity của mảng động khi thêm n phần tử
void moPhongNhanDoi(int n) {
    int sz = 0, cap = 1, tongSaoChep = 0;
    for (int i = 1; i <= n; i++) {
        if (sz == cap) {
            cap *= 2;           // cấp phát vùng nhớ mới gấp đôi
            tongSaoChep += sz;  // chép toàn bộ sz phần tử cũ sang vùng nhớ mới
        }
        sz++;
        cout << "push(" << i << ")->" << sz << "/" << cap << " ";
    }
    cout << "| tong_chep=" << tongSaoChep << "\n";
}

int main() {
    moPhongNhanDoi(5);
    // push(1)->1/1 push(2)->2/2 push(3)->3/4 push(4)->4/4 push(5)->5/8 | tong_chep=7
    return 0;
}
def mo_phong_nhan_doi(n):
    """Mô phỏng cơ chế nhân đôi capacity của mảng động khi thêm n phần tử."""
    sz, cap, tong_sao_chep = 0, 1, 0
    buoc = []
    for i in range(1, n + 1):
        if sz == cap:
            cap *= 2            # cấp phát vùng nhớ mới gấp đôi
            tong_sao_chep += sz # chép toàn bộ sz phần tử cũ sang vùng nhớ mới
        sz += 1
        buoc.append(f"push({i})->{sz}/{cap}")
    return buoc, tong_sao_chep


buoc, tong = mo_phong_nhan_doi(5)
print(*buoc, f"| tong_chep={tong}")
# push(1)->1/1 push(2)->2/2 push(3)->3/4 push(4)->4/4 push(5)->5/8 | tong_chep=7
Bảng độ phức tạp các thao tác trên vector (C++) và list (Python)
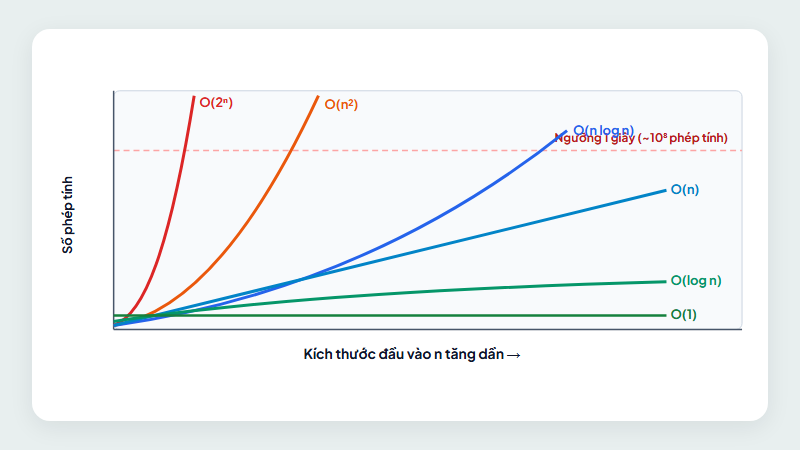
Vì các phần tử nằm sát cạnh nhau trong bộ nhớ, mọi thao tác ở cuối mảng hoặc truy cập theo chỉ số đều cực nhanh (O(1)), nhưng mọi thao tác chèn hoặc xóa ở đầu / giữa mảng đều chậm (O(n)) vì phải dịch chuyển các phần tử đứng sau:
| Thao tác | Cú pháp C++ (vector<T> a) |
Cú pháp Python (a = []) |
Độ phức tạp | Lý do kỹ thuật |
|---|---|---|---|---|
Truy cập phần tử thứ i |
a[i] hoặc a.at(i) |
a[i] |
O(1) | Tính thẳng địa chỉ ô nhớ data + i |
| Lấy số phần tử hiện có | a.size() |
len(a) |
O(1) | Đọc trực tiếp biến thành viên size |
| Thêm 1 phần tử vào cuối | a.push_back(x) |
a.append(x) |
O(1) khấu hao | Cấp phát dư và chỉ mở rộng khi cần; hệ số tùy cài đặt |
| Xóa 1 phần tử ở cuối | a.pop_back() |
a.pop() |
O(1) trong C++; O(1) khấu hao với CPython | Python có thể thu hẹp vùng chứa; giả định chi phí hủy phần tử là hằng số |
Chèn vào vị trí i bất kỳ |
a.insert(a.begin() + i, x) |
a.insert(i, x) |
O(n) | Phải đẩy n - i phần tử phía sau sang phải 1 ô |
Xóa phần tử tại vị trí i |
a.erase(a.begin() + i) |
a.pop(i) hoặc del a[i] |
O(n) | Phải kéo n - i - 1 phần tử phía sau sang trái 1 ô |
Tìm kiếm tuần tự giá trị x |
find(a.begin(), a.end(), x) |
x in a hoặc a.index(x) |
O(n) | Phải quét qua từng phần tử từ đầu mảng |
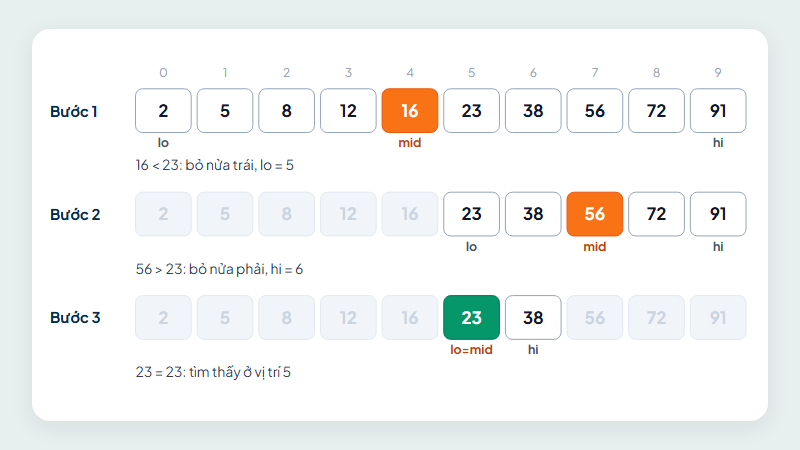
Mẹo xóa phần tử ở giữa mảng trong O(1): Nếu bài toán chỉ coi vector là một túi chứa các phần tử mà không quan trọng thứ tự đứng trước – sau, khi muốn xóa phần tử a[i], bạn đừng gọi a.erase(a.begin() + i) mất O(n). Hãy ghi đè phần tử cuối cùng lên a[i] rồi xóa phần tử cuối: a[i] = a.back(); a.pop_back(); — tốn đúng O(1)! Còn nếu mảng đã được sắp xếp, bạn có thể kết hợp với tìm kiếm nhị phân để tra cứu trong O(log n).
Cảnh báo lỗi TLE kinh điển nhất trong C++: Truyền vector theo giá trị
Khi chuyển từ mảng tĩnh hoặc từ Python sang C++ (xem thêm bài nên học Python hay C++), có một cái bẫy khiến hàng nghìn thí sinh bị Quá thời gian (Time Limit Exceeded — TLE) dù thuật toán hoàn toàn đúng:
- Trong Python: Khi bạn viết
def xu_ly(a):, Python luôn truyền tham chiếu tới đối tượng danh sách (chi phí truyền làO(1)), không hề tạo ra bản sao của danh sách. - Trong C++: Mặc định mọi tham số hàm đều được truyền theo giá trị (pass-by-value)! Nếu bạn viết:
Ví dụ
int kiemTra(vector<int> a, int i) { return a[i] > 0; }nhận bản sao khi gọi với một vector lvalue; ví dụ chạy được để so sánh cách truyền nằm trong khối code bên dưới. Mỗi một lần hàmkiemTra(a, i)được gọi, C++ sẽ xin cấp phát vùng nhớ mới và chép lại toàn bộnphần tử củaasang một bản sao mới tinh rồi mới chạy hàm! Nếu hàm này nằm trong một vòng lặp chạynlần hoặc trong hàm đệ quy tìm kiếm nhị phân, n lần gọi với một vector dài n có thể tốnO(n²)cho sao chép;O(log n)lần gọi với cùng vector dài n có thể tốnO(n log n). Truyền theo giá trị vẫn hợp lý khi thực sự cần sở hữu bản sao hoặc dùng ngữ nghĩa di chuyển.
Quy tắc bắt buộc khi viết hàm nhận vector trong C++:
- Nếu hàm chỉ đọc dữ liệu mà không sửa mảng: luôn viết
const vector<int>& a(truyền tham chiếu hằng — tốnO(1)và an toàn tuyệt đối). - Nếu hàm cần sửa trực tiếp các phần tử của mảng gốc: luôn viết
vector<int>& a(truyền tham chiếu). - Chỉ viết
vector<int> a(không có dấu&) khi bạn thực sự cố tình muốn tạo một bản sao độc lập để chỉnh sửa nháp mà không làm hỏng mảng gốc.
Ngoài ra, nếu biết trước sẽ thêm khoảng n phần tử vào vector, hãy gọi a.reserve(n); trước vòng lặp để đặt trước vùng nhớ một lần duy nhất, tránh hoàn toàn chi phí nhân đôi và chép lại mảng trung gian!
#include <iostream>
#include <vector>
using namespace std;

// ĐÚNG: Truyền tham chiếu hằng (const&) để chỉ đọc, không tốn O(n) sao chép mảng
long long tinhTong(const vector<int>& a) {
    long long s = 0;
    for (int x : a) s += x;
    return s;
}

// ĐÚNG: Truyền tham chiếu (&) khi cần sửa trực tiếp trên vector gốc
void xoaViTriKhongCanThuTu(vector<int>& a, size_t idx) {
    a[idx] = a.back();  // ghi đè bằng phần tử cuối trong O(1)
    a.pop_back();       // xóa phần tử cuối trong O(1)
}

int main() {
    vector<int> a;
    a.reserve(5);  // đặt trước vùng nhớ cho 5 phần tử để tránh cấp phát lại
    for (int x : {10, 20, 30, 40, 50}) {
        a.push_back(x);
    }
    cout << tinhTong(a) << "\n";  // 150

    // Xóa phần tử ở chỉ số 1 (giá trị 20) trong O(1) bằng mẹo đổi với phần tử cuối
    xoaViTriKhongCanThuTu(a, 1);
    for (size_t i = 0; i < a.size(); i++) {
        cout << a[i] << (i + 1 == a.size() ? "\n" : " ");
    }  // 10 50 30 40
    return 0;
}
def tinh_tong(a):
    """Trong Python, truyền danh sách vào hàm luôn là truyền tham chiếu đối tượng O(1)."""
    return sum(a)


def xoa_vi_tri_khong_can_thu_tu(a, idx):
    """Xóa phần tử ở vị trí idx trong O(1) khi không cần giữ thứ tự ban đầu."""
    a[idx] = a[-1]
    a.pop()


a = []
for x in (10, 20, 30, 40, 50):
    a.append(x)
print(tinh_tong(a))  # 150

xoa_vi_tri_khong_can_thu_tu(a, 1)
print(*a)            # 10 50 30 40
Lỗi hay gặp
- Nhầm lẫn giữa
a.reserve(n)vàa.resize(n)trong C++.a.reserve(n)chỉ đặt chỗ trước dung lượngcapacity >= nnhưnga.size()vẫn bằng0(truy cậpa[0]lúc này là lỗi truy cập vùng nhớ chưa khởi tạo!). Ngược lại,a.resize(n)vừa cấp phát bộ nhớ vừa tạo sẵnnphần tử có giá trị0(a.size() == n), nếu sau đó bạn lại gọi tiếpa.push_back(x)thì phần tửxsẽ nằm ở vị trín(thànhn + 1phần tử)! - Dùng
a.pop(0)liên tục trong Python để làm hàng đợi (Queue). Vìlistlà mảng động, mỗi lệnha.pop(0)phải dồn toàn bộn - 1phần tử còn lại sang trái một ô mất O(n). Lặpnlầna.pop(0)sẽ tốnO(n²)! Khi cần lấy phần tử ở đầu danh sách trongO(1), hãy dùngcollections.dequetrong Python hoặcstd::deque/std::queuetrong C++. - Lưu con trỏ hoặc iterator trỏ vào phần tử của
vectorrồi gọipush_back. Khipush_backlàmsizevượt quácapacity,vectorsẽ chuyển nhà sang vùng nhớ mới và giải phóng vùng nhớ cũ (iterator invalidation), làm mọi con trỏ hay iterator lấy trước đó bị treo (dangling pointer).
Luyện ngay trên Big-O Coding
Thực hành thao tác mảng động với vector (C++) và list (Python) qua các bài tập trên hệ thống Big-O Coding:
Câu hỏi thường gặp
Sau khi gọi a.clear() trong C++, bộ nhớ capacity của vector có được trả lại cho hệ điều hành không?
Không! Lệnh a.clear() chỉ đưa a.size() về 0 nhưng vẫn giữ nguyên a.capacity() để tránh phải cấp phát lại khi thêm phần tử mới. a.shrink_to_fit() chỉ là yêu cầu không ràng buộc để giảm capacity; thư viện có thể không thực hiện. Giải phóng vùng cấp phát cũng không bảo đảm hệ điều hành nhận lại RAM ngay.
Sự khác nhau cơ bản giữa vector<int> của C++ và list của Python trong bộ nhớ là gì?
std::vector<int> lưu trực tiếp các giá trị int (thường 32-bit trên môi trường phổ biến) nằm liền kề nhau trong một khối nhớ duy nhất, rất tiết kiệm RAM và thân thiện với bộ nhớ đệm CPU. Ngược lại, list của Python lưu mảng các con trỏ trỏ tới các đối tượng PyObject trên Heap nên linh hoạt hơn nhưng tốn bộ nhớ hơn.
Khi nào nên dùng a[i] và khi nào nên dùng a.at(i) trong C++?
Toán tử a[i] không kiểm tra tràn chỉ số nên chạy nhanh nhất; còn a.at(i) kiểm tra điều kiện i < a.size() (a.size() > i) và ném ngoại lệ std::out_of_range nếu vượt biên, rất hữu ích khi gỡ lỗi.
Khóa Green cho người mới, sinh viên năm 1–2: xây nền tảng lập trình và thuật toán vững chắc, biết dùng AI hỗ trợ. 16 buổi online, học thử buổi 1 miễn phí.