- Phạm vi ASCII của bài: Các ký tự ASCII sau có mã số nguyên cố định: chữ số
'0'..'9'là48..57, chữ hoa'A'..'Z'là65..90, chữ thường'a'..'z'là97..122. - Mẹo ánh xạ chỉ số
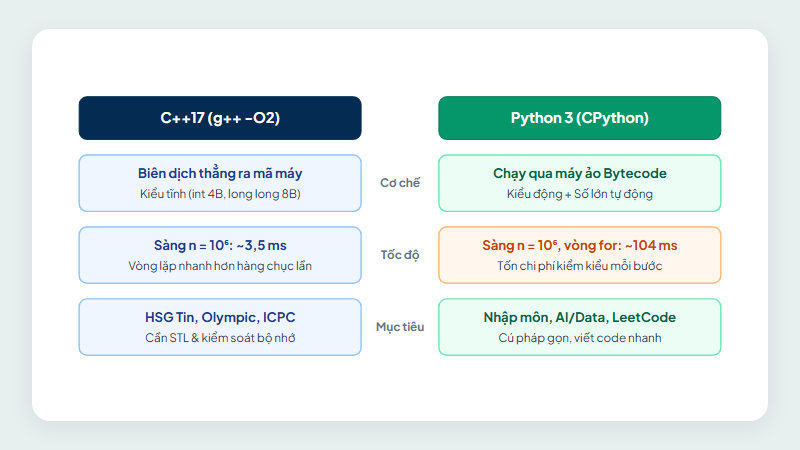
O(1): Lấych - 'a'(hoặcord(ch) - ord('a')trong Python) sẽ đổi chữ cái'a'..'z'thành chỉ số mảng0..25, giúp đếm tần suất xuất hiện trong thời gian tuyến tính O(n). - Khác biệt cốt lõi C++ và Python:
std::stringcủa C++ thay đổi được tại chỗ (mutable), cònstrcủa Python bất biến (immutable) — khi ghép nhiều mảnh xâu trong Python hãy gom vàolistrồi dùng"".join(). - Chống trôi lệnh trong C++: Khi dùng
cin >> ntrướcgetline(cin, s), cần bỏ phần còn lại của dòng trước;getline(cin >> ws, s)chỉ phù hợp nếu không cần giữ dòng trống và khoảng trắng đầu dòng.
Bản chất xâu ký tự và 3 mốc vàng trong bảng mã ASCII
Bài này dùng đầu vào ASCII. std::string lưu các đơn vị char (thường là byte), còn Python str là dãy mã Unicode. Với tiếng Việt UTF-8, một ký tự có thể chiếm nhiều byte trong C++, nên không áp dụng trực tiếp mảng 26 ô hay phép trừ ch - 'a'. Máy tính không lưu trực tiếp hình dáng chữ cái 'A' hay 'a' trong bộ nhớ, mà lưu mã số nguyên của chúng theo bảng mã ASCII. Bạn không cần học thuộc lòng cả bảng 128 ký tự, chỉ cần nhớ 3 dải liên tiếp sau đây:
| Nhóm ký tự | Ký tự đầu → cuối | Mã thập phân ASCII | Công thức quy đổi sang số 0..k |
Công thức đổi ngược từ số sang ký tự |
|---|---|---|---|---|
| Chữ số | '0' → '9' |
48 → 57 (10 số) |
d = ch - '0' (0..9) |
ch = '0' + d |
| Chữ cái in hoa | 'A' → 'Z' |
65 → 90 (26 chữ) |
idx = ch - 'A' (0..25) |
ch = 'A' + idx |
| Chữ cái in thường | 'a' → 'z' |
97 → 122 (26 chữ) |
idx = ch - 'a' (0..25) |
ch = 'a' + idx |
Nhờ các chữ cái cùng loại nằm liền kề nhau trong bảng ASCII, khoảng cách giữa chữ hoa và chữ thường tương ứng luôn cố định bằng 97 - 65 = 32 (tức 'a' - 'A' == 32).
- Trong C++: Kiểu
charbản chất là một số nguyên 1 byte, nên bạn cộng trừ trực tiếp nhưint idx = ch - 'a';hoặc đổi chữ hoa'C'sang chữ thường bằng'C' - 'A' + 'a'. - Trong Python: Ký tự vẫn là một xâu độ dài
1, nên bạn dùng hàmord(ch)để lấy mã Unicode (trùng với ASCII trong phạm vi 0..127; ví dụord('a') == 97) và hàmchr(ma_so)để đổi ngược mã số về ký tự (ví dụchr(97) == 'a').
Mẹo ánh xạ ch - 'a' để đếm tần suất ký tự trong O(n)
Một bài toán xuất hiện liên tục trong các đề thi và phỏng vấn là: "Cho xâu s gồm các chữ cái in thường, hãy đếm số lần xuất hiện của từng chữ cái, tìm chữ cái xuất hiện nhiều nhất và tìm ký tự đầu tiên chỉ xuất hiện đúng 1 lần".
Nếu dùng hai vòng lặp lồng nhau (với mỗi ký tự lại chạy một vòng lặp đếm từ đầu tới cuối xâu), bạn sẽ mất O(n²) bước — quá chậm khi độ dài xâu n = 10⁵.
Thay vào đó, ta tạo một mảng cố định dem[26] gồm 26 ô (ban đầu bằng 0), trong đó ô dem[0] dành cho 'a', dem[1] dành cho 'b'... và dem[25] dành cho 'z':
Với xâu s = "abracadabra" (dài 11 ký tự):
- Duyệt một lượt từ đầu đến cuối xâu, gặp ký tự
chnào thì tăng ôdem[ch - 'a']lên1. Sau đúng 11 bước, mảng tần suất ghi nhận:'a': 5,'b': 2,'c': 1,'d': 1,'r': 2(các chữ cái khác bằng0). - Quét qua 26 ô của
dem[0..25], ta biết ngay chữ cái xuất hiện nhiều nhất là'a'(5lần). - Để tìm ký tự đầu tiên trong xâu chỉ xuất hiện đúng 1 lần, ta duyệt lại chỉ số
itừ0đếnn - 1trên xâusvà kiểm tra xemdem[s[i] - 'a'] == 1hay không. Tạii = 4(s[4] = 'c'), vìdem['c' - 'a'] == 1, ta trả về ngay'c'ở vị trí4(dù'd'cũng xuất hiện 1 lần nhưng đứng sau ở vị trí6).
#include <iostream>
#include <string>
#include <vector>

using namespace std;

// Đếm tần suất 26 chữ cái thường bằng ánh xạ chỉ số ch - 'a' trong O(n)
void phan_tich_tan_suat(const string& s) {
    vector<int> dem(26, 0);
    for (char ch : s) {
        if (ch >= 'a' && ch <= 'z') {
            ++dem[ch - 'a'];
        }
    }

    // 1. Tìm chữ cái xuất hiện nhiều nhất (ưu tiên chữ cái nhỏ hơn nếu bằng nhau)
    int max_lan = -1;
    char ky_tu_max = 'a';
    for (int i = 0; i < 26; ++i) {
        if (dem[i] > max_lan) {
            max_lan = dem[i];
            ky_tu_max = static_cast<char>('a' + i);
        }
    }

    // 2. Tìm ký tự đầu tiên trong xâu chỉ xuất hiện đúng 1 lần
    char duy_nhat_dau = '-';
    int vi_tri_dau = -1;
    for (int i = 0; i < static_cast<int>(s.size()); ++i) {
        if (dem[s[i] - 'a'] == 1) {
            duy_nhat_dau = s[i];
            vi_tri_dau = i;
            break;
        }
    }

    // Với "abracadabra": 'a' xuất hiện 5 lần; ký tự đơn lẻ đầu tiên là 'c' ở vị trí 4
    cout << ky_tu_max << " " << max_lan << " " << duy_nhat_dau << " " << vi_tri_dau << "\n";
}

int main() {
    phan_tich_tan_suat("abracadabra");
    return 0;
}
def phan_tich_tan_suat(s: str) -> tuple[str, int, str, int]:
    """Đếm tần suất 26 chữ cái thường bằng mảng kích thước 26 trong O(n)."""
    dem = [0] * 26
    base = ord("a")
    for ch in s:
        if "a" <= ch <= "z":
            dem[ord(ch) - base] += 1

    # 1. Tìm chữ cái xuất hiện nhiều nhất (ưu tiên thứ tự từ điển nhỏ hơn)
    max_lan = -1
    ky_tu_max = "a"
    for i in range(26):
        if dem[i] > max_lan:
            max_lan = dem[i]
            ky_tu_max = chr(base + i)

    # 2. Tìm ký tự đầu tiên trong xâu chỉ xuất hiện đúng 1 lần
    duy_nhat_dau = "-"
    vi_tri_dau = -1
    for i, ch in enumerate(s):
        if dem[ord(ch) - base] == 1:
            duy_nhat_dau = ch
            vi_tri_dau = i
            break

    return ky_tu_max, max_lan, duy_nhat_dau, vi_tri_dau


if __name__ == "__main__":
    kt_max, sl_max, kt_dn, vt_dn = phan_tich_tan_suat("abracadabra")
    print(kt_max, sl_max, kt_dn, vt_dn)
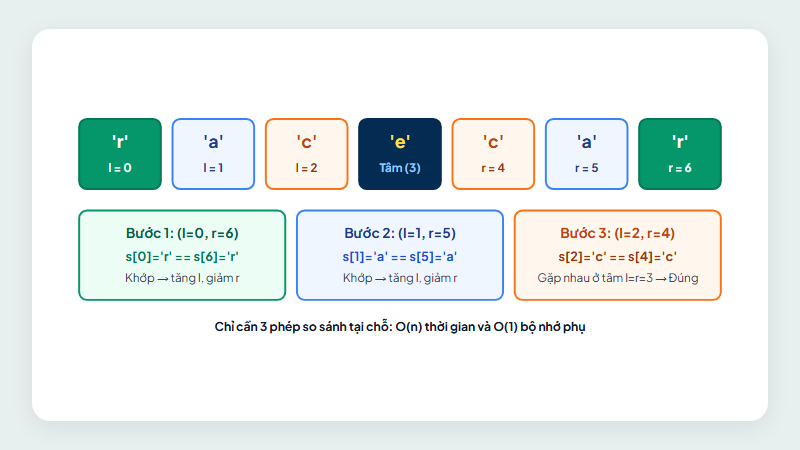
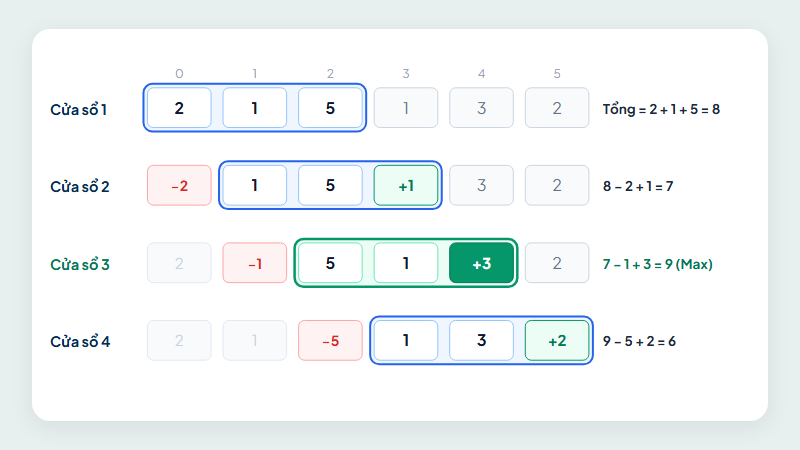
Cả hai chương trình đều chạy trong thời gian tuyến tính O(n), tốn bộ nhớ O(1) (đúng 26 ô nguyên) và in ra kết quả a 5 c 4. Kỹ thuật mảng tần suất 26 phần tử này cũng chính là chìa khóa để giải các bài toán cửa sổ trượt trên xâu và kiểm tra đảo chữ trong bài xâu đối xứng Palindrome.
Sự khác biệt sống còn: C++ mutable và Python immutable
Khi chuyển đổi giữa C++ và Python, khác biệt lớn nhất về hiệu năng xử lý xâu nằm ở tính khả biến (mutable):
- Trong C++ (
std::stringlà Mutable — Thay đổi tại chỗ): Bạn có thể gán trực tiếps[0] = 'B';trong thời gianO(1), và nối thêm một ký tự vào cuối xâu bằngs += ch;hoặcs.push_back(ch);có chi phí khấu haoO(1)(nhờ cơ chế tăng dung lượng bộ đệm; hệ số tăng phụ thuộc thư viện). - Trong Python (
strlà Immutable — Bất biến tuyệt đối): Một khi xâusđã được tạo ra, bạn không thể sửas[0] = 'B'(Python sẽ báo lỗiTypeError: 'str' object does not support item assignment). Nguy hiểm hơn, nếu bạn viết vòng lặp nối từng ký tự kiểu:ket_qua = ""rồi lặpnlầnket_qua = ket_qua + ch, việc nối có thể phải chép lại tiền tố nhiều lần và dẫn tớiO(n²). CPython có tối ưu một số trường hợp, nhưng không nên dựa vào tối ưu đó cho mọi cách viết hay mọi bản Python. Cách viết chuẩn trong Python: Gom các ký tự hoặc các từ vào một danh sáchcac_phan = []bằngcac_phan.append(ch), sau khi kết thúc vòng lặp mới gọi"".join(cac_phan)một lần duy nhất để nối trongO(n).
Chủ đề này nằm trong Lecture 07: String (Chuỗi ký tự) của Khóa Green. Xem đề cương
Cảnh báo lỗi "trôi lệnh" khi dùng cin >> và getline() trong C++
Trong các bài tập xử lý xâu có khoảng trắng, đề bài thường cho số dòng n ở dòng đầu, theo sau là n dòng văn bản. Nếu bạn viết cin >> n; rồi gọi ngay getline(cin, s);, dòng đầu tiên đọc vào s sẽ bị rỗng ("")!
Nguyên nhân:
- Toán tử
cin >> nchỉ đọc các chữ số củanvà bỏ lại ký tự xuống dòng'\n'(phím Enter) nằm ngay trong bộ đệm bàn phím. - Ngay sau đó, hàm
getline(cin, s)đọc từ vị trí hiện tại cho tới khi gặp'\n'. Vì thấy ngay ký tự'\n'còn sót lại của dòng trước,getlinetưởng rằng đã hết dòng nên dừng ngay lập tức và trả về xâu rỗng!
Hai cách khắc phục triệt để trong C++:
- Cách 1: Gọi
cin.ignore(numeric_limits<streamsize>::max(), '\n');saucin >> n;và thêm<limits>. Cách này bỏ hết phần còn lại của dòng, kể cả khi sau số còn dấu cách.cin.ignore()không đối số chỉ bỏ một ký tự, nên chỉ đủ khi ký tự tiếp theo đúng là xuống dòng. - Cách 2 (chỉ dùng khi không cần giữ dòng rỗng hoặc khoảng trắng đầu dòng): Dùng bộ lọc khoảng trắng đầu dòng
getline(cin >> ws, s);.
Các thao tác tách từ, cộng chữ số và cắt xâu con
Bảng dưới đây đối chiếu các thao tác xử lý xâu thông dụng nhất giữa hai ngôn ngữ (độ phức tạp theo độ dài xâu n hoặc đoạn con k):
| Thao tác | C++17 (<string>, <sstream>, <cctype>) |
Python 3 (str) |
Độ phức tạp |
|---|---|---|---|
| Lấy độ dài xâu | s.size() hoặc s.length() |
len(s) |
O(1) |
Cắt xâu con (từ vị trí pos, dài k) |
s.substr(pos, k) |
s[pos : pos + k] |
O(k) |
Tìm vị trí xâu con p |
s.find(p) (trả về string::npos nếu không có) |
s.find(p) (trả về -1 nếu không có) |
Tùy thuật toán và thư viện; tìm trực tiếp có cận O(n × |p|) |
| Đổi số nguyên sang xâu | to_string(12345) |
str(12345) |
O(số chữ số) |
| Đổi xâu sang số nguyên | stoi(s) (int) hoặc stoll(s) (long long) |
int(s) |
O(số chữ số) |
| Tách câu thành các từ | Dùng stringstream ss(cau); while (ss >> tu) |
cau.split() |
O(n) |
| Kiểm tra chữ cái / chữ số | isalpha(ch), isdigit(ch), isalnum(ch) |
ch.isalpha(), ch.isdigit(), ch.isalnum() |
O(1) |
Hãy xem chương trình thực hành kết hợp hai bài toán thực tế: (1) quét qua xâu lẫn lộn chữ và số "BigO2026_Algo45" để tính tổng từng chữ số rời rạc (2+0+2+6+4+5 = 19) và tổng các cụm số nguyên (2026 + 45 = 2071); (2) tách các từ trong câu có nhiều khoảng trắng thừa rồi chuẩn hóa thành dạng đường dẫn slug:
#include <cctype>
#include <iostream>
#include <sstream>
#include <string>
#include <vector>

using namespace std;

// 1. Tính tổng từng chữ số (ch - '0') và tổng các cụm số nguyên trong xâu
pair<int, int> tong_chu_so_va_cum_so(const string& s) {
    int tong_chu_so = 0;
    int tong_cum_so = 0;
    int so_hien_tai = 0;
    for (char ch : s) {
        if (isdigit(static_cast<unsigned char>(ch))) {
            int d = ch - '0';
            tong_chu_so += d;
            so_hien_tai = so_hien_tai * 10 + d;
        } else {
            tong_cum_so += so_hien_tai;
            so_hien_tai = 0;
        }
    }
    tong_cum_so += so_hien_tai;
    return {tong_chu_so, tong_cum_so};
}

// 2. Tách các từ, đổi sang chữ thường và nối lại bằng dấu gạch ngang '-'
string chuan_hoa_slug(const string& cau) {
    stringstream ss(cau);
    string tu, ket_qua;
    while (ss >> tu) {
        // std::string trong C++ là mutable: sửa trực tiếp từng ký tự tại chỗ
        for (char& ch : tu) {
            ch = static_cast<char>(tolower(static_cast<unsigned char>(ch)));
        }
        if (!ket_qua.empty()) {
            ket_qua += '-';
        }
        ket_qua += tu;
    }
    return ket_qua;
}

int main() {
    auto [tong_cs, tong_cum] = tong_chu_so_va_cum_so("BigO2026_Algo45");
    // 2+0+2+6+4+5 = 19; 2026 + 45 = 2071
    cout << tong_cs << " " << tong_cum << "\n";

    cout << chuan_hoa_slug("  hoc   thuat toan   cung BigO  ") << "\n";
    return 0;
}
def tong_chu_so_va_cum_so(s: str) -> tuple[int, int]:
    """Tính tổng từng chữ số và tổng các cụm số nguyên liên tiếp trong xâu."""
    tong_chu_so = 0
    tong_cum_so = 0
    so_hien_tai = 0
    base_0 = ord("0")
    for ch in s:
        if "0" <= ch <= "9":
            d = ord(ch) - base_0
            tong_chu_so += d
            so_hien_tai = so_hien_tai * 10 + d
        else:
            tong_cum_so += so_hien_tai
            so_hien_tai = 0
    tong_cum_so += so_hien_tai
    return tong_chu_so, tong_cum_so


def chuan_hoa_slug(cau: str) -> str:
    """Tách các từ, đổi chữ thường và nối bằng '-' (dùng join trong O(n))."""
    cac_tu = [tu.lower() for tu in cau.split()]
    return "-".join(cac_tu)


if __name__ == "__main__":
    tong_cs, tong_cum = tong_chu_so_va_cum_so("BigO2026_Algo45")
    print(tong_cs, tong_cum)
    print(chuan_hoa_slug("  hoc   thuat toan   cung BigO  "))
Chạy chương trình sẽ in ra 19 2071 ở dòng đầu và hoc-thuat-toan-cung-bigo ở dòng thứ hai.
Lỗi hay gặp
- Nhầm giữa
'0'(ký tự, mã ASCII48) và0(số nguyên): Nếu cộng trực tiếptong += s[i]mà quên trừ'0', máy tính sẽ cộng mã ASCII (48, 49, 50...). - Viết
s = s + chtrong vòng lặp: Ngay cả trong C++, viếts = s + chtạo bản sao xâu mới ở mỗi bước lặp (tốnO(n²)), trong khi thêm một ký tự bằngs += chcó chi phí khấu haoO(1), với ký tự kiểu đơn giản. - Trừ trực tiếp
s.size() - 1khi xâu rỗng trong C++: Hàms.size()trả về kiểu không dấusize_t. Nếusrỗng,s.size() - 1sẽ tràn số không dấu thành số dương khổng lồ. Hãy ép kiểu(int)s.size()trước khi trừ.
Luyện ngay trên Big-O Coding
Thực hành ngay xử lý xâu ký tự, bảng mã ASCII và mảng đếm tần suất trên Big-O Coding:
Câu hỏi thường gặp
Khi nào dùng mảng dem[26], khi nào dùng dem[256]?
Nếu đề bài chỉ gồm 26 chữ cái thường 'a'..'z', mảng dem[26] với chỉ số ch - 'a' là gọn nhất. Nếu xâu chứa cả chữ hoa, chữ thường, chữ số và dấu câu bất kỳ trong bảng ASCII, hãy khai báo mảng dem[256] và dùng trực tiếp dem[(unsigned char)ch].
Làm sao cộng hai số nguyên cực lớn dài 1.000 chữ số trong C++?
Ta đọc hai số vào hai biến std::string, sau đó duyệt từ chữ số hàng đơn vị (cuối xâu) ngược về đầu, lấy (a[i] - '0') + (b[j] - '0') + nho giống phép cộng đặt tính ngoài giấy.
So sánh thứ tự từ điển (s1 < s2) trên xâu hoạt động như thế nào?
Với đầu vào ASCII của bài, C++ và Python so sánh từ trái sang phải theo mã tương ứng. Ngoài ASCII, Python so theo mã Unicode; std::string thường so theo các đơn vị byte, không theo thứ tự từ điển tiếng Việt. Vì vậy khi so sánh số dạng xâu, "9" > "10" theo thứ tự từ điển vì '9' (57) lớn hơn '1' (49)!
Khóa Green cho người mới, sinh viên năm 1–2: xây nền tảng lập trình và thuật toán vững chắc, biết dùng AI hỗ trợ. 16 buổi online, học thử buổi 1 miễn phí.