- PDF được gửi trong một khối tài liệu, dạng base64, đường dẫn, hoặc mã tệp đã tải lên. Tài liệu khuyên đặt PDF trước câu hỏi.
- Mỗi trang được tách phần chữ và chuyển thành ảnh, nên mô hình hiểu cả bảng, biểu đồ; phần chữ thường tốn 1.500 đến 3.000 token mỗi trang, cộng thêm token phần ảnh.
- Giới hạn: yêu cầu tối đa 128 MB; tối đa 600 trang, hoặc 100 trang khi cửa sổ ngữ cảnh của yêu cầu dưới 1 triệu token; PDF chuẩn, không mật khẩu.
- PDF dày đặc có thể lấp đầy cửa sổ ngữ cảnh trước khi chạm giới hạn trang: chia nhỏ, và dùng cache khi hỏi nhiều lần cùng một tệp.
Bài này dựa trên trang PDF support và Files API trong tài liệu của Anthropic (đọc ngày 11/11/2026), cùng tài liệu thư viện pypdf dùng để đọc và chia tệp. Nếu chưa gọi API lần nào, đọc trước bài gọi API AI bằng Python.
PDF được xử lý thế nào
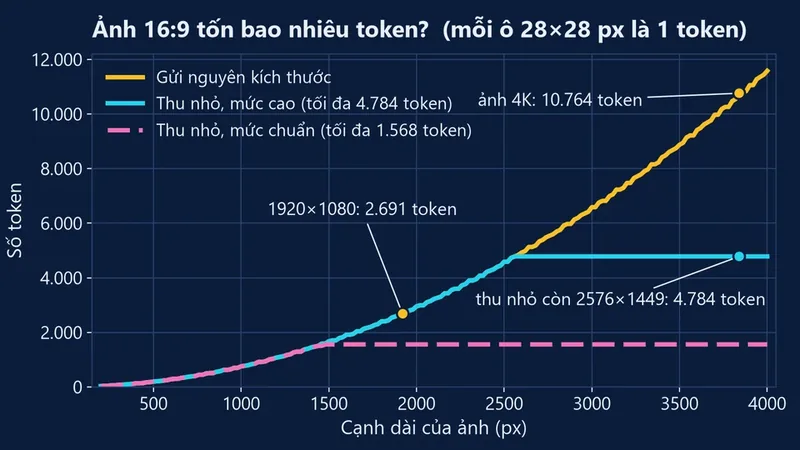
Theo tài liệu, khi bạn gửi một PDF, hệ thống làm hai việc với mỗi trang: chuyển trang thành ảnh, và tách phần chữ của trang đưa kèm ảnh đó. Mô hình nhận cả chữ lẫn ảnh, nên trả lời được câu hỏi về nội dung chữ, bảng số, biểu đồ, sơ đồ, thậm chí bố cục trang. Vì dựa vào khả năng nhìn ảnh, xử lý PDF chịu cùng các giới hạn như khi gửi ảnh, xem bài gửi hình ảnh cho mô hình AI.
Điều này cũng giải thích vì sao PDF tốn token. Tài liệu ghi phần chữ của mỗi trang thường tốn 1.500 đến 3.000 token tùy độ dày đặc, và phần ảnh của mỗi trang được tính như một ảnh. Không có phí riêng cho PDF; bạn trả theo giá token thường. Một tệp 12 trang có thể tốn từ 18.000 đến 36.000 token chỉ riêng phần chữ.
Giới hạn
Tài liệu nêu ba giới hạn. Kích thước yêu cầu tối đa 128 MB trên API của Anthropic. Số trang tối đa 600, nhưng chỉ 100 khi cửa sổ ngữ cảnh của yêu cầu dưới 1 triệu token. Tệp phải là PDF chuẩn, không đặt mật khẩu, không mã hóa. Các giới hạn này tính trên cả yêu cầu, gồm mọi thứ gửi kèm PDF.
Tài liệu còn lưu ý: PDF dày đặc (nhiều trang chữ nhỏ, bảng phức tạp, nhiều hình) có thể lấp đầy cửa sổ ngữ cảnh trước khi tới giới hạn trang. Khi đó chia tài liệu thành nhiều phần, và với tệp lớn có thể giảm độ phân giải ảnh nhúng trong PDF.
Ba cách gửi PDF
Base64. Đọc tệp, mã hóa base64, đặt vào khối tài liệu. Đơn giản, hợp với tệp nhỏ và vừa. Đây cũng là cách duy nhất nếu muốn đếm token trước bằng endpoint đếm token.
Đường dẫn. Nếu PDF nằm trên mạng công khai, gửi đường dẫn thay vì nội dung tệp.
Files API. Tải tệp lên một lần, nhận mã tệp, rồi tham chiếu mã đó trong các yêu cầu sau. Tài liệu gợi ý cách này cho PDF lớn để yêu cầu gọn nhẹ, và khi cần hỏi nhiều lần cùng một tệp.
Ví dụ bằng Python
Đoạn code dưới đây dùng thư viện pypdf để soát tệp trước khi gửi: kiểm đúng là PDF (bốn byte đầu), không vượt kích thước, đọc được (tệp không hỏng, không bị cắt cụt), không có mật khẩu, và đếm số trang. Nó có hàm chia PDF dài thành các phần không quá 100 trang, hàm ước token phần chữ theo khoảng trong tài liệu, và hàm tạo nội dung yêu cầu với khối tài liệu đứng trước câu hỏi, có tùy chọn đánh dấu cache.
"""Hỏi Claude về một tệp PDF: soát tệp trước khi gửi, chia nhỏ PDF dài, tạo khối document (đặt TRƯỚC câu hỏi).

Giới hạn theo tài liệu Anthropic (đọc 11/11/2026): yêu cầu tối đa 128 MB; tối đa 600 trang (100 trang khi cửa sổ ngữ cảnh
của yêu cầu dưới 1 triệu token); PDF chuẩn, không mật khẩu, không mã hóa. Mỗi trang thường tốn 1.500-3.000 token phần chữ,
cộng thêm token phần hình vì mỗi trang còn được chuyển thành ảnh.
Cài: python -m pip install anthropic pypdf ; đặt ANTHROPIC_API_KEY để hỏi thật.
"""
import base64
import io
import os
import sys

from pypdf import PdfReader, PdfWriter

TOI_DA_MB = 128
TOI_DA_TRANG = 100  # dùng mức thấp cho chắc; xem tài liệu nếu cửa sổ ngữ cảnh của bạn lớn hơn


def xem_pdf(du_lieu):
    """Trả về (số trang, danh sách vấn đề). Không ném lỗi, để người dùng thấy hết vấn đề một lần."""
    van_de = []
    if not du_lieu.startswith(b"%PDF"):
        return 0, ["không phải tệp PDF"]
    if len(du_lieu) > TOI_DA_MB * 2**20:
        van_de.append(f"tệp lớn hơn {TOI_DA_MB} MB")
    try:
        doc = PdfReader(io.BytesIO(du_lieu))
        if doc.is_encrypted:
            return 0, van_de + ["PDF có mật khẩu hoặc mã hóa"]
        so_trang = len(doc.pages)
    except Exception:  # noqa: BLE001
        # Tệp hỏng hay bị cắt cụt (tải dở). pypdf thường ném PdfReadError (tệp cụt cho PdfStreamError, một dạng của nó),
        # nhưng thử với tệp hỏng kiểu khác còn gặp KeyError, ValueError, AttributeError..., nên bắt hết ở đây.
        return 0, van_de + ["tệp PDF hỏng, không đọc được"]
    if so_trang > TOI_DA_TRANG:
        van_de.append(f"{so_trang} trang, vượt {TOI_DA_TRANG}: cần chia nhỏ")
    return so_trang, van_de


def chia_pdf(du_lieu, so_trang_moi_phan=TOI_DA_TRANG):
    doc = PdfReader(io.BytesIO(du_lieu))
    phan = []
    for dau in range(0, len(doc.pages), so_trang_moi_phan):
        w = PdfWriter()
        for trang in doc.pages[dau:dau + so_trang_moi_phan]:
            w.add_page(trang)
        buf = io.BytesIO()
        w.write(buf)
        phan.append(buf.getvalue())
    return phan


def uoc_token_chu(so_trang):
    return 1500 * so_trang, 3000 * so_trang


def tao_noi_dung(du_lieu, cau_hoi, cache=False):
    khoi = {"type": "document",
            "source": {"type": "base64", "media_type": "application/pdf",
                       "data": base64.standard_b64encode(du_lieu).decode("ascii")}}
    if cache:
        khoi["cache_control"] = {"type": "ephemeral"}
    return [khoi, {"type": "text", "text": cau_hoi}]


class KhongCoCauTraLoi(Exception):
    """Mô hình dừng mà không đưa ra câu trả lời trọn vẹn."""


def lay_tra_loi(tl):
    """Lấy chữ trả lời; báo rõ khi bị cắt hay bị từ chối, thay vì trả về chữ rỗng hoặc dở dang."""
    if tl.stop_reason in ("max_tokens", "model_context_window_exceeded"):
        raise KhongCoCauTraLoi(f"câu trả lời bị cắt giữa chừng ({tl.stop_reason})")
    if tl.stop_reason == "refusal":
        raise KhongCoCauTraLoi("mô hình từ chối trả lời yêu cầu này")
    chu = "".join(k.text for k in tl.content if k.type == "text")
    if not chu.strip():
        raise KhongCoCauTraLoi("mô hình không trả về chữ nào")
    return chu


def hoi(client, du_lieu, cau_hoi, mo_hinh="claude-sonnet-5-5"):
    # Sonnet 5.5 suy nghĩ trước khi trả lời, và token suy nghĩ tính vào max_tokens dù không hiện ra, nên để rộng chỗ.
    # max_tokens chỉ là mức trần: bạn trả tiền cho số token thật sự sinh ra.
    tl = client.messages.create(model=mo_hinh, max_tokens=16000,
                                messages=[{"role": "user", "content": tao_noi_dung(du_lieu, cau_hoi)}])
    return lay_tra_loi(tl)


def tao_pdf_mau(so_trang, mat_khau=None):
    w = PdfWriter()
    for _ in range(so_trang):
        w.add_blank_page(width=595, height=842)
    if mat_khau:
        w.encrypt(mat_khau)
    buf = io.BytesIO()
    w.write(buf)
    return buf.getvalue()


def chay_thu():
    dong = []
    for ten, du_lieu in [("PDF 12 trang", tao_pdf_mau(12)), ("PDF 250 trang", tao_pdf_mau(250)),
                         ("PDF có mật khẩu", tao_pdf_mau(3, "abc")), ("Tệp ảnh đổi đuôi", b"\x89PNG....")]:
        so_trang, van_de = xem_pdf(du_lieu)
        dong.append(f"{ten}: {so_trang} trang; " + ("gửi được" if not van_de else "; ".join(van_de)))
    phan = chia_pdf(tao_pdf_mau(250))
    dong.append("Chia PDF 250 trang: " + ", ".join(str(len(PdfReader(io.BytesIO(p)).pages)) for p in phan) + " trang")
    thap, cao = uoc_token_chu(12)
    dong.append(f"PDF 12 trang: phần chữ khoảng {thap}-{cao} token, chưa tính phần hình")
    print("\n".join(dong))
    return dong


def main(duong_dan, cau_hoi):
    if not os.environ.get("ANTHROPIC_API_KEY"):
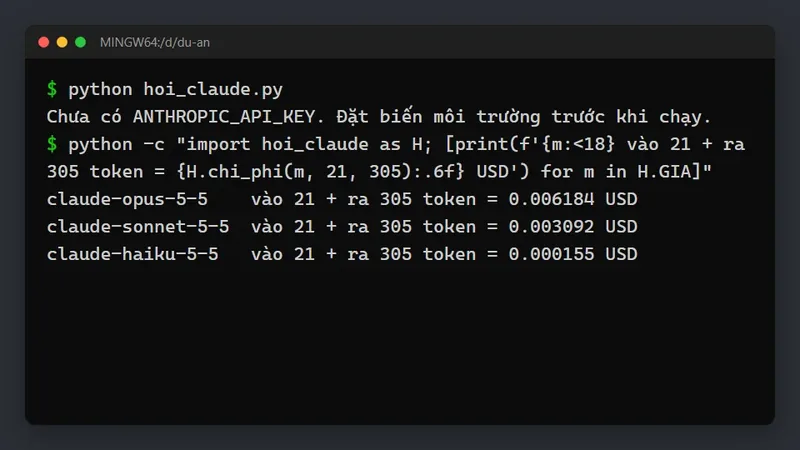
        sys.exit("Chưa có ANTHROPIC_API_KEY. Đặt biến môi trường trước khi chạy.")
    with open(duong_dan, "rb") as f:
        du_lieu = f.read()
    so_trang, van_de = xem_pdf(du_lieu)
    if van_de:
        sys.exit("Chưa gửi được: " + "; ".join(van_de))
    import anthropic
    try:
        print(hoi(anthropic.Anthropic(), du_lieu, cau_hoi))
    except KhongCoCauTraLoi as e:
        sys.exit(f"Chưa có câu trả lời trọn vẹn: {e}.")
    except anthropic.APIStatusError as e:
        sys.exit(f"API báo lỗi {e.status_code}: {e.message}")
    except anthropic.APIConnectionError:
        sys.exit("Không kết nối được tới API. Kiểm tra mạng rồi thử lại.")


if __name__ == "__main__":
    if len(sys.argv) >= 3:
        main(sys.argv[1], " ".join(sys.argv[2:]))
    else:
        chay_thu()
Phần chạy thử tự tạo bốn tệp mẫu. PDF 12 trang gửi được. PDF 250 trang vượt mức 100 trang mà code chọn, được báo cần chia nhỏ, và hàm chia cắt thành ba phần 100, 100 và 50 trang. PDF có mật khẩu bị chặn từ đầu. Một tệp ảnh đổi đuôi thành PDF bị nhận ra ngay vì không bắt đầu bằng dấu hiệu của PDF. Soát trước như vậy rẻ hơn nhiều so với gửi đi rồi nhận lỗi, nhất là khi xử lý hàng trăm tệp.
Khi chạy với đường dẫn tệp và câu hỏi, chương trình soát tệp, nếu ổn thì gửi cho mô hình và in câu trả lời. Mô hình suy nghĩ trước khi trả lời và phần suy nghĩ cũng tính vào max_tokens, nên code để max_tokens rộng; nếu câu trả lời vẫn bị cắt, hoặc mô hình từ chối, chương trình báo rõ thay vì in một câu trả lời dở dang.
Hỏi cho hiệu quả
Tài liệu đưa ra vài gợi ý: đặt PDF trước phần chữ trong yêu cầu; dùng phông chữ chuẩn, chữ rõ; xoay trang đúng chiều; khi nhắc tới trang thì dùng số trang hiển thị trong trình xem PDF; chia PDF lớn khi cần; bật cache khi phân tích lặp lại cùng một tệp.
Về cách hỏi, hãy cụ thể: thay vì "tóm tắt tài liệu", hỏi "liệt kê các mốc thời gian nộp hồ sơ trong tài liệu, kèm số trang". Yêu cầu trích số trang giúp bạn kiểm lại nhanh. Với dữ liệu cần đưa vào hệ thống khác, kết hợp với đầu ra JSON có cấu trúc.
Một luồng xử lý thực tế
Giả sử phòng đào tạo có vài trăm tệp PDF thông báo, mỗi tệp vài trang, và cần trích ra hạn nộp hồ sơ, đối tượng áp dụng, lệ phí. Một luồng làm việc hợp lý như sau.
Bước một, soát mọi tệp bằng hàm như trong bài, tách riêng những tệp lỗi (mật khẩu, hỏng, quá dài) để người xử lý tay. Bước hai, thử trên năm tệp đại diện bằng gọi thường, chỉnh câu hỏi tới khi kết quả đúng, yêu cầu trả về dạng JSON có cấu trúc và kèm số trang chứa thông tin. Bước ba, đếm token của năm tệp đó để ước chi phí cho cả kho. Bước bốn, chạy toàn bộ bằng xử lý theo lô cho rẻ. Bước năm, lấy ngẫu nhiên mười kết quả, mở PDF gốc ở đúng số trang được trích, đối chiếu bằng mắt.
Cách làm này tốn thêm ít công lúc đầu nhưng tránh được việc chạy cả kho rồi mới phát hiện câu hỏi chưa đúng ý, hoặc phần lớn tệp là bản scan mờ cần xử lý riêng.
PDF trực tiếp hay RAG
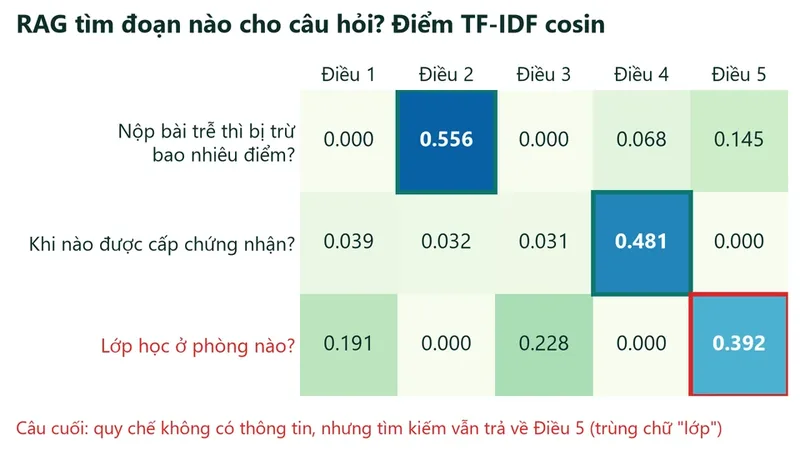
Gửi cả PDF hợp khi tài liệu vừa trong giới hạn và bạn cần mô hình hiểu cả bảng, hình, bố cục. Với kho hàng trăm tệp, hoặc tài liệu rất dài mà câu hỏi chỉ liên quan vài trang, tách chữ ra và dựng hệ thống tìm kiếm như trong bài RAG là gì sẽ rẻ hơn. Có thể kết hợp: dùng tìm kiếm để chọn đúng vài trang, rồi gửi riêng các trang đó dạng PDF để mô hình thấy cả bảng biểu.
Khi nào tách chữ ra trước
Nếu PDF chỉ có chữ thuần, không bảng, không hình, và bạn cần xử lý rất nhiều tệp, tách chữ bằng thư viện như pypdf rồi gửi phần chữ sẽ rẻ hơn, vì không tốn token cho ảnh của từng trang. Đổi lại, bạn mất thông tin bố cục và có thể gặp chữ bị tách sai thứ tự ở tài liệu nhiều cột. Thử cả hai cách trên vài tệp mẫu, so chất lượng câu trả lời và chi phí, rồi quyết định cho cả kho.
Quyền riêng tư
PDF thường chứa thông tin nhạy cảm: hợp đồng, bảng điểm, hồ sơ cá nhân. Trước khi gửi qua API, kiểm tra bạn có quyền xử lý tài liệu đó bằng dịch vụ bên ngoài không, và chính sách lưu trữ dữ liệu của tài khoản API. Với tài liệu chỉ cần một phần, cắt riêng phần đó thay vì gửi cả tệp.
- Gửi PDF có mật khẩu hoặc tệp đổi đuôi rồi mới thấy lỗi.
- Tính chi phí theo số chữ mà quên phần ảnh của mỗi trang.
- Đặt câu hỏi trước PDF trong yêu cầu.
- Gửi lại cả tệp lớn cho mỗi câu hỏi mà không dùng cache hay Files API.
- Gửi tài liệu cá nhân của người khác qua API mà không được phép.
Câu hỏi thường gặp
PDF scan từ ảnh có đọc được không?
Mỗi trang được chuyển thành ảnh nên mô hình vẫn nhìn được nội dung. Chất lượng phụ thuộc độ rõ của bản scan; trang mờ, nghiêng sẽ kém hơn.
Có cần tự tách chữ từ PDF trước không?
Không bắt buộc khi gửi trực tiếp. Tự tách chữ có ích khi dựng hệ thống tìm kiếm, hoặc muốn giảm token bằng cách chỉ gửi phần chữ.
Gửi nhiều PDF một lần được không?
Được, miễn tổng yêu cầu trong giới hạn. Gắn tên cho từng tài liệu trong câu hỏi để mô hình phân biệt.
Xử lý hàng trăm PDF thì sao?
Dùng xử lý theo lô để giảm giá và không phải tự lo giới hạn tốc độ.
Học tiếp
- Gọi API lần đầu: gọi API AI bằng Python.
- Gửi ảnh cho mô hình: gửi hình ảnh cho mô hình AI.
- Hỏi đáp trên kho tài liệu lớn: RAG là gì.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.