- RAG gồm bốn bước: chia tài liệu thành đoạn, tìm đoạn liên quan cho câu hỏi, ghép đoạn vào prompt kèm số nguồn, mô hình trả lời có trích nguồn.
- Thuật ngữ đến từ bài báo của Lewis và cộng sự năm 2020, kết hợp mô hình sinh văn bản với một bộ nhớ ngoài có thể truy xuất.
- Chất lượng tìm kiếm quyết định chất lượng câu trả lời. Anthropic báo cáo kỹ thuật Contextual Retrieval giảm 49% số lần truy xuất thất bại, và 67% khi thêm bước xếp hạng lại.
- Theo bài viết đó, nếu toàn bộ tài liệu dưới khoảng 200.000 token (khoảng 500 trang), có thể bỏ qua RAG và đưa cả tài liệu vào prompt.
Bài này dựa trên bài báo RAG gốc (arXiv 2005.11401), bài Contextual Retrieval của Anthropic và trang Embeddings trong tài liệu Claude, đọc ngày 11/11/2026. Nếu bạn chưa gọi API mô hình lần nào, đọc gọi API AI bằng Python trước.
Vì sao cần RAG
Mô hình ngôn ngữ chỉ biết những gì có trong dữ liệu huấn luyện. Nó không biết quy chế đào tạo của trường bạn, tài liệu nội bộ của công ty, hay giáo trình môn học vừa cập nhật tuần trước. Hỏi những điều đó, mô hình hoặc nói không biết, hoặc tệ hơn, đoán ra một câu trả lời nghe hợp lý nhưng sai.
Bài báo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis và cộng sự, 2020) nêu đúng vấn đề này: mô hình lớn huấn luyện trước có lưu kiến thức trong tham số, nhưng khả năng truy cập và dùng chính xác kiến thức đó còn hạn chế, việc chỉ ra nguồn gốc cho câu trả lời và cập nhật kiến thức vẫn là bài toán mở. Hướng giải quyết là ghép mô hình sinh văn bản với một bộ nhớ ngoài có thể truy xuất. RAG ngày nay trong các ứng dụng làm điều tương tự một cách đơn giản hơn: tìm đoạn tài liệu liên quan và đưa thẳng vào prompt.
Lợi ích thực tế: câu trả lời dựa trên tài liệu bạn kiểm soát, cập nhật được bằng cách sửa tài liệu thay vì huấn luyện lại, và có thể trích nguồn để người đọc tự kiểm.
Bốn bước của RAG
Chia đoạn. Tài liệu dài được cắt thành các đoạn vừa phải: một điều khoản, một mục, vài đoạn văn. Đoạn quá ngắn mất ngữ cảnh; đoạn quá dài làm prompt nặng và lẫn thông tin không liên quan.
Tìm đoạn liên quan. Với mỗi câu hỏi, tính độ giống giữa câu hỏi và từng đoạn, lấy vài đoạn giống nhất. Cách đơn giản là so từ ngữ (như TF-IDF hay BM25); cách phổ biến trong sản phẩm là dùng mô hình embedding để biến văn bản thành véc-tơ, rồi so véc-tơ. Trang Embeddings của tài liệu Claude ghi Anthropic không có mô hình embedding riêng và giới thiệu một nhà cung cấp là Voyage AI.
Ghép vào prompt. Đặt các đoạn tìm được trong một phần riêng của prompt (ví dụ trong thẻ), đánh số từng đoạn, và dặn mô hình chỉ dựa vào các đoạn đó, ghi số nguồn sau mỗi ý, và nói rõ khi không tìm thấy thông tin.
Trả lời. Mô hình đọc các đoạn và trả lời. Câu trả lời tốt có trích số nguồn; câu hỏi ngoài tài liệu được trả lời là không tìm thấy, thay vì đoán.
Một RAG tối giản bằng Python
Đoạn code dưới đây làm cả bốn bước bằng Python thuần để bạn thấy từng phần: chia một quy chế giả định năm điều thành năm đoạn, tìm đoạn liên quan bằng TF-IDF và độ tương đồng cosin, ghép prompt có thẻ nguồn và số thứ tự, và hàm gửi prompt cho mô hình qua thư viện anthropic khi chạy với --that. Hàm này để max_tokens rộng vì phần suy nghĩ của mô hình cũng tính vào đó, và báo rõ khi câu trả lời bị cắt giữa chừng hay bị từ chối, thay vì in chữ dở dang như đã trả lời xong. Chạy không tham số thì chỉ in kết quả tìm kiếm, không gọi mạng.
"""RAG tối giản bằng Python thuần: chia tài liệu thành đoạn, tìm đoạn liên quan nhất cho câu hỏi,
ghép vào prompt kèm số thứ tự nguồn, rồi (khi chạy thật) gửi cho mô hình.

Phần tìm kiếm dùng TF-IDF và độ tương đồng cosin để chạy không cần thư viện; sản phẩm thật thường dùng
mô hình embedding và cơ sở dữ liệu véc-tơ. Tài liệu mẫu là quy chế giả định.
Chạy thật: đặt ANTHROPIC_API_KEY rồi chạy: python rag_nho.py --that "câu hỏi"
"""
import math
import re
import sys
from collections import Counter

TAI_LIEU = """Điều 1. Học viên phải tham dự ít nhất 80% số buổi học để được xét hoàn thành khóa.
Điều 2. Bài tập nộp trễ dưới 24 giờ bị trừ 10% điểm; trễ quá 24 giờ không được chấm.
Điều 3. Học viên được bảo lưu khóa học tối đa 6 tháng, đăng ký bảo lưu trước buổi học thứ ba.
Điều 4. Chứng nhận hoàn thành được cấp khi điểm tổng kết từ 5 trở lên và đạt điều kiện chuyên cần.
Điều 5. Học phí đã đóng không hoàn lại sau buổi học thứ hai, trừ trường hợp lớp bị hủy."""


def tach_tu(van_ban):
    return re.findall(r"\w+", van_ban.lower())


def chia_doan(tai_lieu):
    return [d.strip() for d in tai_lieu.splitlines() if d.strip()]


def tf_idf(cac_doan):
    tu_doan = [Counter(tach_tu(d)) for d in cac_doan]
    n = len(cac_doan)
    df = Counter(t for c in tu_doan for t in c)
    idf = {t: math.log((1 + n) / (1 + df[t])) + 1 for t in df}
    return [{t: c[t] * idf[t] for t in c} for c in tu_doan], idf


def cosin(a, b):
    tich = sum(a[t] * b.get(t, 0.0) for t in a)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return tich / (na * nb) if na and nb else 0.0


def tim(cau_hoi, cac_doan, k=2):
    vec, idf = tf_idf(cac_doan)
    q = {t: c * idf.get(t, 0.0) for t, c in Counter(tach_tu(cau_hoi)).items()}
    diem = sorted(((cosin(q, v), i) for i, v in enumerate(vec)), reverse=True)
    return [(i, round(s, 3)) for s, i in diem[:k] if s > 0]


def tao_prompt(cau_hoi, cac_doan, ket_qua):
    nguon = "\n".join(f"[{i + 1}] {cac_doan[i]}" for i, _ in ket_qua)
    return ("Chỉ dựa vào các đoạn trong thẻ <nguon> để trả lời. Ghi số nguồn trong ngoặc vuông sau mỗi ý. "
            "Nếu các đoạn không có thông tin, nói rõ là không tìm thấy trong tài liệu.\n"
            f"<nguon>\n{nguon}\n</nguon>\n\nCâu hỏi: {cau_hoi}")


class KhongCoCauTraLoi(Exception):
    """Mô hình dừng mà không đưa ra câu trả lời trọn vẹn."""


def hoi(client, prompt, mo_hinh="claude-haiku-5-5"):
    # Haiku 5.5 suy nghĩ trước khi trả lời, và token suy nghĩ tính vào max_tokens dù không hiện ra, nên để rộng chỗ.
    # max_tokens chỉ là mức trần: bạn trả tiền cho số token thật sự sinh ra.
    tin = client.messages.create(model=mo_hinh, max_tokens=16000, messages=[{"role": "user", "content": prompt}])
    # Câu trả lời bị cắt hay bị từ chối thì báo rõ, không trả chữ dở dang (hay rỗng) như thể đã trả lời xong.
    if tin.stop_reason in ("max_tokens", "model_context_window_exceeded"):
        raise KhongCoCauTraLoi(f"câu trả lời bị cắt giữa chừng ({tin.stop_reason})")
    if tin.stop_reason == "refusal":
        raise KhongCoCauTraLoi("mô hình từ chối trả lời câu hỏi này")
    chu = "".join(k.text for k in tin.content if k.type == "text")
    if not chu.strip():
        raise KhongCoCauTraLoi("mô hình không trả về chữ nào")
    return chu


def chay_thu():
    doan = chia_doan(TAI_LIEU)
    dong = []
    for cau in ["Nộp bài trễ thì bị trừ bao nhiêu điểm?", "Khi nào được cấp chứng nhận?", "Lớp học ở phòng nào?"]:
        kq = tim(cau, doan)
        dong.append(f"{cau} -> " + (", ".join(f"điều {i + 1} ({s})" for i, s in kq) or "không có đoạn liên quan"))
    p = tao_prompt("Nộp bài trễ thì bị trừ bao nhiêu điểm?", doan, tim("Nộp bài trễ thì bị trừ bao nhiêu điểm?", doan))
    dong.append(f"Prompt gửi mô hình: {len(p)} ký tự, gồm {p.count('[')} nguồn")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    if len(sys.argv) > 2 and sys.argv[1] == "--that":
        import anthropic
        doan = chia_doan(TAI_LIEU)
        cau = " ".join(sys.argv[2:])
        try:
            print(hoi(anthropic.Anthropic(), tao_prompt(cau, doan, tim(cau, doan))))
        except KhongCoCauTraLoi as e:
            sys.exit(f"Chưa có câu trả lời: {e}.")
    else:
        chay_thu()
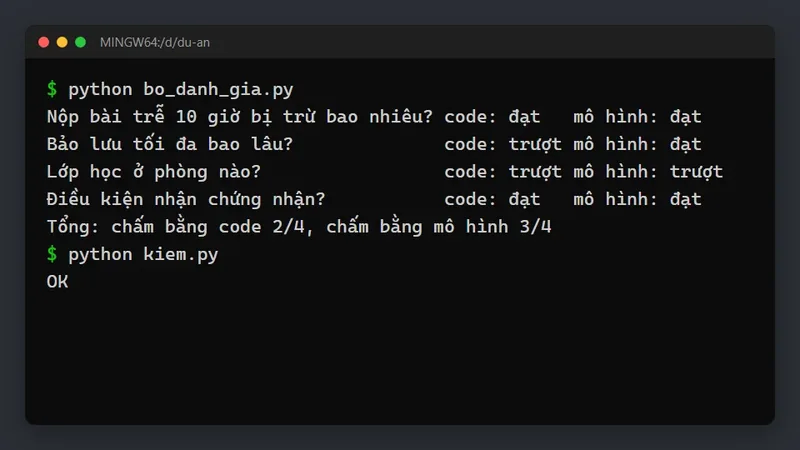
Kết quả cho ba câu hỏi rất đáng xem. "Nộp bài trễ thì bị trừ bao nhiêu điểm?" tìm đúng điều 2 với điểm giống cao nhất. "Khi nào được cấp chứng nhận?" tìm đúng điều 4. Còn "Lớp học ở phòng nào?" thì quy chế không có thông tin, nhưng phần tìm kiếm vẫn trả về điều 5 vì trùng chữ "lớp". Đây là lý do prompt phải dặn mô hình nói rõ khi các đoạn không chứa câu trả lời, và là lý do cần đo chất lượng tìm kiếm riêng, không chỉ đo câu trả lời cuối cùng.
Làm tìm kiếm tốt hơn
Bài Contextual Retrieval của Anthropic chỉ ra một điểm yếu của cách chia đoạn truyền thống: đoạn bị tách khỏi tài liệu thì mất ngữ cảnh. Ví dụ của bài là một đoạn nói doanh thu "tăng 3% so với quý trước" mà không nói công ty nào, quý nào. Kỹ thuật được đề xuất là dùng mô hình viết thêm một câu ngữ cảnh ngắn (thường 50 đến 100 token) cho từng đoạn, dựa trên toàn bộ tài liệu, rồi mới tạo embedding và chỉ mục từ khóa BM25. Bài báo cáo tỉ lệ truy xuất thất bại (trong 20 đoạn đầu) giảm từ 5,7% xuống 3,7% với embedding có ngữ cảnh, xuống 2,9% khi kết hợp thêm BM25 có ngữ cảnh, và xuống 1,9% khi thêm bước xếp hạng lại.
Với người mới, ba cải tiến dễ làm nhất là: chia đoạn theo cấu trúc tự nhiên của tài liệu (điều, mục, đề mục), kết hợp tìm theo từ khóa với tìm theo nghĩa, và thêm tiêu đề tài liệu hay tên mục vào đầu mỗi đoạn để đoạn không mất ngữ cảnh.
Khi nào không cần RAG
Cũng theo bài Contextual Retrieval, nếu cơ sở tri thức nhỏ hơn khoảng 200.000 token (khoảng 500 trang), có thể đưa toàn bộ vào prompt thay vì làm RAG; bộ nhớ đệm prompt giúp cách này nhanh và rẻ hơn khi hỏi nhiều lần. Ví dụ giáo trình một môn học hay quy chế của một trường thường nằm trong khoảng đó. Chọn cách đơn giản nhất chạy được, rồi mới làm phức tạp khi cần.
Ngược lại, RAG cũng không phải lời giải khi vấn đề là cách mô hình viết (giọng văn, định dạng đặc thù) chứ không phải thiếu kiến thức; khi đó cân nhắc viết prompt tốt hơn hoặc tinh chỉnh mô hình, xem fine-tuning hay viết prompt.
Đánh giá một hệ thống RAG
Đo riêng hai phần. Phần tìm kiếm: với mỗi câu hỏi mẫu, đoạn chứa đáp án có nằm trong các đoạn tìm được không. Phần trả lời: câu trả lời có đúng, có trích đúng nguồn, có nói "không tìm thấy" với câu hỏi ngoài tài liệu không. Chuẩn bị 30 đến 50 câu hỏi mẫu, trong đó có vài câu cố tình hỏi ngoài tài liệu. Cách làm bộ đánh giá có trong bài đánh giá câu trả lời của AI.
Dự án luyện tập
Một dự án vừa sức sinh viên: chatbot hỏi đáp giáo trình của một môn bạn đang học. Bắt đầu bằng cách đưa cả giáo trình vào prompt nếu nó đủ nhỏ, ghi lại chất lượng trên 30 câu hỏi mẫu. Sau đó làm phiên bản RAG như đoạn code ở trên, thay phần TF-IDF bằng một mô hình embedding, và so hai phiên bản trên cùng bộ câu hỏi: phiên bản nào đúng hơn, rẻ hơn, nhanh hơn. Viết kết quả so sánh vào README; một bảng số liệu như vậy cho thấy bạn hiểu khi nào nên dùng RAG, điều người phỏng vấn rất hay hỏi.
- Làm RAG phức tạp cho một tài liệu chỉ vài chục trang, trong khi đưa cả tài liệu vào prompt là đủ.
- Không dặn mô hình nói "không tìm thấy", để nó đoán khi tài liệu không có thông tin.
- Chia đoạn cắt ngang câu, ngang bảng, làm mất ngữ cảnh.
- Chỉ đo câu trả lời cuối mà không đo phần tìm kiếm, nên không biết lỗi nằm ở đâu.
- Đưa tài liệu có thông tin cá nhân vào hệ thống mà không kiểm quyền truy cập.
Câu hỏi thường gặp
RAG có làm mô hình hết bịa không?
Giảm đáng kể nhưng không hết. Nếu phần tìm kiếm trả về đoạn sai, mô hình vẫn có thể trả lời sai. Trích nguồn giúp người đọc tự kiểm.
Có cần cơ sở dữ liệu véc-tơ không?
Với vài trăm đoạn, lưu trong bộ nhớ và tính trực tiếp như ví dụ là đủ. Khi có hàng chục nghìn đoạn trở lên, cơ sở dữ liệu véc-tơ giúp tìm nhanh.
RAG cho tài liệu tiếng Việt có khác không?
Nguyên lý giống nhau. Chọn mô hình embedding hỗ trợ đa ngôn ngữ, và chú ý tách từ khi dùng tìm kiếm theo từ khóa, vì tiếng Việt có từ ghép nhiều âm tiết.
RAG khác fine-tuning thế nào?
RAG đưa kiến thức vào lúc hỏi, sửa tài liệu là cập nhật được. Fine-tuning thay đổi mô hình bằng cách huấn luyện thêm, hợp hơn khi cần đổi cách mô hình làm việc.
Học tiếp
- Lời gọi API đầu tiên: gọi API AI bằng Python.
- Đo chất lượng hệ thống RAG: đánh giá câu trả lời của AI.
- Khi nào nên huấn luyện lại mô hình: fine-tuning hay viết prompt.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.