- Eval là bộ câu hỏi mẫu có đáp án, chạy tự động mỗi khi bạn đổi prompt, đổi mô hình hay đổi dữ liệu.
- Ba nguyên tắc từ tài liệu Claude: bám sát phân bố câu hỏi thật, kể cả trường hợp khó; tự động hóa việc chấm khi có thể; và nhiều câu chấm tự động (dù tín hiệu kém hơn một chút) tốt hơn ít câu chấm tay.
- Chấm bằng code cho câu có đáp án rõ; chấm bằng mô hình cho câu cần hiểu nghĩa, với tiêu chí chi tiết và đầu ra gọn (ví dụ chỉ "đúng" hoặc "sai"); chấm bằng người để kiểm lại bộ chấm tự động.
- Tài liệu Claude khuyên nên dùng một mô hình khác với mô hình tạo câu trả lời để chấm.
Bài này dựa trên trang Define success criteria and build evaluations trong tài liệu Claude, đọc ngày 11/11/2026. Ví dụ trong bài nối tiếp chatbot hỏi đáp quy chế ở bài RAG là gì.
Vì sao phải đo
Thử vài câu hỏi trong giao diện chat rồi thấy "có vẻ ổn" là cách đánh giá theo cảm giác. Nó bỏ sót ba điều: câu trả lời của mô hình thay đổi giữa các lần chạy; thay đổi một chỗ trong prompt có thể làm tốt câu này nhưng hỏng câu khác; và những câu khó, ít gặp mới là nơi ứng dụng hay sai nhất. Trang tổng quan về prompt engineering của Anthropic đặt việc có tiêu chí thành công và có cách kiểm thử theo tiêu chí là điều kiện trước khi tinh chỉnh prompt; hướng dẫn của OpenAI cũng khuyên xây bộ kiểm thử để theo dõi hành vi khi đổi prompt hay nâng cấp mô hình.
Thiết kế bộ câu hỏi mẫu
Tài liệu Claude nêu ba nguyên tắc. Thứ nhất, bộ đánh giá phải bám sát phân bố công việc thật, và không quên các trường hợp biên: dữ liệu đầu vào không liên quan hay không tồn tại, đầu vào quá dài, và những câu mơ hồ mà ngay cả con người cũng khó thống nhất. Thứ hai, thiết kế câu hỏi để chấm tự động được: trắc nghiệm, so khớp chuỗi, chấm bằng code, hoặc chấm bằng mô hình. Thứ ba, ưu tiên số lượng: nhiều câu chấm tự động với tín hiệu hơi kém vẫn tốt hơn ít câu chấm tay chất lượng cao.
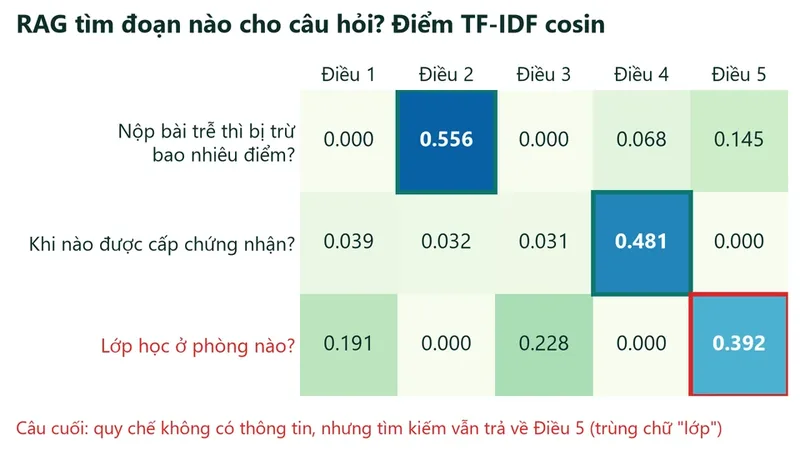
Với một chatbot hỏi đáp tài liệu, một bộ khởi đầu hợp lý gồm 30 đến 50 câu: phần lớn là câu hỏi thật người dùng sẽ hỏi, vài câu cần ghép thông tin từ hai chỗ, và vài câu cố tình hỏi điều không có trong tài liệu để xem ứng dụng có thừa nhận "không tìm thấy" hay bịa ra câu trả lời.
Ba cách chấm
Theo tài liệu Claude:
Chấm bằng code nhanh nhất và đáng tin cậy nhất, mở rộng rất dễ, nhưng thiếu tinh tế với những phán đoán phức tạp. Dùng khi đáp án rõ ràng: so khớp chính xác, chứa từ khóa bắt buộc, đúng định dạng JSON, độ dài trong giới hạn.
Chấm bằng người linh hoạt và chất lượng cao nhất nhưng chậm và đắt; tài liệu khuyên tránh nếu có thể. Trên thực tế, người chấm rất hữu ích để kiểm lại một mẫu nhỏ, xem bộ chấm tự động có đáng tin không.
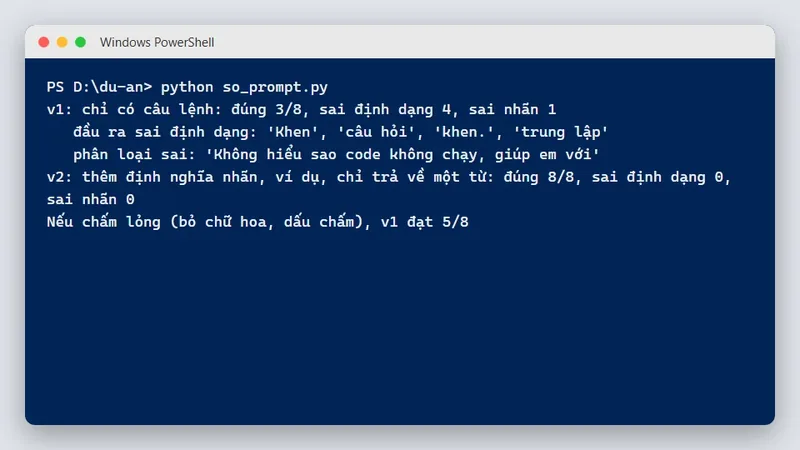
Chấm bằng mô hình nhanh, linh hoạt, mở rộng được và hợp với phán đoán phức tạp; tài liệu dặn kiểm độ tin cậy trước rồi mới dùng rộng. Ba mẹo đi kèm: có tiêu chí chi tiết, rõ ràng; yêu cầu kết quả cụ thể, ví dụ chỉ trả về "đúng" hay "sai" hoặc điểm từ 1 đến 5; và cho mô hình chấm suy nghĩ trước khi cho điểm với những phán đoán khó. Tài liệu cũng ghi nên chấm bằng một mô hình khác với mô hình đã tạo ra câu trả lời.
Ví dụ: chấm bốn câu trả lời
Đoạn Python dưới đây chấm bốn câu trả lời của chatbot quy chế (câu trả lời là số liệu giả định) bằng hai cách tự động. Cách chấm bằng code kiểm câu trả lời có chứa từ khóa bắt buộc và không quá dài. Cách chấm bằng mô hình ghép câu hỏi, đáp án mẫu và câu trả lời vào các thẻ, kèm tiêu chí rõ ràng, yêu cầu chỉ trả về "dung" hoặc "sai", và báo lỗi nếu mô hình chấm trả lời ngoài định dạng, bị cắt giữa chừng hay từ chối chấm. Mô hình chấm suy nghĩ trước khi trả lời và phần suy nghĩ cũng tính vào max_tokens, nên lời gọi để max_tokens đủ rộng và hạ effort xuống mức thấp, vì việc chấm chỉ cần một từ. Để bài chạy không cần mạng, kết quả của mô hình chấm được ghi sẵn; khi làm thật, thay bằng client của thư viện anthropic.
"""Bộ đánh giá nhỏ cho câu trả lời của AI, với hai cách chấm tự động mà tài liệu Claude mô tả:
- chấm bằng code: so khớp, chứa từ khóa bắt buộc, độ dài (nhanh, ổn định, nhưng thiếu tinh tế);
- chấm bằng mô hình: đưa câu hỏi, đáp án mẫu, câu trả lời và tiêu chí rõ ràng cho một mô hình khác,
  yêu cầu chỉ trả về "dung" hoặc "sai".
Câu trả lời cần chấm và kết quả của mô hình chấm ở đây là dữ liệu giả định để chạy không cần mạng.
"""

CA = [  # câu hỏi, đáp án mẫu, từ khóa bắt buộc, câu trả lời cần chấm (giả định)
    ("Nộp bài trễ 10 giờ bị trừ bao nhiêu?", "10%", ["10%"], "Bị trừ 10% điểm [2]."),
    ("Bảo lưu tối đa bao lâu?", "6 tháng", ["6 tháng"], "Học viên được bảo lưu tối đa sáu tháng [3]."),
    ("Lớp học ở phòng nào?", "không có trong tài liệu", ["không tìm thấy"], "Lớp học ở phòng 302."),
    ("Điều kiện nhận chứng nhận?", "điểm từ 5 và đủ chuyên cần",
     ["5", "chuyên cần"], "Cần điểm tổng kết từ 5 trở lên và đạt chuyên cần [4]."),
]
TIEU_CHI = ("Câu trả lời ĐÚNG khi cùng nghĩa với đáp án mẫu (chấp nhận cách viết khác, ví dụ số viết bằng chữ) "
            "và không thêm thông tin không có trong đáp án. Với câu hỏi mà đáp án là 'không có trong tài liệu', "
            "câu trả lời phải nói rõ là không tìm thấy; đưa ra thông tin cụ thể là SAI. Chỉ trả về một từ: dung hoặc sai.")


def cham_code(tra_loi, tu_khoa, toi_da_ky_tu=200):
    thap = tra_loi.lower()
    return all(t.lower() in thap for t in tu_khoa) and len(tra_loi) <= toi_da_ky_tu


def prompt_cham(cau_hoi, dap_an, tra_loi):
    return (f"{TIEU_CHI}\n\n<cau_hoi>{cau_hoi}</cau_hoi>\n<dap_an_mau>{dap_an}</dap_an_mau>\n"
            f"<cau_tra_loi>{tra_loi}</cau_tra_loi>")


def cham_mo_hinh(client, cau_hoi, dap_an, tra_loi, mo_hinh="claude-sonnet-5-5"):
    # max_tokens phải đủ chỗ cho CẢ phần suy nghĩ lẫn chữ trả lời: trang Effort ghi "Thinking counts toward max_tokens
    # even when the thinking content isn't returned". Claude Sonnet 5.5 bật suy nghĩ sẵn và từ chối thinking
    # {"type": "disabled"} bằng lỗi 400, nên để max_tokens nhỏ (ví dụ 5) thì phần suy nghĩ ăn hết hạn mức và câu trả
    # lời không còn chữ nào. Việc chấm chỉ cần một từ, nên hạ effort xuống "low" để mô hình nghĩ ít, và chừa 2048 token.
    tin = client.messages.create(model=mo_hinh, max_tokens=2048, output_config={"effort": "low"},
                                 messages=[{"role": "user", "content": prompt_cham(cau_hoi, dap_an, tra_loi)}])
    # Bị cắt giữa chừng hay bị từ chối thì báo đúng lý do, không lẫn với lỗi định dạng.
    if tin.stop_reason in ("max_tokens", "model_context_window_exceeded"):
        raise ValueError(f"mô hình chấm bị cắt giữa chừng ({tin.stop_reason}), chưa có kết quả chấm")
    if tin.stop_reason == "refusal":
        raise ValueError("mô hình chấm từ chối chấm câu này")
    chu = "".join(k.text for k in tin.content if k.type == "text").strip().lower()
    if chu not in ("dung", "sai"):
        raise ValueError(f"mô hình chấm trả về ngoài định dạng: {chu!r}")
    return chu == "dung"


class MoHinhChamGia:
    """Thay cho API: trả kết quả chấm ghi sẵn theo thứ tự (giả định), để bài chạy không cần mạng."""
    def __init__(self, ket_qua):
        self.ket_qua = list(ket_qua)
        self.messages = self

    def create(self, **kw):
        from types import SimpleNamespace as NS
        return NS(stop_reason="end_turn", content=[NS(type="text", text=self.ket_qua.pop(0))])


def chay_thu():
    client = MoHinhChamGia(["dung", "dung", "sai", "dung"])
    dong, tong_code, tong_mh = [], 0, 0
    for cau_hoi, dap_an, tu_khoa, tra_loi in CA:
        c = cham_code(tra_loi, tu_khoa)
        m = cham_mo_hinh(client, cau_hoi, dap_an, tra_loi)
        tong_code += c
        tong_mh += m
        dong.append(f"{cau_hoi:<36} code: {'đạt' if c else 'trượt':<5} mô hình: {'đạt' if m else 'trượt'}")
    dong.append(f"Tổng: chấm bằng code {tong_code}/{len(CA)}, chấm bằng mô hình {tong_mh}/{len(CA)}")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Kết quả cho thấy điểm mạnh, điểm yếu của từng cách. Câu "Bảo lưu tối đa bao lâu?" được trả lời "sáu tháng" bằng chữ: chấm bằng code đánh trượt vì không thấy "6 tháng", trong khi chấm bằng mô hình nhận ra cùng nghĩa. Câu "Lớp học ở phòng nào?" thì tài liệu không có thông tin nhưng chatbot bịa ra "phòng 302": cả hai cách đều đánh trượt, và đây chính là lỗi quan trọng nhất cần bắt. Tổng cộng, chấm bằng code cho 2/4 còn chấm bằng mô hình cho 3/4. Trong dự án thật, hãy kiểm tay vài chục câu để biết bộ chấm nào sát với đánh giá của người hơn.
Đưa eval vào quy trình
Bộ đánh giá có ích nhất khi chạy thường xuyên. Lưu bộ câu hỏi và đáp án trong kho code; chạy eval mỗi khi đổi prompt, đổi mô hình, đổi cách chia đoạn tài liệu; ghi lại điểm theo từng phiên bản; và chỉ chấp nhận thay đổi khi điểm không giảm. Có thể cho eval chạy tự động trong GitHub Actions như chạy test thông thường, với một bộ nhỏ để tiết kiệm chi phí gọi API.
Mỗi khi người dùng gặp một câu trả lời sai ngoài thực tế, thêm câu đó vào bộ đánh giá. Theo thời gian, bộ đánh giá trở thành tài sản quý nhất của dự án: nó ghi lại mọi lỗi bạn đã gặp và bảo đảm chúng không quay lại.
Viết tiêu chí chấm cho rõ
Phần lớn sai lệch của bộ chấm bằng mô hình đến từ tiêu chí mơ hồ. "Câu trả lời có tốt không?" là tiêu chí tồi, vì mỗi lần chấm mô hình có thể hiểu "tốt" theo một kiểu. Tiêu chí tốt nói rõ điều gì làm câu trả lời đúng, điều gì làm nó sai, và cách xử lý các trường hợp đặc biệt. Trong ví dụ, tiêu chí chấp nhận cách viết khác của cùng một ý (số viết bằng chữ), cấm thêm thông tin không có trong đáp án, và quy định riêng cho câu hỏi ngoài tài liệu: phải nói không tìm thấy, đưa thông tin cụ thể là sai. Khi bạn thấy mô hình chấm và người chấm không đồng ý ở một câu, thường là tiêu chí đang thiếu một quy tắc; bổ sung quy tắc đó và chạy lại.
Chi phí của việc đo
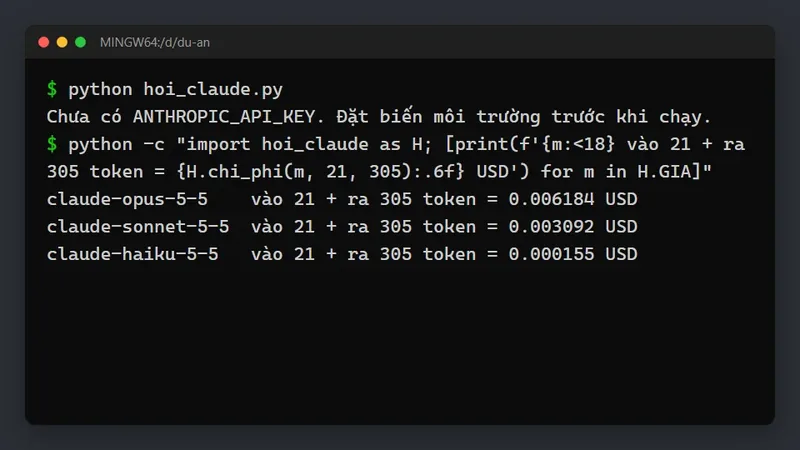
Mỗi lần chạy eval gọi mô hình cho mọi câu hỏi, và nếu chấm bằng mô hình thì gọi thêm một lần nữa cho mỗi câu. Với 50 câu, chi phí thường nhỏ, nhưng sẽ tăng nhanh nếu bạn chạy liên tục trên mô hình đắt. Cách cân đối: dùng chấm bằng code cho mọi câu có thể, chỉ chấm bằng mô hình cho câu cần hiểu nghĩa, và giữ một bộ nhỏ để chạy thường xuyên cùng một bộ đầy đủ chạy trước khi phát hành. Ước tính chi phí theo số token như trong bài gọi API AI bằng Python.
- Đánh giá bằng cảm giác sau vài câu thử trong giao diện chat.
- Bộ câu mẫu chỉ có câu dễ, không có câu ngoài phạm vi tài liệu.
- Chấm bằng mô hình mà tiêu chí mơ hồ, đầu ra là đoạn văn dài khó tổng hợp.
- Dùng chính mô hình đã tạo câu trả lời để tự chấm mình.
- Đổi prompt rồi phát hành mà không chạy lại bộ đánh giá.
Câu hỏi thường gặp
Cần bao nhiêu câu hỏi mẫu?
Bắt đầu với vài chục câu là đủ để thấy khác biệt lớn giữa các phiên bản. Tăng dần theo thời gian bằng các câu sai gặp ngoài thực tế. Tài liệu Claude khuyên ưu tiên số lượng câu chấm tự động.
Mô hình chấm có đáng tin không?
Đáng tin khi tiêu chí rõ và đã được kiểm với người chấm trên một mẫu nhỏ. Tài liệu dặn kiểm độ tin cậy trước khi dùng rộng.
Có công cụ nào làm sẵn không?
Có nhiều thư viện và nền tảng đánh giá mã nguồn mở. Nhưng nên tự viết một bộ nhỏ như ví dụ trước để hiểu bản chất, rồi mới dùng công cụ.
Eval khác unit test thế nào?
Unit test kiểm code cho kết quả xác định. Eval kiểm đầu ra của mô hình vốn có thể thay đổi, nên đo theo tỉ lệ đạt trên một bộ câu, không phải đúng hoặc sai tuyệt đối từng lần.
Học tiếp
- Ứng dụng cần đánh giá nhất: RAG là gì.
- Dùng eval để so phiên bản prompt: prompt engineer là gì.
- Ước tính chi phí gọi API khi chạy eval: gọi API AI bằng Python.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.