- Thứ tự cân nhắc: đo bằng bộ đánh giá, viết prompt tốt hơn, dùng RAG nếu thiếu kiến thức, rồi mới fine-tune nếu còn lý do cụ thể.
- Tài liệu Model optimization của OpenAI (đọc ngày 11/11/2026) viết rằng quá trình viết prompt có thể là tất cả những gì bạn cần, và mô tả vòng lặp: viết bộ đánh giá làm mốc, viết prompt, có thể fine-tune, đo lại, sửa, lặp.
- Fine-tune đổi cách mô hình làm việc (định dạng, giọng văn, một việc hẹp); RAG đổi điều mô hình biết lúc trả lời.
- LoRA giữ nguyên trọng số gốc và chỉ học hai ma trận nhỏ; bài báo gốc báo cáo giảm số tham số phải huấn luyện tới 10.000 lần so với tinh chỉnh toàn bộ GPT-3 175B.
Bài này dựa trên tài liệu Model optimization của OpenAI, trang tổng quan prompt engineering của Anthropic, bài báo LoRA (arXiv 2106.09685) và tài liệu PEFT của Hugging Face, đọc ngày 11/11/2026.
Fine-tuning là gì
Một mô hình ngôn ngữ lớn đã được huấn luyện trước trên lượng văn bản khổng lồ. Fine-tuning là huấn luyện tiếp mô hình đó trên một tập dữ liệu nhỏ hơn, gồm các ví dụ đầu vào và đầu ra đúng cho việc bạn cần, để nó làm việc đó tốt và ổn định hơn. Kết quả là một phiên bản mô hình mới mang "thói quen" học từ dữ liệu của bạn.
Phân biệt với hai cách còn lại: viết prompt là thay đổi chỉ dẫn mỗi lần gọi, mô hình không đổi; RAG là đưa thêm tài liệu liên quan vào prompt lúc hỏi, mô hình cũng không đổi; fine-tuning thì thay đổi chính mô hình.
Thử cách rẻ trước
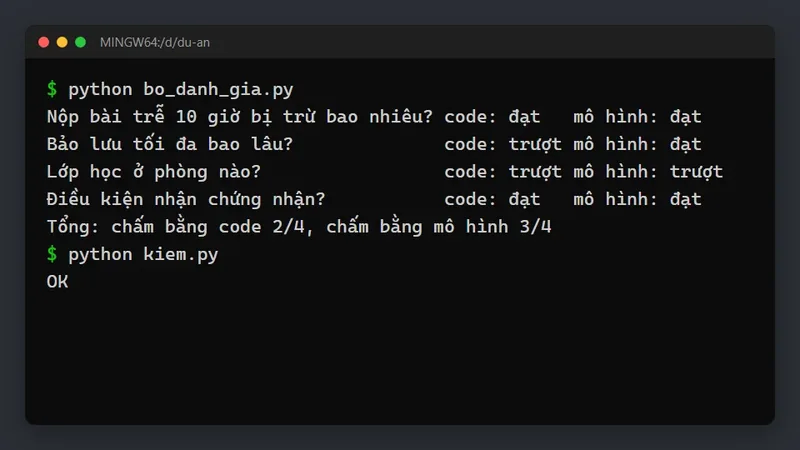
Cả Anthropic và OpenAI đều đặt viết prompt và đo lường trước fine-tuning. Trang tổng quan của Anthropic yêu cầu có tiêu chí thành công và cách kiểm thử trước khi tinh chỉnh prompt, và lưu ý có những mục tiêu như độ trễ, chi phí mà đổi mô hình hiệu quả hơn sửa câu chữ. Tài liệu Model optimization của OpenAI mô tả một vòng lặp: viết bộ đánh giá để có mốc, viết prompt, có thể fine-tune, chạy đánh giá trên dữ liệu đại diện, sửa prompt hoặc dữ liệu huấn luyện, rồi lặp lại; tài liệu nói rõ quá trình viết prompt có thể là tất cả những gì bạn cần.
Lý do rất thực tế. Viết prompt và RAG có thể sửa trong vài phút, không cần chuẩn bị dữ liệu huấn luyện, không tạo ra một mô hình mới phải quản lý. Fine-tuning cần dữ liệu chất lượng, cần thời gian huấn luyện, và mỗi lần mô hình gốc được nâng cấp bạn có thể phải làm lại.
Khi nào fine-tuning đáng làm
Tài liệu của OpenAI liệt kê các lợi thế của fine-tuning so với chỉ viết prompt: huấn luyện được trên nhiều ví dụ hơn số ví dụ vừa với một lần gọi; dùng prompt ngắn hơn, giảm chi phí token và độ trễ khi gọi rất nhiều lần; học từ dữ liệu riêng mà không phải gửi kèm trong mỗi lần gọi; và huấn luyện một mô hình nhỏ hơn, rẻ hơn, nhanh hơn cho một việc cụ thể. Tài liệu cũng nêu các loại fine-tuning: tinh chỉnh có giám sát (học từ các câu trả lời đúng; hợp với phân loại, định dạng đầu ra đặc thù, sửa lỗi làm theo chỉ dẫn), tinh chỉnh với ảnh, và tối ưu theo sở thích trực tiếp (học từ cặp câu trả lời tốt và kém; hợp với giọng văn, trọng tâm khi tóm tắt).
Một lưu ý về thời điểm: trang này ghi OpenAI đang dừng dần nền tảng fine-tuning của họ, người dùng mới không còn truy cập được (đọc ngày 11/11/2026). Dịch vụ fine-tuning của các hãng thay đổi theo thời gian; nhiều người học hiện tinh chỉnh mô hình mở bằng thư viện như PEFT của Hugging Face.
Ngược lại, fine-tuning thường không phải lời giải khi vấn đề là mô hình thiếu thông tin cập nhật hay tài liệu riêng (dùng RAG, xem RAG là gì), hoặc khi bạn chưa có bộ đánh giá để biết mô hình đang sai ở đâu (xem đánh giá câu trả lời của AI).
LoRA: tinh chỉnh mà chỉ học rất ít tham số
Tinh chỉnh toàn bộ một mô hình lớn rất tốn: phải lưu và cập nhật mọi tham số, và mỗi phiên bản tinh chỉnh là một bản sao đầy đủ. Bài báo LoRA (Hu và cộng sự, 2021) đề xuất giữ nguyên trọng số đã huấn luyện, và chèn vào mỗi tầng của Transformer các ma trận phân rã hạng thấp có thể huấn luyện. Thay vì cập nhật cả ma trận trọng số kích thước d × k, LoRA học hai ma trận nhỏ d × r và r × k với hạng r rất nhỏ. Tóm tắt bài báo nêu so với tinh chỉnh GPT-3 175B bằng Adam, LoRA có thể giảm số tham số phải huấn luyện 10.000 lần và bộ nhớ GPU 3 lần, trong khi chất lượng ngang hoặc tốt hơn trên các mô hình được thử.
Thư viện PEFT của Hugging Face hiện thực LoRA và nhiều phương pháp tương tự. Trang giới thiệu của PEFT viết các phương pháp này chỉ tinh chỉnh một số nhỏ tham số (thêm vào), giảm đáng kể chi phí tính toán và lưu trữ mà vẫn cho hiệu quả tương đương tinh chỉnh toàn bộ, nhờ đó huấn luyện được mô hình lớn trên phần cứng phổ thông.
Tính bằng Python
Đoạn code dưới đây làm hai việc. Thứ nhất, liệt kê gợi ý chọn cách theo từng loại vấn đề, tóm từ các tài liệu trên. Thứ hai, tính số tham số phải huấn luyện cho một ma trận trọng số khi tinh chỉnh toàn bộ so với LoRA, theo công thức d × k và r × (d + k).
"""Hai phép tính giúp quyết định giữa viết prompt, RAG và fine-tuning.

1. Gợi ý cách làm theo vấn đề gặp phải (dựa trên tài liệu OpenAI model optimization và Anthropic prompt
   engineering, đọc ngày 11/11/2026: thử prompt trước, đo bằng eval, chỉ fine-tune khi có lý do cụ thể).
2. Số tham số phải huấn luyện: tinh chỉnh toàn bộ một ma trận trọng số d x k so với LoRA hạng r,
   vốn chỉ học hai ma trận nhỏ d x r và r x k (bài báo LoRA, Hu và cộng sự, 2021).
"""

GOI_Y = {
    "thiếu kiến thức riêng": "RAG: đưa tài liệu vào lúc hỏi; sửa tài liệu là cập nhật được",
    "sai định dạng đầu ra": "viết prompt rõ hơn + ví dụ; nếu vẫn sai nhiều sau khi đo thì cân nhắc fine-tune",
    "prompt quá dài, gọi rất nhiều lần": "fine-tune để rút ngắn prompt, giảm token và độ trễ",
    "cần mô hình nhỏ, rẻ cho một việc hẹp": "fine-tune một mô hình nhỏ trên dữ liệu của việc đó",
    "chưa có bộ đánh giá": "làm bộ đánh giá trước; chưa đo được thì chưa biết cách nào tốt hơn",
}


def tham_so(d, k, r):
    """Trả về (tham số khi tinh chỉnh toàn bộ, tham số LoRA)."""
    return d * k, r * (d + k)


def so_viet(n):
    return f"{n:,}".replace(",", ".")


def chay_thu():
    dong = [f"- {van_de}: {cach}" for van_de, cach in GOI_Y.items()]
    for d, k, r in [(4096, 4096, 8), (4096, 4096, 64), (768, 768, 8)]:
        toan_bo, lora = tham_so(d, k, r)
        dong.append(f"Ma trận {d}x{k}, LoRA hạng {r}: toàn bộ {so_viet(toan_bo)} tham số, "
                    f"LoRA {so_viet(lora)} ({toan_bo // lora} lần ít hơn)")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Với một ma trận 4096 × 4096 (cỡ thường gặp trong mô hình ngôn ngữ vài tỉ tham số), tinh chỉnh toàn bộ phải học 16.777.216 tham số, còn LoRA hạng 8 chỉ học 65.536, ít hơn 256 lần; hạng 64 là 524.288, ít hơn 32 lần. Với ma trận nhỏ 768 × 768, LoRA hạng 8 ít hơn 48 lần. Con số cho thấy vì sao sinh viên có thể tinh chỉnh mô hình mở vừa phải trên một GPU phổ thông hoặc dịch vụ notebook trên mây.
Chuẩn bị dữ liệu nếu quyết định fine-tune
Chất lượng dữ liệu quyết định kết quả. Vài nguyên tắc: mỗi ví dụ là đúng cặp đầu vào và đầu ra bạn mong muốn ngoài thực tế; ví dụ đa dạng, phủ cả trường hợp khó; không lẫn dữ liệu cá nhân hay dữ liệu không được phép dùng; và tách riêng một phần làm tập đánh giá, không dùng để huấn luyện. So mô hình đã tinh chỉnh với mốc ban đầu (prompt tốt nhất trên mô hình gốc) trên cùng bộ đánh giá; nếu không hơn rõ rệt, giữ cách đơn giản.
Một ví dụ quyết định
Giả sử bạn làm công cụ phân loại phản hồi học viên thành ba nhãn. Bản đầu dùng một prompt ngắn và đúng 70% trên bộ đánh giá 100 câu. Thêm định nghĩa nhãn và năm ví dụ vào prompt, kết quả lên 90%: đây là lúc dừng lại nếu 90% đủ dùng. Nếu cần cao hơn, và công cụ sẽ chạy hàng trăm nghìn lần mỗi tháng nên prompt dài với nhiều ví dụ làm chi phí tăng, thì fine-tune một mô hình nhỏ trên vài nghìn phản hồi đã gán nhãn có thể vừa tăng độ chính xác vừa giảm chi phí. Quyết định dựa trên số đo của bộ đánh giá và chi phí thực tế, không dựa trên cảm giác rằng fine-tuning "xịn hơn".
- Fine-tune ngay khi gặp vấn đề, chưa thử viết prompt tốt hơn và chưa đo.
- Fine-tune để "dạy" mô hình kiến thức hay thay đổi, trong khi RAG hợp hơn.
- Không giữ tập đánh giá riêng, rồi đánh giá trên chính dữ liệu đã huấn luyện.
- Đưa dữ liệu cá nhân của người dùng vào tập huấn luyện mà không xin phép.
- Quên rằng mỗi lần mô hình gốc thay đổi, bản tinh chỉnh có thể phải làm lại.
Câu hỏi thường gặp
Fine-tuning có làm mô hình biết thêm kiến thức mới không?
Có thể phần nào, nhưng không phải cách tốt để cập nhật kiến thức thay đổi thường xuyên. Với tài liệu riêng và thông tin mới, RAG dễ cập nhật và kiểm nguồn hơn.
Cần bao nhiêu ví dụ để fine-tune?
Tùy việc và mô hình. Bắt đầu với một tập nhỏ chất lượng cao, đo trên tập đánh giá riêng, rồi tăng dần nếu thấy cải thiện.
Sinh viên có tự fine-tune được không?
Được, với mô hình mở cỡ vừa và các phương pháp như LoRA qua thư viện PEFT, trên GPU phổ thông hoặc notebook trên mây. Xem cách chạy mô hình mở trên máy trong bài chạy AI trên máy cá nhân.
Fine-tune xong có cần prompt nữa không?
Vẫn cần, nhưng thường ngắn hơn, vì mô hình đã học sẵn định dạng và cách làm. Đó cũng là một lý do fine-tune giúp giảm chi phí khi gọi rất nhiều lần.
Học tiếp
- Khi vấn đề là thiếu kiến thức: RAG là gì.
- Đo trước khi quyết định: đánh giá câu trả lời của AI.
- Chạy và thử mô hình mở trên máy: chạy AI trên máy cá nhân.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.