- Chọn cách lưu theo thao tác cần thực hiện, không chỉ theo hình vẽ đồ thị.
- Cạnh vô hướng thường được thêm vào danh sách kề ở cả hai đầu.
- Ma trận n×n cần bộ nhớ theo n² kể cả khi đồ thị chỉ có vài cạnh.
Đỉnh, cạnh và quy ước đầu vào
Một đồ thị gồm tập đỉnh và các quan hệ nối giữa chúng gọi là cạnh. Có thể dùng đỉnh cho thành phố, trạng thái hoặc công việc; cạnh biểu diễn đường đi, phép chuyển trạng thái hoặc quan hệ phụ thuộc. Trước khi viết code, cần chốt quan hệ có hướng hay không và mỗi cạnh có trọng số hay không.
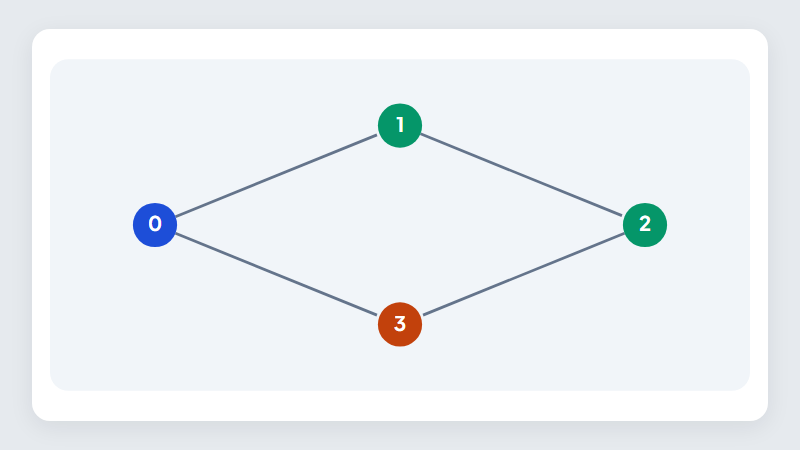
Ví dụ xuyên suốt dùng đồ thị vô hướng đơn gồm năm đỉnh 0 tới 4 và năm cạnh (0,1), (0,2), (1,3), (2,3), (3,4). “Đơn” ở đây nghĩa là không có cạnh song song và không có khuyên tự nối một đỉnh. Quy ước này giúp danh sách kề và ma trận nhị phân ghi đúng cùng một loại dữ liệu.
Đừng đổi giữa chỉ số 0 và 1 một cách ngầm định. Nếu đề đánh số từ 1 tới n, có thể trừ 1 khi đọc hoặc cấp vùng n+1 và giữ nguyên nhãn. Cách nào cũng được nếu tất cả các mảng visited, parent, distance và danh sách kề dùng cùng quy ước.
Danh sách cạnh: lưu đúng những gì nhập vào
Danh sách cạnh lưu mỗi cạnh dưới dạng cặp u, v; nếu có trọng số thì thêm w. Với đồ thị vô hướng, một dòng nhập thường chỉ lưu một bản cạnh trong danh sách này. Khi thuật toán cần cả hai chiều, nó tự xử lý theo mô hình, không nhất thiết phải nhân đôi ngay mọi nơi.
Ưu điểm là đơn giản và thuận tiện để sắp xếp cạnh theo trọng số trong Kruskal, hoặc quét mọi cạnh trong Bellman–Ford. Điểm yếu là nếu thường xuyên hỏi mọi hàng xóm của một đỉnh, quét lại toàn danh sách m cạnh mỗi lần có thể tốn nhiều công hơn cần thiết.
Danh sách kề: nhóm cạnh theo đỉnh xuất phát
Tạo n danh sách, danh sách adj[u] chứa các đỉnh đi tới được bằng một cạnh từ u. Với cạnh vô hướng u–v, thêm v vào adj[u] và thêm u vào adj[v]. Với cạnh có hướng u→v, chỉ thêm v vào adj[u] trừ khi bạn chủ động xây thêm đồ thị đảo.
| Đỉnh | Hàng xóm theo ví dụ | Bậc |
|---|---|---|
| 0 | 1, 2 | 2 |
| 1 | 0, 3 | 2 |
| 2 | 0, 3 | 2 |
| 3 | 1, 2, 4 | 3 |
| 4 | 3 | 1 |
Tổng số mục kề của đồ thị vô hướng là 2m, vì mỗi cạnh xuất hiện ở hai đầu. Cộng cột bậc được 10, bằng hai lần năm cạnh. Với đồ thị có hướng, cần phân biệt bán bậc ra và bán bậc vào; độ dài adj[u] chỉ cho bán bậc ra của u.
Trong C++, thường dùng vector<vector(v,w). Trong Python, tạo từng hàng độc lập bằng comprehension. Cách viết [[]] * n làm các đỉnh dùng chung một list, khiến thêm hàng xóm cho một đỉnh lại thay đổi nhiều hàng khác.
Ma trận kề: một ô cho một cặp đỉnh
Ma trận a có n hàng và n cột. Đồ thị không trọng số đơn đặt a[u][v] bằng 1 nếu có cạnh và 0 nếu không. Đồ thị vô hướng cho ma trận đối xứng vì a[u][v] và a[v][u] cùng được bật. Trên ví dụ, hàng của đỉnh 3 là 0 1 1 0 1.
Kiểm một cạnh cụ thể chỉ cần đọc một ô, O(1). Nhưng muốn duyệt toàn bộ hàng xóm của một đỉnh, bạn phải quét n ô trong hàng dù chỉ có một hàng xóm. Bộ nhớ O(n²) là chi phí cốt lõi, không được suy từ m nhỏ rồi gọi ma trận tiết kiệm.
Với cạnh có trọng số, giá trị 0 không thể vừa mang nghĩa không có cạnh vừa mang nghĩa cạnh trọng số 0. Nên dùng giá trị INF cho không có đường trực tiếp trong bài đường đi ngắn nhất, và đặt đường chéo bằng 0 theo quy ước khoảng cách rỗng. Nếu nhiều cạnh song song, ô trọng số thường giữ min khi chỉ quan tâm đường ngắn nhất.
Chủ đề này nằm trong Lecture 09 - BFS & DFS (Duyệt đồ thị) của Khóa Blue 2.0. Xem đề cương
Code chuyển đổi và tính bậc
#include <algorithm>
#include <functional>
#include <iostream>
#include <numeric>
#include <queue>
#include <tuple>
#include <utility>
#include <vector>
using namespace std;
const long long INF=1LL<<60;
vector<int> degrees(int n,const vector<pair<int,int>>&edges){
    vector<vector<int>> adj(n);vector<vector<int>> mat(n,vector<int>(n));
    for(auto[u,v]:edges){adj[u].push_back(v);adj[v].push_back(u);mat[u][v]=mat[v][u]=1;}
    vector<int>ans;for(const auto&row:adj)ans.push_back((int)row.size());
    for(const auto&row:mat)for(int x:row)ans.push_back(x);
    return ans;
}

int main(){int n=5,m;vector<pair<int,int>>edges={{0,1},{0,2},{1,3},{2,3},{3,4}};
if(cin>>n>>m){edges.resize(m);for(auto&[u,v]:edges)cin>>u>>v;}
for(auto x:degrees(n,edges)) { cout<<x<<' '; }
cout<<'\n';}
INF=1<<60
def solve(n,edges,s=0):
    adj=[[] for _ in range(n)]
    mat=[[0]*n for _ in range(n)]
    for u,v in edges:
        adj[u].append(v);adj[v].append(u)
        mat[u][v]=mat[v][u]=1
    return [len(row) for row in adj]+[x for row in mat for x in row]

if __name__=='__main__':
    import sys
    d=list(map(int,sys.stdin.read().split()))
    if d:
        n,m=d[:2];off=2;s=0 if off==2 else d[2]
        width=2;edges=[tuple(d[i:i+width]) for i in range(off,off+width*m,width)]
    else:
        n,s,edges=5,0,[(0, 1), (0, 2), (1, 3), (2, 3), (3, 4)]
    print(*solve(n,edges,s))
Tệp mặc định dựng đồ thị trong hình. Đầu ra bắt đầu bằng năm số bậc 2 2 2 3 1, sau đó là 25 ô ma trận theo từng hàng ghép nối. Chương trình in gọn trên từng dòng để dễ đọc; khi quan sát ma trận kề, bạn có thể tách mỗi nhóm n số thành một hàng.
Dữ liệu riêng bắt đầu bằng n và m, rồi m cặp đỉnh. Code giả định đồ thị vô hướng đơn và chỉ số trong 0..n−1. Danh sách kề cho phép ghi nhiều mục trùng, trong khi ma trận nhị phân chỉ có một ô; nếu cho phép cạnh song song, hai cách không còn lưu cùng thông tin số lượng cạnh. Không dùng phép so bậc bằng tổng hàng ma trận mà bỏ qua điều kiện này.
Chọn cách lưu theo thuật toán
BFS, DFS và Dijkstra trên đồ thị thưa thường dùng danh sách kề để duyệt đúng các cạnh có mặt. Bellman–Ford cần quét mọi cạnh nên danh sách cạnh tự nhiên hơn. Floyd–Warshall xử lý mọi cặp đỉnh, vì vậy ma trận khoảng cách là cấu trúc trung tâm.
| Cách lưu | Bộ nhớ | Kiểm u có cạnh tới v | Duyệt hàng xóm u |
|---|---|---|---|
| Danh sách cạnh | O(m) | O(m) nếu quét thẳng | O(m) nếu quét thẳng |
| Danh sách kề dạng vector/list | O(n+m) | O(deg(u)) nếu chưa có chỉ mục khác | O(deg(u)) |
| Ma trận kề | O(n²) | O(1) | O(n) |
Các cận này nói về cách cài đang mô tả. Dùng set hoặc bảng băm cho từng hàng có thể đổi chi phí tra cứu, nhưng cũng đổi bộ nhớ và điều kiện bảo đảm. Đừng cộng thêm cấu trúc phức tạp nếu truy vấn của bài không cần nó.
Luyện ngay và tự kiểm mô hình
Thử một đỉnh cô lập, đồ thị không có cạnh và đồ thị đầy đủ nhỏ. Với đồ thị vô hướng đơn, kiểm tổng bậc bằng 2m và ma trận đối xứng. Bạn cũng có thể đếm bậc trực tiếp từ danh sách cạnh ban đầu rồi đối chiếu với kích thước từng danh sách kề để phát hiện sớm lỗi thêm thiếu hướng cạnh.
Ba bài dưới luyện bậc, chuyển cạnh sang danh sách kề và phân biệt bán bậc vào/ra.
Câu hỏi thường gặp
Có phải đồ thị luôn cần vẽ được trên mặt phẳng không?
Không. Hình chỉ giúp hiểu ví dụ; chương trình làm việc với quan hệ giữa nhãn đỉnh. Nhiều đồ thị không thể vẽ không giao cạnh trên mặt phẳng.
Có nên sắp xếp mọi danh sách kề không?
Chỉ khi cần thứ tự duyệt hoặc truy vấn phù hợp. BFS/DFS tìm khả năng đi tới không bắt buộc hàng xóm phải tăng dần.
Đỉnh cô lập lưu ở đâu nếu không có cạnh nhập vào?
Vẫn phải có trong số n đỉnh và trong các mảng trạng thái. Nếu chỉ tạo đỉnh khi gặp cạnh, bạn có thể bỏ sót thành phần cô lập.
Luyện phỏng vấn Google, Meta, Amazon theo Interview Patterns: 16 buổi online live, lớp 7–15 người, C++/Python/Java. Học thử buổi 1 miễn phí.