- Bản chất của Cấu trúc dữ liệu: Mỗi cấu trúc đánh đổi cách tổ chức bộ nhớ để tăng tốc đột biến thao tác mà bài toán cần nhất (từ
O(n)xuốngO(log n)hoặcO(1)). - Lộ trình 4 tầng từ dễ đến khó: (1) Tuyến tính & Tra cứu nhanh (
Stack,Queue,Deque,Linked List,Hash Table,Heap) → (2) Cây & Tập hợp động (Binary Tree,BST,Trie,DSU) → (3) Đồ thị (BFS,DFS,Dijkstra,MST,LCA) → (4) Quy hoạch động & Truy vấn đoạn (DP,BIT,Segment Tree). - Quy tắc chọn nhanh: Vào sau ra trước →
Stack; vào trước ra trước / loang từng lớp →Queue; tra cứu khóa trongO(1)→Hash Table; lấy min/max động liên tục →Heap; tìm phần tử lớn hơn/nhỏ hơn gần nhất trên tập động →BST (std::set / std::map).
Vì sao chỉ biết mảng và vòng lặp là chưa đủ?
Sau khi hoàn thành giai đoạn nhập môn lập trình và thuật toán, bạn đã quen với việc lưu dữ liệu vào mảng tĩnh (hoặc std::vector / list), dùng sắp xếp, tìm kiếm nhị phân, mảng cộng dồn và hai con trỏ. Các kỹ thuật này rất mạnh khi dữ liệu đứng yên (tĩnh) hoặc chỉ truy cập tuần tự theo chỉ số.
Tuy nhiên, trong các kỳ thi Học sinh giỏi Tin học, ICPC hay vòng phỏng vấn kỹ thuật của các công ty công nghệ, dữ liệu thường biến động liên tục (dynamic):
- Hàng trăm nghìn phần tử mới được thêm vào và xóa đi liên tục; sau mỗi lần thêm, đề bài hỏi ngay: "Phần tử lớn nhất hiện tại là bao nhiêu?" hoặc "Số nhỏ nhất lớn hơn hoặc bằng
Xtrong tập hợp hiện tại là số nào?". - Nếu dùng mảng thường và sắp xếp lại sau mỗi lần thêm, bạn mất
O(q × n log n)— có nguy cơ vượt thời gian (Time Limit Exceeded) khin, q = 10⁵(xem cách ước lượng số bước tại bài độ phức tạp thuật toán Big-O). - Hoặc dữ liệu không còn nằm trên một dãy thẳng nữa, mà biểu diễn mạng lưới giao thông, cây phân cấp, hay các nhóm liên thông gộp lại với nhau.
Đó là lúc bạn bước sang chủ đề Cấu trúc dữ liệu và giải thuật — nơi bạn học cách tổ chức dữ liệu thành Ngăn xếp, Hàng đợi, Bảng băm, Đống nhị phân, Cây cân bằng, Đồ thị và Bảng quy hoạch động.
Bản đồ tổng thể 4 tầng của Cấu trúc dữ liệu và giải thuật
Hãy nhìn toàn bộ chủ đề Cấu trúc dữ liệu và giải thuật như một tòa nhà gồm 4 tầng xây nối tiếp nhau:
| Tầng | Tên nhóm chuyên đề | Các cấu trúc & thuật toán cốt lõi | Năng lực đạt được sau khi học xong |
|---|---|---|---|
| Tầng 1 | Cấu trúc tuyến tính & Tra cứu nhanh | Ngăn xếp (Stack), Hàng đợi (Queue), Ngăn xếp đơn điệu, Hàng đợi hai đầu (Deque), Danh sách liên kết, Bảng băm (Hash Table), Hàng đợi ưu tiên (Heap) | Khử vòng lặp O(n²) xuống O(n) hoặc O(n log n) bằng tra cứu O(1), duy trì cực trị động và quản lý thứ tự vào/ra |
| Tầng 2 | Cây & Tập hợp động | Cây nhị phân (Binary Tree), Cây tìm kiếm nhị phân (BST / set / map), Cây tiền tố (Trie), Tập hợp rời rạc (Disjoint Set Union — DSU) | Duyệt cấu trúc phân cấp, tìm kiếm tiền tố chuỗi, quản lý tập hợp có thứ tự động và gộp thành phần liên thông với chi phí khấu hao O(α(n)) khi dùng đủ hai tối ưu |
| Tầng 3 | Thuật toán trên Đồ thị | Duyệt BFS, DFS, Sắp xếp Tô-pô, Đường đi ngắn nhất (Dijkstra, Bellman-Ford, Floyd-Warshall), Cây khung nhỏ nhất (Kruskal, Prim), Tarjan SCC, Tổ tiên chung gần nhất (LCA) | Mô hình hóa bản đồ, mạng lưới phụ thuộc công việc, tìm đường đi chi phí nhỏ nhất và phân tích cấu trúc mạng |
| Tầng 4 | Quy hoạch động & Truy vấn đoạn | Quy hoạch động 1D/2D, Cái túi (Knapsack), Dãy con tăng dài nhất (LIS), Dãy con chung dài nhất (LCS), Bitmask DP, Tree DP, Cây Fenwick (BIT), Cây phân đoạn (Segment Tree) | Giải bài toán tối ưu đa giai đoạn bằng bảng phương án con và xử lý truy vấn/cập nhật trên đoạn trong O(log n) |
Tầng 1: Cấu trúc tuyến tính, Bảng băm và Hàng đợi ưu tiên
Tầng 1 là nền tảng để luyện bài phỏng vấn và xây dựng các thuật toán đồ thị ở Tầng 3:
- Ngăn xếp (Stack) và Ngăn xếp đơn điệu (Monotonic Stack):
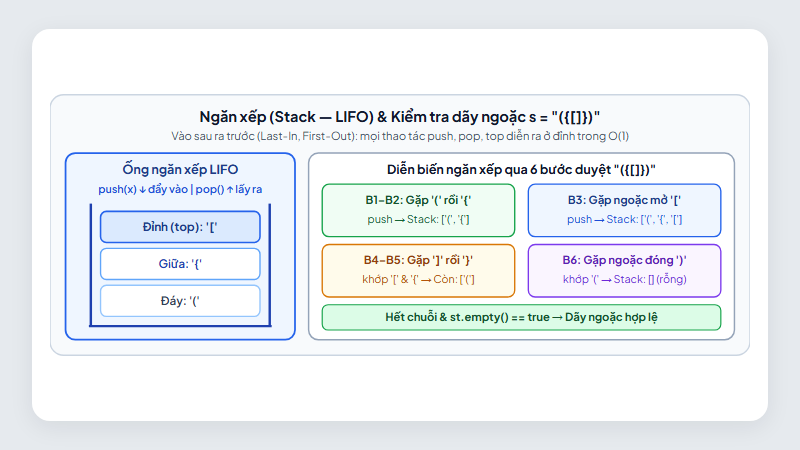
Ngăn xếp hoạt động theo cơ chế LIFO (Last In, First Out — Vào sau ra trước) với mọi thao tác
push,pop,topđều tốnO(1), chuyên trị bài toán kiểm tra dấu ngoặc, tính biểu thức hậu tố và mô phỏng đệ quy. Khi giữ các phần tử trong ngăn xếp theo thứ tự đơn điệu tăng hoặc giảm (Monotonic Stack), ta tìm được phần tử lớn hơn/nhỏ hơn gần nhất về hai phía cho toàn bộ mảng chỉ trongO(n). - Hàng đợi (Queue) và Hàng đợi hai đầu (Deque):
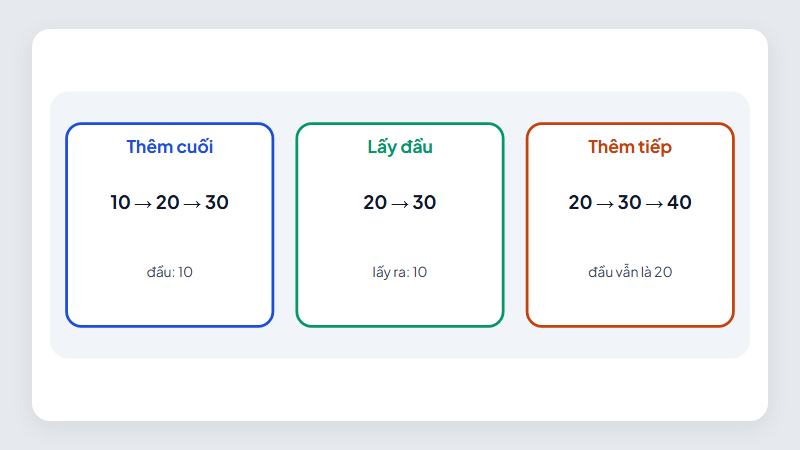
Hàng đợi hoạt động theo cơ chế FIFO (First In, First Out — Vào trước ra trước), thêm ở cuối và lấy ở đầu trong
O(1), là nền tảng của thuật toán duyệt đồ thị theo chiều rộng (BFS). Mở rộng hơn, Deque cho phép thêm/xóa ở cả hai đầu trongO(1)và tìm cực trị trên cửa sổ trượt độ dàiKtrongO(n). - Danh sách liên kết (Linked List):
Các nút (
Node) nối với nhau bằng con trỏnext/prev, cho phép chèn hoặc xóa một nút khi đã biết vị trí con trỏ trongO(1)mà không cần dồn mảng, đồng thời kết hợp với bảng băm để thiết kế bộ nhớ đệm LRU Cache. - Bảng băm (Hash Table): (
unordered_map,unordered_settrong C++;dict,settrong Python). Dùng hàm băm ánh xạ khóa sang chỉ số mảng thùng chứa, giúp thêm, xóa và tra cứu khóa trong thời gian trung bìnhO(1). - Hàng đợi ưu tiên (Priority Queue / Heap): (
priority_queuetrong C++;heapqtrong Python). Luôn giữ phần tử lớn nhất hoặc nhỏ nhất ở đỉnh gốc, giúp xem cực trị trongO(1)và thêm/lấy cực trị trongO(log n)— công cụ chủ lực cho các thuật toán tham lam và Dijkstra.
Ví dụ thực chiến: Chọn đúng CTDL hạ độ phức tạp từ O(n²) xuống O(n)
Hãy xem 3 bài toán kinh điển được giải gọn nhờ chọn đúng cấu trúc dữ liệu ở Tầng 1:
- Đếm cặp có tổng bằng
S: Thay vì hai vòng lặpO(n²), vừa duyệtxvừa kiểm traS - xđã có trong Bảng băm hay chưa chỉ mấtO(n). - Giữ
Kphần tử lớn nhất trên luồng dữ liệuNsố: Dùng Min-Heap kích thướcK; mỗi khi vượt quáKphần tử thì đẩy số nhỏ nhất ở đỉnh ra trongO(log K), tổng thời gianO(N log K)và bộ nhớO(K):
#include <functional>
#include <iostream>
#include <queue>
#include <unordered_map>
#include <vector>

using namespace std;

// 1. Dùng tần suất trong bảng băm; thời gian kỳ vọng O(n).
long long dem_cap_tong_bang_s(const vector<int>& a, int s) {
    unordered_map<long long, long long> tan_suat;
    long long so_cap = 0;
    for (int x : a) {
        auto it = tan_suat.find(1LL * s - x);
        if (it != tan_suat.end()) so_cap += it->second;
        ++tan_suat[x];
    }
    return so_cap;
}

// 2. Dùng Min-Heap kích thước K để giữ K phần tử lớn nhất trong O(n log K)
vector<int> top_k_lon_nhat(const vector<int>& luong, int k) {
    priority_queue<int, vector<int>, greater<int>> min_heap;
    for (int x : luong) {
        min_heap.push(x);
        if (static_cast<int>(min_heap.size()) > k) {
            min_heap.pop(); // Loại bỏ phần tử nhỏ nhất khi vượt quá K phần tử
        }
    }
    vector<int> kq;
    while (!min_heap.empty()) {
        kq.push_back(min_heap.top());
        min_heap.pop();
    }
    return kq;
}

int main() {
    vector<int> a = {4, -1, 7, 2, 9, 5, -3};
    cout << dem_cap_tong_bang_s(a, 6) << "\n";

    vector<int> luong = {12, 5, 23, 8, 31, 19, 4, 27};
    vector<int> top3 = top_k_lon_nhat(luong, 3);
    for (size_t i = 0; i < top3.size(); ++i) {
        cout << top3[i] << (i + 1 == top3.size() ? '\n' : ' ');
    }
    return 0;
}
import heapq


def dem_cap_tong_bang_s(a: list[int], s: int) -> int:
    """Đếm cặp chỉ số i < j bằng tần suất; thời gian kỳ vọng O(n)."""
    tan_suat: dict[int, int] = {}
    so_cap = 0
    for x in a:
        so_cap += tan_suat.get(s - x, 0)
        tan_suat[x] = tan_suat.get(x, 0) + 1
    return so_cap


def top_k_lon_nhat(luong: list[int], k: int) -> list[int]:
    """Dùng Min-Heap kích thước k giữ k phần tử lớn nhất trong O(n log k)."""
    min_heap: list[int] = []
    for x in luong:
        heapq.heappush(min_heap, x)
        if len(min_heap) > k:
            heapq.heappop(min_heap)
    return sorted(min_heap)


if __name__ == "__main__":
    a = [4, -1, 7, 2, 9, 5, -3]
    print(dem_cap_tong_bang_s(a, 6))

    luong = [12, 5, 23, 8, 31, 19, 4, 27]
    print(*top_k_lon_nhat(luong, 3))
Chương trình in ra 3 (3 cặp có tổng bằng 6) và 23 27 31 (3 số lớn nhất trong luồng).
- Tìm phần tử lớn hơn gần nhất ở bên phải (Next Greater Element): Dùng Ngăn xếp đơn điệu lưu chỉ số các phần tử đang chờ tìm số lớn hơn để giải toàn mảng trong
O(n):
#include <iostream>
#include <stack>
#include <vector>

using namespace std;

// Tìm phần tử lớn hơn gần nhất ở bên phải cho mọi vị trí trong O(n) bằng Ngăn xếp đơn điệu
vector<int> phan_tu_lon_hon_gan_nhat(const vector<int>& a) {
    int n = static_cast<int>(a.size());
    vector<int> kq(n, -1);
    stack<int> st; // Lưu chỉ số các phần tử đang chờ tìm số lớn hơn ở bên phải

    for (int i = 0; i < n; ++i) {
        while (!st.empty() && a[i] > a[st.top()]) {
            kq[st.top()] = a[i];
            st.pop();
        }
        st.push(i);
    }
    return kq;
}

int main() {
    vector<int> a = {2, 1, 5, 6, 2, 3};
    vector<int> kq = phan_tu_lon_hon_gan_nhat(a);
    for (size_t i = 0; i < kq.size(); ++i) {
        cout << kq[i] << (i + 1 == kq.size() ? '\n' : ' ');
    }
    return 0;
}
def phan_tu_lon_hon_gan_nhat(a: list[int]) -> list[int]:
    """Tìm phần tử lớn hơn gần nhất ở bên phải trong O(n) bằng Ngăn xếp đơn điệu."""
    n = len(a)
    kq = [-1] * n
    st: list[int] = []

    for i, x in enumerate(a):
        while st and x > a[st[-1]]:
            kq[st.pop()] = x
        st.append(i)
    return kq


if __name__ == "__main__":
    a = [2, 1, 5, 6, 2, 3]
    print(*phan_tu_lon_hon_gan_nhat(a))
Chương trình in ra kết quả 5 5 6 -1 3 -1 cho mảng [2, 1, 5, 6, 2, 3].
Tầng 2: Cấu trúc Cây, Tập hợp có thứ tự và DSU
Khi dữ liệu phân nhánh hoặc cần duy trì thứ tự tăng dần trong lúc thêm/xóa động, Tầng 2 cung cấp 4 cấu trúc:
- Cây nhị phân (Binary Tree): Mỗi nút có tối đa 2 con (
left,right). Gồm 4 phép duyệt nền tảng: Pre-order, In-order, Post-order và Level-order. - Cây tìm kiếm nhị phân (BST) và Cây cân bằng (
std::set,std::map): Mọi khóa bên trái nhỏ hơn nút gốc, mọi khóa bên phải lớn hơn nút gốc. Cây cân bằng (std::set,std::map,std::multiset) cho phép thêm, xóa VÀ gọilower_bound(tìm số đầu tiên≥ X) trên tập dữ liệu động trongO(log n)— điều Bảng băm không làm được. - Cây tiền tố (Trie): Mỗi cạnh là một chữ cái, giúp tìm kiếm hoặc đếm số từ có chung tiền tố
Ptrong thời gianO(|P|)và mở rộng sang Binary Trie cho bài toánXORcực đại. - Tập hợp rời rạc (Disjoint Set Union — DSU): Quản lý các nhóm phần tử rời nhau với 2 thao tác
find(u)vàunion(u, v)chạy trong thời gianO(α(n)) ≈ O(1)nhờ nén đường đi và gộp theo kích thước.
Tầng 3: Các thuật toán trên Đồ thị (Graph Algorithms)
Đồ thị gồm tập đỉnh V và tập cạnh E, thường biểu diễn bằng Danh sách kề (Adjacency List). Khi ghép nối các cấu trúc ở Tầng 1–2, ta có trọn bộ thuật toán đồ thị ở Tầng 3:
| Bài toán trên đồ thị | Thuật toán chuẩn | Cấu trúc dữ liệu bên dưới | Độ phức tạp |
|---|---|---|---|
| Duyệt đồ thị & Đường đi ngắn nhất không trọng số | BFS (Breadth-First Search) | Hàng đợi (Queue) | O(V + E) |
| Đếm thành phần liên thông, chu trình, đồ thị 2 phía | DFS (Depth-First Search) | Call Stack (Đệ quy) hoặc Stack | O(V + E) |
| Sắp xếp thứ tự công việc có điều kiện tiên quyết (DAG) | Sắp xếp Tô-pô (Topological Sort) | Hàng đợi (Kahn) hoặc DFS | O(V + E) |
| Đường đi ngắn nhất từ 1 đỉnh (trọng số không âm) | Thuật toán Dijkstra | Hàng đợi ưu tiên Min-Heap | O((V + E) log V) |
| Đường đi ngắn nhất có cạnh âm & chu trình âm | Thuật toán Bellman-Ford | Mảng khoảng cách + Danh sách cạnh | O(V × E) |
Đường đi ngắn nhất mọi cặp đỉnh (V ≤ 500) |
Thuật toán Floyd-Warshall | Ma trận 2 chiều dist[V][V] |
O(V³) |
| Cây khung nhỏ nhất (Minimum Spanning Tree) | Kruskal hoặc Prim | DSU (Kruskal) hoặc Min-Heap (Prim) | O(E log E) |
| Tìm khớp, cầu và thành phần liên thông mạnh (SCC) | Thuật toán Tarjan | DFS (num[], low[]) + Stack |
O(V + E) |
| Tổ tiên chung gần nhất (LCA) trên cây | Nâng nhị phân (Binary Lifting) | Bảng nhảy up[V][log V] |
O(V log V) / O(log V) |
Tầng 4: Quy hoạch động và Cấu trúc truy vấn đoạn
- Quy hoạch động (Dynamic Programming — DP): Chia bài toán lớn thành các bài toán con gối nhau, giải mỗi bài toán con một lần rồi lưu vào bảng
dp. Gồm 6 nhóm bài trọng tâm: DP 1D/2D cơ bản, Bài toán Cái túi (Knapsack 0/1 và Unbounded), Dãy con tăng dài nhất (LIS kết hợp tìm kiếm nhị phânO(n log n)), Quy hoạch động trên xâu (LCS, Edit Distance), Quy hoạch động Bitmask (n ≤ 20) và Quy hoạch động trên cây (Tree DP). - Cây Fenwick (BIT) và Cây phân đoạn (Segment Tree): Khi mảng vừa có
10⁵lệnh cập nhật giá trị vừa có10⁵lệnh truy vấn đoạn[L, R](tổng, min, max, GCD), mảng cộng dồn tĩnh không còn đáp ứng được. Fenwick Tree (BIT) xử lý tốt cập nhật điểm và tổng đoạn. Segment Tree linh hoạt hơn cho min, max, GCD và phép gộp phù hợp; cập nhật đoạn cần thiết kế lazy tương thích. Không phải mọi biến thể BIT đều hỗ trợ gán điểm và min/max đoạn tùy ý.
Bảng quyết định thực chiến: Đọc đề thấy dấu hiệu nào thì chọn CTDL nào?
| Dấu hiệu / Yêu cầu trong đề bài | Cấu trúc dữ liệu cần chọn | C++17 STL | Python 3 | Độ phức tạp |
|---|---|---|---|---|
| Cặp đóng–mở lồng nhau (dấu ngoặc), đảo ngược thứ tự, lịch sử Undo | Ngăn xếp (Stack) | std::stack<T> |
list (append, pop) |
O(1) |
| Tìm phần tử lớn hơn / nhỏ hơn gần nhất về bên trái hoặc phải | Ngăn xếp đơn điệu | std::stack<int> |
list lưu chỉ số |
O(n) toàn mảng |
| Xếp hàng, duyệt loang từng lớp, tìm số bước ít nhất (BFS) | Hàng đợi (Queue) | std::queue<T> |
collections.deque |
O(1) |
Thêm xóa ở cả 2 đầu, hoặc tìm min/max trên cửa sổ trượt dài K |
Hàng đợi hai đầu (Deque) | std::deque<T> |
collections.deque |
O(1) ở 2 đầu |
| Kiểm tra tồn tại, đếm tần suất hoặc tra cứu khóa không cần thứ tự | Bảng băm (Hash Table) | unordered_set, unordered_map |
set, dict |
O(1) trung bình |
| Liên tục thêm phần tử và liên tục lấy ra phần tử lớn nhất / nhỏ nhất | Hàng đợi ưu tiên (Heap) | std::priority_queue<T> |
heapq |
O(log n) |
Tập hợp động vừa thêm/xóa vừa cần tìm phần tử đầu tiên ≥ X |
Cây BST cân bằng | std::set, std::map, multiset |
bisect trên list / tự cài cây cân bằng |
Tìm vị trí O(log n); chèn/xóa list Python O(n) |
| Gộp các nhóm và kiểm tra nhanh 2 phần tử có cùng nhóm không | Disjoint Set Union (DSU) | Tự cài (parent, sz) |
Tự cài (parent, sz) |
O(α(n)) ≈ O(1) |
Vừa cập nhật giá trị, vừa truy vấn tổng / min / max đoạn [L, R] |
Fenwick Tree / Segment Tree | Tự cài trên vector |
Tự cài trên list |
O(log n) |
Lỗi hay gặp khi sử dụng Cấu trúc dữ liệu
- Dùng
list.pop(0)làm Hàng đợi trong Python: Gọilist.pop(0)phải dịch chuyểnn - 1phần tử còn lại sang trái, tốnO(n)mỗi lần lấy ra. Luôn dùngcollections.dequevớipopleft()để đạtO(1). - Gọi
top()hoặcpop()khi Stack / Queue / Heap đang rỗng trong C++: Sẽ gây lỗi truy cập vùng nhớ (Segmentation Fault). Luôn kiểm traif (!st.empty())trước. - Xóa một phần tử trong
std::multisetbằngms.erase(x): Lệnhms.erase(x)xóa tất cả bản sao củax; muốn xóa một bản sao, tìm iterator rồi chỉerase(it)khiit != ms.end().
Luyện ngay trên Big-O Coding
Bắt đầu rèn luyện Cấu trúc dữ liệu và giải thuật qua các bài tập thực hành dưới đây và theo dõi trọn bộ lộ trình luyện phỏng vấn & thi đấu trên Big-O Coding:
Câu hỏi thường gặp
Nên học tự cài đặt từng cấu trúc dữ liệu hay dùng luôn thư viện có sẵn?
Với Stack, Queue, Deque, Heap, Hash Table, hãy tự cài đặt một lần để hiểu gốc độ phức tạp, sau đó khi làm bài thì dùng thẳng thư viện chuẩn (std::stack, std::priority_queue, collections.deque, heapq). Riêng với DSU, Trie, Fenwick Tree và Segment Tree (không có sẵn trong thư viện chuẩn), bạn cần luyện viết thành thạo bản mẫu của riêng mình.
Học Cấu trúc dữ liệu và giải thuật để phỏng vấn khác gì với thi Học sinh giỏi / ICPC?
Phỏng vấn kỹ sư phần mềm (LeetCode / Big Tech) tập trung mạnh vào Tầng 1, Tầng 2, phần cơ bản của Tầng 3 (BFS, DFS, Topological Sort, Dijkstra) và Quy hoạch động 1D/2D. Trong khi đó, thi HSG Tin học và ICPC đòi hỏi sâu thêm về đồ thị nâng cao (MST, Khớp cầu, SCC, LCA) và cấu trúc truy vấn đoạn (BIT, Segment Tree, Lazy Propagation).
Cần bao lâu để nắm vững cả 4 tầng của lộ trình này?
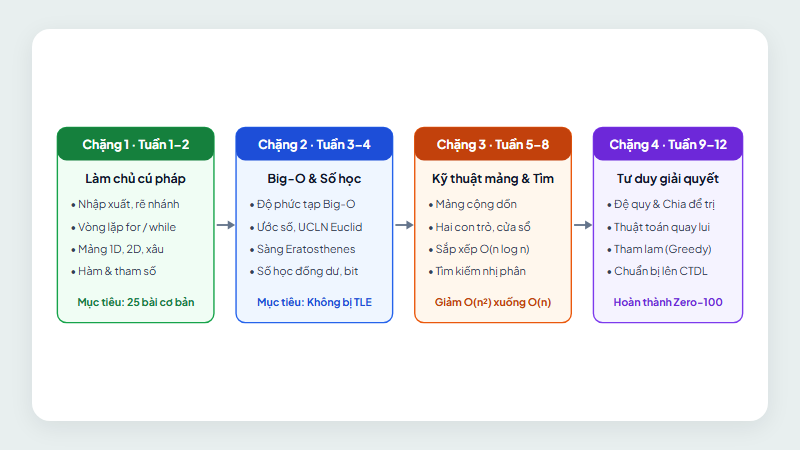
Có thể thử lịch tham khảo 3 tuần cho Tầng 1, 3 tuần cho Tầng 2, 4 tuần đồ thị và 4–6 tuần cho Tầng 4, rồi điều chỉnh sau mỗi nhóm bài. Đây là cách phân bổ tự học, không phải số liệu về thời gian thành thạo hay cam kết kết quả.
Đọc tiếp: từ Trie tới đường đi ngắn nhất
Sau khi nắm cây nhị phân và heap, hãy học Trie để tổ chức tiền tố và DSU để gộp nhóm. Hai cấu trúc này có mục tiêu khác nhau: Trie dựa trên từng ký tự hoặc bit; DSU dựa trên đại diện của các tập rời nhau.
Với đồ thị, bắt đầu bằng cách biểu diễn, rồi chạy tay BFS và DFS. Bài so sánh BFS và DFS chỉ rõ vì sao độ sâu của một nhánh khám phá không luôn là khoảng cách ngắn nhất.
Tiếp theo, dùng sắp xếp tô-pô cho quan hệ phụ thuộc. Khi có trọng số, chọn Dijkstra cho cạnh không âm, Bellman–Ford để xử lý cạnh âm từ một nguồn, hoặc Floyd–Warshall khi cần mọi cặp và số đỉnh đủ nhỏ. Trước mỗi bài, hãy ghi ra điều kiện đầu vào khiến thuật toán đó đúng; đây là bước quan trọng hơn việc nhớ tên hàm thư viện.
Đọc tiếp: cấu trúc đồ thị và quy hoạch động
Nếu cạnh chỉ mang trọng số 0 hoặc 1, xem 0–1 BFS để tận dụng deque. Bài cây khung nhỏ nhất giải mục tiêu nối toàn mạng, khác đường ngắn nhất từ một nguồn. Tiếp theo, khớp và cầu phân tích điểm tách trong đồ thị vô hướng, còn SCC gom nhóm đi tới hai chiều trong đồ thị có hướng. Trên cây có gốc, LCA trả lời tổ tiên chung và hỗ trợ tính khoảng cách nhiều truy vấn.
Với quy hoạch động, bắt đầu từ trạng thái, công thức và thứ tự tính. Sau đó luyện DP một chiều và cái túi để phân biệt cơ sở với chiều vòng lặp. Hai bài LIS và LCS làm rõ dãy con giữ thứ tự vị trí, cách tối ưu và những thông tin cần lưu nếu phải truy vết.
Đọc tiếp: DP nâng cao và truy vấn đoạn
Sau LCS, học Edit Distance để thấy cùng trạng thái tiền tố nhưng cơ sở và phép chuyển khác nhau. DP trên lưới dựa vào hướng di chuyển, DP trên đoạn thử quyết định chia khoảng, còn DP trên cây giữ điều kiện ở đỉnh nối với cha. Bitmask DP lưu một tập nhỏ, trong khi Digit DP gom tiền tố số theo cận và tính chất chữ số.
Với truy vấn đoạn, học Segment Tree từ phép gộp và trung hòa, rồi lazy propagation nếu cần cập nhật cả đoạn. Fenwick là lựa chọn gọn cho cộng điểm và tổng; Sparse Table tận dụng dữ liệu tĩnh để hỏi min bằng hai khối chồng lấn. Trước khi chọn, ghi rõ mảng có đổi không và phép toán có cho lấy hiệu tiền tố hoặc xét lặp phần giao không.
Đọc tiếp: xâu, chia căn và hình học
Khi đã vững truy vấn đoạn, chuyển sang ba cách xử lý mẫu xâu. Rolling Hash cho mã đoạn lấy nhanh nhưng phải quản lý va chạm; KMP dùng mảng tiền tố để lùi trạng thái chắc chắn; Z-function đo độ khớp với tiền tố tại mọi vị trí. Ba công cụ có thể cùng giải bài tìm mẫu, nhưng thông tin tiền xử lý và bảo đảm đúng của chúng khác nhau.
Với không gian trạng thái lớn, Meet in the Middle chia tập thành hai nửa. Khi có nhiều truy vấn đoạn ngoại tuyến, chia căn và thuật toán Mo sắp lại thứ tự xử lý để giảm di chuyển. Nén tọa độ hỗ trợ cả Mo, Fenwick, Segment Tree và hình học khi giá trị thưa nhưng thứ tự quan trọng.
Nhóm hình học bắt đầu bằng Sweep Line để biến mặt phẳng thành các sự kiện một chiều và Convex Hull để lấy biên ngoài bằng tích có hướng. Hai kỹ thuật tối ưu gọn hơn là Ternary Search cho hàm đơn đỉnh và Kadane cho đoạn con tổng lớn nhất. Trước khi dùng, hãy viết rõ điều kiện đơn đỉnh hoặc điều kiện đoạn liên tiếp; tên thuật toán không thay thế được điều kiện đúng.
Luyện phỏng vấn Google, Meta, Amazon theo Interview Patterns: 16 buổi online live, lớp 7–15 người, C++/Python/Java. Học thử buổi 1 miễn phí.