- DFS chọn nhánh để tiếp tục bằng stack hoặc ngăn xếp lời gọi hàm.
- Một lần DFS chỉ bao phủ vùng đi tới được từ điểm bắt đầu.
- Bản dùng stack đơn giản tìm thành phần đúng, nhưng không tự cung cấp mọi thời điểm vào/ra của DFS đệ quy.
Đi sâu rồi quay lại có nghĩa gì?
Tại một đỉnh, DFS chọn một hàng xóm chưa gặp để khám phá tiếp. Khi nhánh đó không còn đỉnh mới, nó quay lại để xử lý các lựa chọn còn chờ. Đệ quy biểu diễn sự chờ đó bằng các lời gọi chưa kết thúc; phiên bản lặp dùng một stack do chương trình tự quản lý.
Khác với BFS, DFS không xử lý theo lớp khoảng cách từ nguồn. Nó có thể tới một đỉnh bằng đường vòng dài trước khi thấy cạnh nối ngắn hơn. Vì vậy visited của DFS ghi nhận đã thăm, không phải chứng nhận khoảng cách đầu tiên là ít cạnh nhất.
Đếm thành phần liên thông vô hướng
Một thành phần liên thông vô hướng là một nhóm mà các đỉnh trong nhóm có đường nối tới nhau. Các đỉnh thuộc hai thành phần khác nhau không có đường nối. Nếu một đỉnh không có cạnh, nó vẫn tự tạo một thành phần gồm chính nó.
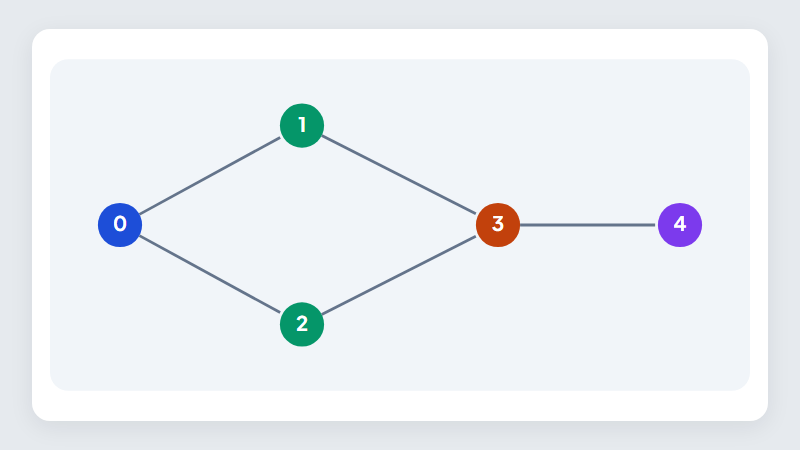
Ví dụ dùng sáu đỉnh 0..5 với cạnh 0–1, 0–2, 1–3, 2–3, 3–4. Một lần bắt đầu từ 0 sẽ tìm được năm đỉnh đầu. Đỉnh 5 chưa gặp nên cần bắt đầu lần thứ hai. Kết quả có hai thành phần, có thể gắn nhãn [0,0,0,0,0,1].
Cài lặp bằng stack để tránh đệ quy sâu
Khởi tạo id mọi đỉnh bằng -1. Duyệt các đỉnh theo nhãn tăng dần. Gặp một đỉnh chưa gắn nhóm, đặt nhãn nhóm cho nó và đưa vào stack. Chừng nào stack còn phần tử, lấy một đỉnh ra rồi thêm các hàng xóm chưa có nhãn. Các đỉnh được thêm đều nhận cùng nhãn nhóm hiện tại.
Khi stack rỗng, toàn bộ vùng nối với điểm bắt đầu đã được gắn nhãn, tăng số nhóm rồi tiếp tục vòng ngoài. Nếu chỉ viết một lần gọi từ đỉnh 0 rồi trả kết quả, bạn sẽ bỏ qua thành phần thứ hai hoặc các đỉnh cô lập.
#include <algorithm>
#include <functional>
#include <iostream>
#include <numeric>
#include <queue>
#include <tuple>
#include <utility>
#include <vector>
using namespace std;
const long long INF=1LL<<60;
vector<int> components(int n,const vector<pair<int,int>>&edges){
    vector<vector<int>>adj(n);for(auto[u,v]:edges){adj[u].push_back(v);adj[v].push_back(u);}
    vector<int>id(n,-1);int groups=0;
    for(int s=0;s<n;++s)if(id[s]<0){
        vector<int>st{s};id[s]=groups;
        while(!st.empty()){int u=st.back();st.pop_back();for(int v:adj[u])if(id[v]<0){id[v]=groups;st.push_back(v);}}
        ++groups;
    }
    vector<int>out{groups};out.insert(out.end(),id.begin(),id.end());return out;
}

int main(){int n=6,m;vector<pair<int,int>>edges={{0,1},{0,2},{1,3},{2,3},{3,4}};
if(cin>>n>>m){edges.resize(m);for(auto&[u,v]:edges)cin>>u>>v;}
for(auto x:components(n,edges)) { cout<<x<<' '; }
cout<<'\n';}
INF=1<<60
def solve(n,edges,s=0):
    adj=[[] for _ in range(n)]
    for u,v in edges:adj[u].append(v);adj[v].append(u)
    ids=[-1]*n;groups=0
    for root in range(n):
        if ids[root]>=0:continue
        st=[root];ids[root]=groups
        while st:
            u=st.pop()
            for v in adj[u]:
                if ids[v]<0:ids[v]=groups;st.append(v)
        groups+=1
    return [groups]+ids

if __name__=='__main__':
    import sys
    d=list(map(int,sys.stdin.read().split()))
    if d:
        n,m=d[:2];off=2;s=0 if off==2 else d[2]
        width=2;edges=[tuple(d[i:i+width]) for i in range(off,off+width*m,width)]
    else:
        n,s,edges=6,0,[(0, 1), (0, 2), (1, 3), (2, 3), (3, 4)]
    print(*solve(n,edges,s))
Ví dụ in 2 trước, sau đó 0 0 0 0 0 1; tệp hiện ghép các số trên một dòng để tiện đối chiếu. Nhập n, m rồi m cặp đỉnh cho dữ liệu riêng. Phiên bản này xử lý đồ thị vô hướng, nhãn từ 0 tới n−1 và cho phép n = 0 khi không có cạnh. Code chỉ cần nhãn nhóm, không tìm đường đi ngắn nhất.
Trong C++ dùng vector làm stack và lấy back; Python dùng list.pop ở cuối. Gán id trước khi đẩy giúp một đỉnh không bị thêm trùng từ nhiều hàng xóm. Vì bài chỉ cần thành phần, thứ tự lấy các hàng xóm không làm thay đổi tập đỉnh trong từng nhóm.
Chủ đề này nằm trong Lecture 09 - BFS & DFS (Duyệt đồ thị) của Khóa Blue 2.0. Xem đề cương
Bản stack này có giống hoàn toàn DFS đệ quy không?
Về khả năng đi tới và thành phần, bản lặp cho cùng phân hoạch với một phép duyệt đúng khác. Nhưng một stack chỉ lưu đỉnh, đánh dấu ngay khi đưa vào, không nhất thiết mô phỏng chính xác từng bước vào và ra của bản đệ quy. Thứ tự danh sách kề cũng có thể đảo thứ tự các nhánh được xử lý.
Nếu thuật toán cần thời điểm kết thúc, cần biết lúc nào cây con đã duyệt xong. Có thể dùng stack khung gồm đỉnh và chỉ số hàng xóm tiếp theo, hoặc thêm sự kiện vào/ra. Không lấy trực tiếp thứ tự pop của bản đếm thành phần rồi dùng làm hậu thứ tự trong thuật toán khác mà không chứng minh.
Đây là điểm cần nhớ khi học topo bằng DFS, cầu/khớp hoặc thành phần liên thông mạnh. Những thuật toán đó dùng thêm bất biến và trạng thái, không chỉ thay tên hàm DFS hiện có.
Đánh dấu chu trình: vô hướng và có hướng khác nhau
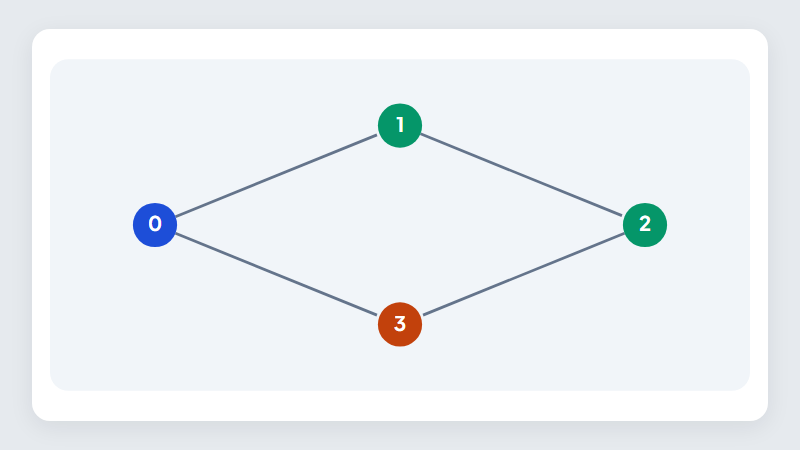
Trong đồ thị vô hướng đơn, khi duyệt cạnh u–v, cạnh quay về cha trực tiếp không tự chứng minh có chu trình. Bạn đã đi qua cạnh đó theo chiều ngược. Muốn phát hiện chu trình cần theo dõi cha hoặc ID cạnh theo đúng mô hình; với cạnh song song, chỉ so nhãn cha có thể bỏ sót thông tin.
Trong đồ thị có hướng, gặp một đỉnh đã thăm chưa đủ để kết luận có chu trình. Thường dùng ba màu: chưa thăm, đang nằm trên nhánh hoạt động, đã kết thúc. Cạnh tới đỉnh đang hoạt động mới là dấu hiệu vòng quay trong cách duyệt đó. Code đếm thành phần ở bài này không cài phép kiểm chu trình và không nên dùng nhãn id thay cho ba màu.
Thời gian và bộ nhớ
Với danh sách kề, vòng ngoài xét n đỉnh; mỗi đỉnh được đưa vào stack tối đa một lần và mỗi mục kề được đọc một lần. Đồ thị vô hướng có hai mục kề cho mỗi cạnh, vẫn cho tổng O(n+m). Bộ nhớ ngoài lưu đồ thị là O(n) cho nhãn và stack.
Bản đệ quy cần O(h) khung lời gọi theo độ sâu của nhánh, có thể lên tới O(n) trên đồ thị dạng đường. Với Python, giới hạn đệ quy thực tế có thể bị chạm trước khi hết bộ nhớ dữ liệu. Dùng stack lặp giải quyết riêng rủi ro độ sâu lời gọi; vẫn phải cấp đủ bộ nhớ cho các đỉnh và cạnh.
Kiểm kết quả bằng một cách khác
Khi kiểm tra bài toán đếm thành phần liên thông, bạn không cần khóa vào một thứ tự thăm DFS duy nhất. Hãy đối chiếu số thành phần và tập đỉnh của từng nhóm với kết quả chạy BFS từ đỉnh nhỏ nhất chưa thăm trên cùng đồ thị nhỏ.
Khi tự kiểm, hãy dùng đồ thị không cạnh: đáp án số nhóm phải bằng n. Đồ thị nối thành một đường phải có một nhóm. Thêm một cạnh bên trong cùng thành phần không làm số nhóm giảm; thêm cạnh nối hai thành phần phải giảm đúng một. Những tính chất này giúp tìm lỗi vòng ngoài hoặc lỗi khởi tạo visited.
Luyện ngay trên Big-O Coding
Hai bài đếm thành phần áp dụng trực tiếp khung lặp. Bài độ sâu cây luyện truyền thông tin từ cha xuống con; đầu vào cây khác đồ thị tổng quát vì giữa hai đỉnh chỉ có một đường đơn.
Câu hỏi thường gặp
DFS có dùng được cho đồ thị có hướng không?
Có để tìm các đỉnh đi tới được từ một nguồn theo đúng chiều cạnh. Nhưng đếm số lần bắt đầu DFS không cho số thành phần liên thông mạnh nói chung.
Có thể đổi stack thành queue trong bài đếm thành phần không?
Có. BFS cũng tìm đúng vùng liên thông. Với bài chỉ cần nhóm đỉnh, lựa chọn thứ tự duyệt không đổi phân hoạch.
Có cần tăng giới hạn đệ quy khi dùng bản code này không?
Không. Các bước duyệt dùng stack dữ liệu tự quản lý, không gọi hàm đệ quy theo độ dài đường đi.
Luyện phỏng vấn Google, Meta, Amazon theo Interview Patterns: 16 buổi online live, lớp 7–15 người, C++/Python/Java. Học thử buổi 1 miễn phí.