KMP nhớ phần nào của lần khớp trước?
Tìm mẫu bằng cách thử tại từng vị trí khiến văn bản bị đọc lại. Khi ababa đang khớp aba rồi lệch hoặc vừa hoàn thành một lần xuất hiện, một phần hậu tố đã đọc có thể đồng thời là tiền tố mẫu. Knuth–Morris–Pratt lưu chính độ dài đó trong mảng pi, nhờ vậy con trỏ văn bản không bao giờ lùi.
pi[i] là độ dài của tiền tố thực sự dài nhất (ngắn hơn chính đoạn) của pattern[0..i] mà cũng là hậu tố của đoạn này. Nó là độ dài, không phải vị trí bắt đầu và cũng không phải số ký tự phải dịch.
Dựng mảng pi mà không thử lại từ đầu
Tại vị trí i, đặt j=pi[i-1]. Nếu pattern[i] khác pattern[j], tiền tố dài j không dùng được; ứng viên kế tiếp là biên của chính tiền tố đó, tức pi[j-1]. Ta lặp phép lùi cho đến khi hai ký tự bằng nhau hoặc j=0. Nếu bằng, tăng j; cuối cùng gán pi[i]=j.
Điều đáng chú ý là chuỗi ứng viên không được đoán mò. Mọi hậu tố có khả năng trở thành tiền tố đều nằm trên chuỗi j, pi[j-1], pi[pi[j-1]-1], .... Mỗi lần lùi làm j nhỏ đi. Trong toàn bộ quá trình, số bước tăng và giảm bị chặn tuyến tính, nên dựng pi là O(m), không phải O(m²).
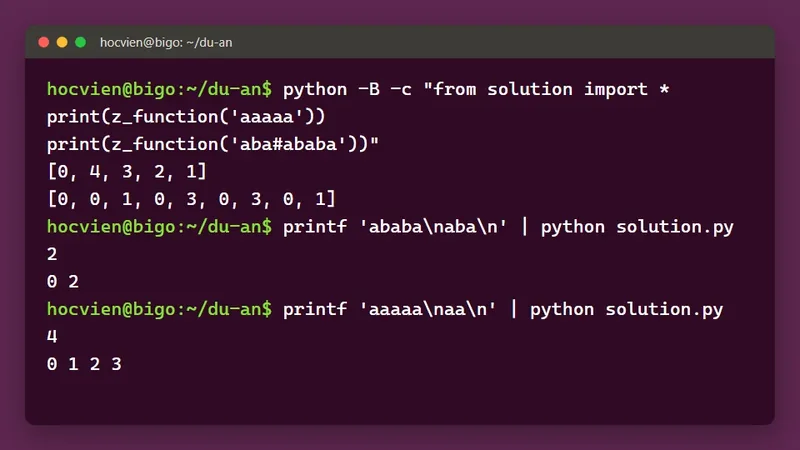
Với mẫu aba, mảng pi là 0,0,1: tại ký tự cuối, hậu tố a trùng tiền tố a. Với aaaa, pi là 0,1,2,3; mỗi đoạn dài hơn kế thừa đường biên trước. Thử hai ví dụ này giúp phân biệt “tiền tố riêng” với toàn bộ chuỗi—nếu cho phép toàn bộ chuỗi thì pi[i] luôn bằng i+1 và không còn ích lợi.
Quét văn bản bằng cùng một cơ chế lùi
Giữ j là số ký tự đầu mẫu đã khớp với hậu tố của phần văn bản vừa đọc. Khi ký tự mới không khớp, lùi j=pi[j-1]. Khi khớp, tăng j. Nếu j=m, ta tìm được vị trí bắt đầu i-m+1; sau khi ghi nhận, lùi về pi[m-1] để giữ khả năng xuất hiện chồng nhau.
Đoạn cuối rất quan trọng. Trong ababa, mẫu aba xuất hiện tại 0 và 2. Nếu đặt j=0 sau lần đầu, lần thứ hai có thể bị bỏ qua vì ký tự a cuối lần khớp trước cũng là ký tự đầu của lần sau. Trả về đường biên dài nhất giữ chính phần giao này.
Mẫu rỗng cần hợp đồng riêng. Code của bài quy ước xâu rỗng xuất hiện tại mọi ranh giới 0..n, tổng cộng n+1 vị trí. Nhánh này chạy trước khi truy cập pattern[j], tránh lỗi ngoài mảng. Văn bản và mẫu được đọc theo nguyên dòng nên dấu cách là ký tự bình thường.
Code và chi phí thật
#include <iostream>
#include <string>
#include <vector>
using namespace std;
vector<int> prefix(const string& s){vector<int> p(s.size());for(int i=1;i<(int)s.size();++i){int j=p[i-1];while(j&&s[i]!=s[j])j=p[j-1];if(s[i]==s[j])++j;p[i]=j;}return p;}
vector<int> find_all(const string& text,const string& pat){
    vector<int> ans;if(pat.empty()){for(int i=0;i<=(int)text.size();++i)ans.push_back(i);return ans;}
    auto p=prefix(pat);int j=0;for(int i=0;i<(int)text.size();++i){while(j&&text[i]!=pat[j])j=p[j-1];if(text[i]==pat[j])++j;if(j==(int)pat.size()){ans.push_back(i-j+1);j=p[j-1];}}return ans;
}
int main(){string t="ababa",p="aba";string x;if(getline(cin,x)){t=x;getline(cin,p);}auto a=find_all(t,p);cout<<a.size()<<'\n';for(int x:a)cout<<x<<' ';cout<<'\n';}
import sys
def prefix(s):
    p=[0]*len(s)
    for i in range(1,len(s)):
        j=p[i-1]
        while j and s[i]!=s[j]:j=p[j-1]
        if s[i]==s[j]:j+=1
        p[i]=j
    return p
def find_all(text,pat):
    if not pat:return list(range(len(text)+1))
    pi=prefix(pat);out=[];j=0
    for i,ch in enumerate(text):
        while j and ch!=pat[j]:j=pi[j-1]
        if ch==pat[j]:j+=1
        if j==len(pat):out.append(i-j+1);j=pi[j-1]
    return out
if __name__=='__main__':
    z=sys.stdin.read().splitlines();t,p=(z+[''])[:2] if z else ('ababa','aba');a=find_all(t,p);print(len(a));print(*a)
Dựng pi dùng O(m) thời gian và O(m) bộ nhớ; quét dùng O(n). KMP không cần ghép mẫu, ký tự phân cách và văn bản thành một xâu mới. Bộ nhớ phụ là O(m) cho mảng pi, chưa tính danh sách vị trí tìm được. Nếu chỉ cần biết có xuất hiện hay không, có thể trả ngay khi j=m.
Tính tuyến tính không có nghĩa mỗi ký tự chỉ tham gia đúng một phép so sánh. Một ký tự văn bản có thể khiến j lùi vài lần, nhưng mỗi lần lùi tiêu thụ tiến bộ đã tích lũy; phân tích khấu hao trên toàn vòng lặp mới cho O(n+m).
Chủ đề này nằm trong Lecture 14: Knuth–Morris–Pratt (KMP) của Khóa Orange. Xem đề cương
Đọc pi để giải bài khác
Giá trị pi[n-1] là độ dài biên dài nhất của cả xâu. Tiếp tục đi qua pi[j-1] liệt kê mọi độ dài vừa là tiền tố vừa là hậu tố. Muốn đếm số lần mỗi tiền tố xuất hiện, đếm các giá trị pi rồi cộng ngược theo quan hệ biên. Muốn tìm chu kỳ, đặt k=n-pi[n-1]; nếu n chia hết cho k, xâu được ghép từ một khối dài k.
KMP cũng có thể xử lý luồng ký tự: giữ j giữa hai khối dữ liệu và đưa từng ký tự mới qua cùng phép chuyển. Điều này khác việc chạy lại từ đầu trên mỗi khối, vì một lần xuất hiện có thể bắt đầu ở cuối khối trước và kết thúc ở đầu khối sau.
Các lỗi chỉ xuất hiện ở ca biên
Sau khi tìm được một lần xuất hiện, phải gán j=pi[j-1], không phải luôn về 0. Đây là điều kiện để giữ kết quả chồng nhau.
- Viết
whilelùi bằngpi[j]làm trạng thái không giảm và có thể lặp vô hạn. - Trộn pi 0-based với công thức 1-based làm sai ngay ở những vị trí đầu mẫu.
- Truy cập mẫu khi mẫu rỗng gây lỗi dù mọi ca thông thường đều qua.
- Hiểu
pi[i]là số lần xuất hiện khiến các bài đếm tiền tố xây công thức sai.
Tự kiểm tra hàm KMP trên dữ liệu nhỏ
Khi mới cài đặt KMP, cách nhanh nhất để phát hiện lỗi lùi chỉ số j là viết thêm một hàm tìm mẫu đơn giản thử từng vị trí bắt đầu từ 0 đến n - m và so sánh trực tiếp đoạn con dài m với mẫu. Hãy chạy cả hai hàm trên những ca biên dễ sai nhất: các lần xuất hiện chồng nhau (như tìm aba trong ababa hoặc aa trong aaaaa), mẫu không xuất hiện, mẫu dài hơn văn bản, văn bản rỗng và mẫu rỗng. Danh sách vị trí trả về từ hàm KMP phải trùng khớp cả về số lượng lẫn thứ tự chỉ số.
Để rà kỹ hơn các nhánh lùi j = pi[j - 1], bạn có thể sinh toàn bộ các cặp xâu nhị phân ngắn độ dài từ 1 đến 8 trên bảng chữ cái {a, b} rồi đối chiếu kết quả giữa KMP và hàm duyệt trực tiếp. Tập dữ liệu nhỏ này bao phủ đầy đủ các cấu trúc biên lồng nhau như abab, aabaab hay aaaa, giúp lộ ngay lỗi viết nhầm pi[j] thay vì pi[j - 1] mà vài ví dụ ngẫu nhiên thường bỏ sót.
Chạy tay pi trên mẫu ababaca
Hãy lập bảng gồm chỉ số, ký tự, giá trị j trước khi so và pi[i] sau khi xử lý. Tại ký tự c, trạng thái đang khớp phải lùi qua nhiều biên trước khi về 0. Chính dòng này cho thấy vòng while cần thiết; chỉ lùi một lần sẽ cho mảng pi sai.
| Mẫu kiểm | Điều cần quan sát |
|---|---|
aaaaa |
pi tăng lần lượt 0,1,2,3,4 |
ababa tìm aba |
nhận cả vị trí 0 và 2 |
văn bản rỗng, mẫu a |
không có vị trí |
| mẫu rỗng | mọi ranh giới từ 0 tới n |
Sau khi tự viết KMP, so danh sách vị trí với cách thử mẫu tại từng vị trí trên mọi xâu ngắn tạo từ a và b. Đừng chỉ so số lượng: thứ tự và từng chỉ số cũng phải khớp. Một ca sai nhỏ dễ lần theo j hơn dữ liệu dài hàng nghìn ký tự.
Từ mảng pi đến máy trạng thái
Có thể xem j là trạng thái của một máy tự động: trạng thái j nghĩa là đã khớp j ký tự đầu mẫu. Mỗi ký tự mới đưa máy sang trạng thái khác bằng các đường lùi pi. Góc nhìn này giải thích vì sao KMP xử lý được luồng dữ liệu mà không giữ toàn bộ văn bản.
Khi bảng chữ cái nhỏ và có rất nhiều văn bản, ta có thể tiền xử lý chuyển trạng thái cho mọi cặp (j,ký_tự). Lúc đó mỗi ký tự được xử lý bằng một lần tra bảng, đổi lại bộ nhớ O(m·alphabet). Với Unicode hoặc bảng chữ cái lớn, bản while theo pi thường gọn hơn.
KMP cũng hữu ích khi ghép xâu. Muốn nối thêm ít ký tự nhất để một xâu kết thúc bằng mẫu, hãy chạy trạng thái qua phần đã có rồi xem bao nhiêu ký tự đầu mẫu còn thiếu. Tuy nhiên cần xác định rõ mục tiêu là tiền tố-hậu tố hay xâu con bất kỳ; mảng pi chỉ mô tả các biên của tiền tố đang xét.
Một kiểm tra thiết kế nhỏ
Trước khi cài đặt, hãy tự trả lời ba câu: trạng thái j đang biểu diễn điều gì, sau khi tìm thấy một lần khớp thì j trở về đâu, và ký tự hiện tại có được đọc lại hay không. Nếu ba câu trả lời nhất quán với mảng pi, vòng lặp thường đúng cả khi mẫu tự chồng lấn như aaaa hoặc abab. Đây cũng là cách rà lỗi nhanh hơn việc chỉ thử vài ví dụ ngẫu nhiên.
Luyện ngay trên Big-O Coding
Ba bài dưới đây luyện mảng pi và KMP: tìm mẫu, liệt kê độ dài vừa là tiền tố vừa là hậu tố, và đếm số lần xuất hiện của từng tiền tố.
Câu hỏi thường gặp
KMP khác Z-function ở đâu?
KMP lưu đường biên của từng tiền tố; Z lưu độ khớp giữa tiền tố toàn xâu và hậu tố tại từng vị trí. Cả hai tìm mẫu tuyến tính nhưng trạng thái phục vụ biến thể khác nhau.
KMP có nhanh hơn Rolling Hash không?
Không nên so bằng một con số chung. KMP cho kết quả chắc chắn O(n+m) cho một mẫu; hash hữu ích khi có rất nhiều truy vấn xâu con sau tiền xử lý.
Có cần thuộc công thức lùi?
Nên nhớ ý nghĩa: thử biên dài nhất còn hợp lệ của phần đã khớp. Từ ý nghĩa đó, pi[j-1] được suy ra thay vì học vẹt.
Khóa Orange: làm chủ thuật toán nâng cao như Graph, DP tối ưu, Segment Tree, HLD để giải bài Hard. 16 buổi online, C++/Java/Python, học thử buổi 1 miễn phí.