Khi 2^40 vẫn có thể xử lý
Một mảng 40 phần tử có hơn một nghìn tỷ tập con, nên quay lui toàn bộ không khả thi. Tuy nhiên mỗi nửa 20 phần tử chỉ có khoảng một triệu tập con. Meet in the Middle liệt kê hai nửa độc lập rồi ghép kết quả, đổi số mũ từ n thành gần n/2.
Mỗi tập con của toàn mảng phân rã duy nhất thành một tập con bên trái và một tập con bên phải. Tính duy nhất này là lý do phép đếm cặp không bỏ sót hay đếm trùng.
Tạo danh sách tổng của một nửa
Bắt đầu danh sách sums=[0] để biểu diễn tập rỗng. Với mỗi phần tử x, lấy ảnh chụp kích thước hiện tại rồi nối thêm old_sum+x cho từng tổng cũ. Sau k phần tử, danh sách có đúng 2^k mục; các phần tử bằng nhau vẫn tạo các mục riêng vì bài đếm cách chọn theo vị trí.
Chia tại m=n//2, tạo left từ [0,m) và right từ [m,n). Sắp right. Với từng x trong left, mọi cặp hợp lệ cần y=target-x. Hai phép lower_bound và upper_bound cho số lần y xuất hiện. Cộng hiệu hai vị trí vào biến 64 bit.
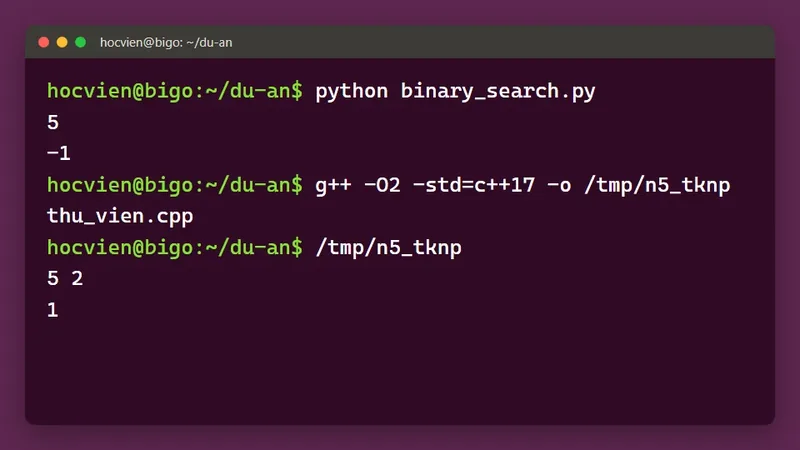
Mảng 2,4,5,2, mục tiêu 7 có hai đáp án. Một cách chọn số 2 đầu với 5; cách kia chọn 5 với số 2 cuối. Nếu biến danh sách phải thành set, hai tổng bằng nhau bị gộp và đáp án mất thông tin vị trí: ví dụ [0,0] với target 0 có 4 cách, còn dùng set chỉ đếm được 2. Đây là lý do code giữ vector đã sắp thay vì tập hợp.
Tập rỗng cũng quan trọng. Khi target bằng 0, cặp hai tập rỗng phải được tính; nếu có số âm hoặc số 0, còn nhiều cách khác. Khởi tạo bằng [0] xử lý đồng nhất, không cần nhánh đặc biệt.
Phân tích giới hạn trước khi viết
Hai danh sách có kích thước 2^floor(n/2) và 2^ceil(n/2). Sinh danh sách là O(2^(n/2)); sắp nửa phải và tìm nhị phân cho mọi tổng trái đưa thời gian về O(2^(n/2) log 2^(n/2)). Bộ nhớ O(2^(n/2)). Với n=40, đây vẫn là khối dữ liệu đáng kể nên cần ước lượng byte, không chỉ đếm phần tử.
Tổng phải dùng long long/số nguyên Python nếu mỗi a[i] tới 10^9. Số cách tối đa 2^40 vẫn nằm trong số nguyên 64 bit có dấu. Nếu n vượt xa 40 (chẳng hạn từ 50 trở lên), MITM cũng có thể quá nặng; kỹ thuật này chỉ hạ số mũ chứ không xóa được tăng trưởng hàm mũ.
#include <algorithm>
#include <iostream>
#include <vector>
using namespace std;
vector<long long> sums(const vector<long long>& a,int l,int r){vector<long long>s(1,0);for(int i=l;i<r;++i){int n=s.size();for(int j=0;j<n;++j)s.push_back(s[j]+a[i]);}return s;}
long long count_target(const vector<long long>& a,long long target){int m=a.size()/2;auto l=sums(a,0,m),r=sums(a,m,a.size());sort(r.begin(),r.end());long long ans=0;for(long long x:l){auto q=equal_range(r.begin(),r.end(),target-x);ans+=q.second-q.first;}return ans;}
int main(){int n=4;long long t=7;vector<long long>a={2,4,5,2};if(cin>>n>>t){a.resize(n);for(auto&x:a)cin>>x;}cout<<count_target(a,t)<<'\n';}
import bisect,sys
def half(a):
    s=[0]
    for x in a:s += [v+x for v in s[:]]
    return s
def count_target(a,target):
    m=len(a)//2;l=half(a[:m]);r=sorted(half(a[m:]));return sum(bisect.bisect_right(r,target-x)-bisect.bisect_left(r,target-x) for x in l)
if __name__=='__main__':
    z=list(map(int,sys.stdin.buffer.read().split()));n,t,a=(z[0],z[1],z[2:]) if z else (4,7,[2,4,5,2]);print(count_target(a,t))
Tại sao không dùng quy hoạch động tổng?
DP theo tổng tốt khi giá trị không âm và tổng S vừa phải, với độ phức tạp gần O(nS). Meet in the Middle không phụ thuộc độ lớn target và chấp nhận số âm, nhưng phụ thuộc mạnh vào n. Vì vậy cần đọc cả hai trục giới hạn. n=40, giá trị tới 10^9 là tín hiệu MITM; n=200, tổng chỉ 10.000 thường nghiêng về DP.
Backtracking có cắt tỉa cũng có thể nhanh trên dữ liệu thuận lợi, nhưng khó bảo đảm khi có số âm hoặc thứ tự xấu. MITM xây giới hạn rõ ràng, phù hợp khi đề cần độ phức tạp dự đoán được.
Các biến thể ghép hai danh sách
Muốn đếm tổng trong [L,R], với mỗi x đếm y trong [L-x,R-x] bằng hai biên. Muốn tối đa hóa tổng không vượt S, sắp phải và lấy phần tử lớn nhất <=S-x. Muốn truy vết, lưu cặp (sum,mask) thay vì chỉ tổng; sau khi tìm cặp, ghép hai mask theo offset.
Nếu mục tiêu là tối thiểu chênh lệch với S, có thể dùng hai con trỏ trên hai danh sách đã sắp hoặc tìm lân cận S-x. Bài “bốn tổng” cũng dùng tư tưởng gặp giữa: tạo tổng từng cặp rồi ghép hai danh sách.
Không được gọi mọi cách chia đôi là MITM. Điều kiện quan trọng là trạng thái toàn cục ghép được từ hai phần gần độc lập bằng một khóa như tổng, XOR hoặc chi phí.
Những lỗi làm sai số cách
Gộp tổng trùng là lỗi phổ biến nhất trong bài đếm. Lỗi thứ hai là quên tập rỗng. Lỗi thứ ba là chia 30–10 thay vì 20–20; nửa lớn tạo 2^30 trạng thái, lớn gấp khoảng một nghìn lần 2^20. Lỗi cuối là dùng int cho tổng rồi sắp các giá trị đã tràn, khiến tìm nhị phân trả kết quả có vẻ hợp lệ nhưng sai.
Tự kiểm tra số cách ghép trên mảng nhỏ
Với n <= 18, bạn có thể viết một hàm duyệt toàn bộ mask từ 0 đến 2^n - 1, cộng các phần tử có bit bật rồi đếm số tập con đạt đúng target. Hàm ngắn này hoàn toàn độc lập với bước chia đôi mảng, sắp xếp và tìm kiếm nhị phân, nên rất thích hợp để đối chiếu kết quả của cài đặt Meet in the Middle. Đừng quên thử mảng rỗng với target = 0, mảng một phần tử và mảng có cả số âm, số 0 lẫn phần tử trùng lặp.
Khi sinh dữ liệu thử nghiệm, bạn nên ưu tiên nhiều mảng ngắn (n từ 6 đến 14) có các giá trị lặp lại và target xoay quanh 0 thay vì chỉ thử một mảng lớn ngẫu nhiên. Các mảng có nhiều phần tử trùng sẽ sinh ra hàng loạt tổng bằng nhau ở nửa phải, giúp phát hiện ngay lỗi vô tình loại trùng bằng set hoặc dùng binary_search thay vì cặp lower_bound – upper_bound.
Tự ước lượng bộ nhớ trước khi sinh tổng
Nửa 20 phần tử tạo 2^20 = 1.048.576 tổng. Nếu mỗi tổng là số nguyên 64 bit, riêng dữ liệu thô của một vector đã đúng 8 MiB (2^20 × 8 byte), chưa kể dung lượng cấp phát. Nửa 23 phần tử lớn gấp tám lần nửa 20; vì thế cách chia cân bằng ảnh hưởng rất mạnh.
| Ca nhỏ | Target | Số cách đúng |
|---|---|---|
[] |
0 | 1, là tập rỗng |
[0,0] |
0 | 4 theo vị trí |
[2,4,5,2] |
7 | 2 |
[-2,-1,1,2] |
0 | 4, gồm cả tập rỗng |
Người học nên duyệt mọi mask khi n không quá 18 rồi so số cách. Hãy ưu tiên mảng có số trùng, số 0 và số âm; chúng phát hiện việc dùng set sai nhanh hơn mảng toàn số dương khác nhau.
Chọn khóa ghép phù hợp
Tổng chỉ là khóa ghép phổ biến nhất. Với bài XOR, hai nửa tạo danh sách XOR và ghép theo giá trị cần bù. Với bài đường đi trên lưới nhỏ, có thể đi từ hai đầu tới đường chéo giữa rồi ghép các trạng thái tại cùng ô. Cấu trúc chung là mỗi lời giải toàn cục tách được thành hai nửa và điều kiện nối được kiểm nhanh.
Nếu chỉ cần tồn tại, danh sách phải có thể đưa vào tập hoặc tìm nhị phân. Nếu cần đếm, phải giữ tần suất của mỗi khóa. Nếu cần dựng lời giải, lưu thêm mask hoặc thông tin cha. Ba mục tiêu này dùng cùng ý tưởng nhưng khác dữ liệu cần bảo toàn; tối ưu quá sớm bằng cách xóa trùng có thể làm mất số cách hoặc đường truy vết.
Một biến thể tiết kiệm bộ nhớ là sinh tổng một nửa theo thứ tự Gray để mỗi bước chỉ đổi một phần tử. Cách đó giảm chi phí tính lại tổng nhưng không tự loại nhu cầu lưu danh sách khi phải sắp và tìm. Hãy tối ưu phần gây giới hạn thật: thời gian sinh, thời gian sắp hay bộ nhớ lưu trạng thái.
Ước lượng trước khi chọn
Với n=40, mỗi nửa có khoảng một triệu tập con, thường còn trong khả năng lưu và sắp xếp. Với n=50, mỗi nửa đã vượt ba mươi triệu trạng thái; lúc đó Meet-in-the-Middle cơ bản có thể thiếu bộ nhớ. Việc nhẩm 2^(n/2) trước khi viết code giúp biết cần cắt tỉa, chia nhiều phần hay tìm cấu trúc khác.
Luyện ngay trên Big-O Coding
Bài dưới đây yêu cầu đúng kỹ thuật chia đôi tập: kiểm tra có tập con nào đạt tổng S hay không.
Nếu n lớn nhưng tổng nhỏ, cùng bài tổng tập con sẽ hợp với quy hoạch động cái túi hơn; còn n khoảng 40 và giá trị tới 10^9 là lúc cần chia đôi tập.
Câu hỏi thường gặp
Có thể giảm bộ nhớ không?
Có các cách sinh và tìm theo khối, nhưng phức tạp hơn. Bản cơ bản lưu hai danh sách để giữ triển khai rõ và kiểm được.
Tại sao phải sắp chỉ một nửa?
Nửa phải cần tìm biên; nửa trái chỉ được duyệt. Sắp cả hai không sai nhưng không cần cho phép đếm này.
MITM có phải thuật toán đa thức không?
Không. Nó vẫn là hàm mũ, chỉ giảm số mũ từ n xuống n/2 nên mở rộng giới hạn thực dụng từ khoảng 20 lên khoảng 40.
Khóa Orange: làm chủ thuật toán nâng cao như Graph, DP tối ưu, Segment Tree, HLD để giải bài Hard. 16 buổi online, C++/Java/Python, học thử buổi 1 miễn phí.