- Năm nhóm câu hỏi hay gặp: nền tảng, đánh giá mô hình, dữ liệu, học sâu, đưa vào sản phẩm. Thêm phần hỏi về dự án và câu hỏi hành vi.
- Câu hỏi kinh điển nhất là về chỉ số: vì sao độ chính xác 95% có thể là mô hình vô dụng, và khi nào ưu tiên precision hay recall.
- Rò rỉ dữ liệu là lỗi người phỏng vấn rất thích hỏi. Tài liệu scikit-learn ghi quy tắc cốt lõi: không bao giờ gọi
fittrên dữ liệu kiểm tra, và chia tập trước mọi bước tiền xử lý. - Trả lời bằng ví dụ từ dự án của chính bạn; người phỏng vấn sẽ hỏi sâu vào đó.
Định nghĩa và khuyến nghị trong bài lấy từ Google Machine Learning Crash Course và tài liệu scikit-learn, đọc ngày 11/11/2026. Quy trình phỏng vấn mỗi công ty một khác; khi ứng tuyển, đọc trang tuyển dụng của chính công ty đó để biết các vòng.
Người phỏng vấn muốn thấy gì
Phần lớn câu hỏi học máy không nhằm kiểm tra bạn thuộc định nghĩa, mà kiểm tra ba điều: bạn hiểu vì sao một kỹ thuật tồn tại, bạn biết khi nào nó sai, và bạn đã thật sự làm. Một câu trả lời tốt thường có ba phần: định nghĩa ngắn bằng lời của mình, một ví dụ cụ thể (tốt nhất là từ dự án bạn đã làm), và một điều kiện hay giới hạn. Ví dụ, khi được hỏi về quá khớp, đừng dừng ở "mô hình học thuộc dữ liệu huấn luyện"; kể tiếp bạn đã thấy nó ở dự án nào, nhận ra bằng cách nào, và đã sửa ra sao.
Nhóm 1: nền tảng
Quá khớp là gì, phát hiện và xử lý thế nào?
Quá khớp là khi mô hình làm tốt trên tập huấn luyện nhưng kém trên dữ liệu mới, vì nó học cả nhiễu. Dấu hiệu là khoảng cách lớn giữa điểm huấn luyện và điểm kiểm định. Cách xử lý: thêm dữ liệu, giảm độ phức tạp mô hình, chính quy hóa, dừng sớm, tăng cường dữ liệu với ảnh. Nhắc thêm dưới khớp (mô hình quá đơn giản, kém cả trên tập huấn luyện) để cho thấy bạn hiểu cả hai phía.
Đánh đổi giữa bias và variance là gì?
Bias cao: mô hình quá đơn giản, sai có hệ thống. Variance cao: mô hình quá nhạy với dữ liệu huấn luyện, đổi dữ liệu là đổi kết quả. Tăng độ phức tạp thường giảm bias nhưng tăng variance; mục tiêu là điểm cân bằng cho sai số trên dữ liệu mới nhỏ nhất. Liên hệ với câu trên: quá khớp ứng với variance cao.
Học có giám sát và không giám sát khác nhau thế nào?
Có giám sát học từ dữ liệu có nhãn để dự đoán nhãn (phân loại, hồi quy). Không giám sát tìm cấu trúc trong dữ liệu không nhãn (phân cụm, giảm chiều). Cho ví dụ của mỗi loại từ một bài toán bạn biết.
Nhóm 2: đánh giá mô hình
Vì sao độ chính xác có thể đánh lừa?
Theo Google Machine Learning Crash Course, độ chính xác là tỉ lệ dự đoán đúng trên tất cả dự đoán, cả dương lẫn âm. Với dữ liệu lệch lớp, một mô hình luôn đoán lớp nhiều nhất vẫn đạt độ chính xác cao mà vô dụng. Đoạn code dưới đây minh họa: 100 giao dịch có 5 giao dịch gian lận, mô hình luôn đoán "không gian lận" đạt độ chính xác 95% nhưng recall bằng 0, tức không bắt được giao dịch gian lận nào.
Precision và recall khác nhau thế nào, chọn cái nào?
Recall là tỉ lệ ca dương thật được mô hình bắt đúng; precision là tỉ lệ ca mô hình báo dương mà đúng là dương (theo định nghĩa của Google MLCC). Chọn theo cái giá của lỗi: phát hiện gian lận hay sàng lọc bệnh thì bỏ sót rất đắt, ưu tiên recall; lọc thư rác thì báo nhầm thư quan trọng là thư rác rất đắt, ưu tiên precision. F1 là trung bình điều hòa của hai chỉ số, dùng khi cần một con số cân bằng.
Đổi ngưỡng quyết định ảnh hưởng thế nào?
Mô hình thường cho ra điểm xác suất; ngưỡng biến điểm thành quyết định. Hạ ngưỡng thì báo dương nhiều hơn: recall tăng, precision thường giảm. Trong ví dụ code, ngưỡng 0,75 cho precision 100% nhưng recall 40%; ngưỡng 0,5 cho 60% và 60%; ngưỡng 0,35 cho precision khoảng 57% và recall 80%. Trả lời tốt là nói ngưỡng do bài toán quyết định, không phải luôn là 0,5.
"""Trả lời bằng code ba câu hỏi phỏng vấn học máy hay gặp, chỉ dùng thư viện có sẵn:

1. Vì sao độ chính xác (accuracy) đánh lừa khi dữ liệu lệch lớp?
2. Precision và recall đổi thế nào khi đổi ngưỡng quyết định?
3. Rò rỉ dữ liệu (data leakage) khi chuẩn hóa trên toàn bộ dữ liệu trước khi chia tập.
Dữ liệu là số giả định để minh họa.
"""


def ma_tran_nham_lan(that, doan):
    tp = sum(1 for a, b in zip(that, doan) if a == 1 and b == 1)
    fp = sum(1 for a, b in zip(that, doan) if a == 0 and b == 1)
    fn = sum(1 for a, b in zip(that, doan) if a == 1 and b == 0)
    tn = sum(1 for a, b in zip(that, doan) if a == 0 and b == 0)
    return tp, fp, fn, tn


def chi_so(that, doan):
    tp, fp, fn, tn = ma_tran_nham_lan(that, doan)
    acc = (tp + tn) / len(that)
    prec = tp / (tp + fp) if tp + fp else 0.0
    rec = tp / (tp + fn) if tp + fn else 0.0
    f1 = 2 * prec * rec / (prec + rec) if prec + rec else 0.0
    return round(acc, 3), round(prec, 3), round(rec, 3), round(f1, 3)


def chuan_hoa(gia_tri, tb, sd):
    return [(x - tb) / sd for x in gia_tri]


def tb_sd(gia_tri):
    tb = sum(gia_tri) / len(gia_tri)
    return tb, (sum((x - tb) ** 2 for x in gia_tri) / len(gia_tri)) ** 0.5


def chay_thu():
    dong = []
    # 1. 100 giao dịch, 5 gian lận. Mô hình "lười" luôn đoán không gian lận.
    that = [1] * 5 + [0] * 95
    luoi = [0] * 100
    dong.append("1. Mô hình luôn đoán 0: accuracy, precision, recall, F1 = %s" % (chi_so(that, luoi),))

    # 2. Điểm rủi ro do một mô hình cho ra; đổi ngưỡng để thấy precision và recall đánh đổi nhau.
    diem = [0.9, 0.8, 0.65, 0.4, 0.3] + [0.7, 0.6, 0.45] + [0.1] * 92
    for nguong in (0.75, 0.5, 0.35):
        doan = [1 if d >= nguong else 0 for d in diem]
        dong.append(f"2. Ngưỡng {nguong}: accuracy, precision, recall, F1 = {chi_so(that, doan)}")

    # 3. Rò rỉ: tập kiểm tra có giá trị lớn bất thường; chuẩn hóa sai dùng cả tập kiểm tra để tính trung bình.
    hl = [10.0, 12.0, 11.0, 13.0, 9.0]
    kt = [30.0, 32.0]
    tb_dung, sd_dung = tb_sd(hl)                 # đúng: chỉ học từ tập huấn luyện
    tb_sai, sd_sai = tb_sd(hl + kt)              # sai: nhìn trộm tập kiểm tra
    dong.append(f"3. Chuẩn hóa tập kiểm tra, cách đúng: {[round(x, 1) for x in chuan_hoa(kt, tb_dung, sd_dung)]}")
    dong.append(f"   cách rò rỉ: {[round(x, 1) for x in chuan_hoa(kt, tb_sai, sd_sai)]} (bất thường bị che bớt)")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Kiểm định chéo (cross-validation) dùng để làm gì?
Để ước lượng hiệu quả trên dữ liệu mới ổn định hơn một lần chia, nhất là khi dữ liệu ít. Lưu ý: với dữ liệu theo thời gian, không được trộn ngẫu nhiên; phải dùng phần cũ để huấn luyện, phần mới để kiểm định.
Nhóm 3: dữ liệu
Rò rỉ dữ liệu là gì?
Là khi thông tin của tập kiểm tra (hoặc thông tin không có lúc dự đoán thật) lọt vào quá trình huấn luyện, làm điểm đánh giá đẹp giả. Tài liệu Common pitfalls của scikit-learn ghi quy tắc: không bao giờ gọi fit trên dữ liệu kiểm tra; luôn chia tập huấn luyện và kiểm tra trước, nhất là trước mọi bước tiền xử lý; các phép biến đổi như chuẩn hóa chỉ được học từ tập huấn luyện; và dùng pipeline để mỗi bước chạy đúng trên phần dữ liệu của nó. Trong ví dụ code, tập kiểm tra có giá trị lớn bất thường; chuẩn hóa đúng (chỉ dùng trung bình của tập huấn luyện) cho thấy chúng cách xa tới khoảng 13 đến 15 độ lệch chuẩn, còn chuẩn hóa sai (dùng cả tập kiểm tra) che bớt sự bất thường xuống còn khoảng 1,5.
Xử lý dữ liệu lệch lớp thế nào?
Trước hết chọn chỉ số phù hợp (precision, recall, F1, đường precision-recall) thay vì độ chính xác. Sau đó có thể đổi trọng số lớp, lấy mẫu lại, hoặc chỉnh ngưỡng. Khi chia tập, giữ tỉ lệ các lớp ở mỗi phần.
Xử lý ô thiếu thế nào?
Trước hết hỏi vì sao thiếu: ngẫu nhiên hay có lý do. Rồi chọn: bỏ dòng, điền giá trị (trung bình, trung vị, giá trị gần nhất với chuỗi thời gian), hoặc thêm cột đánh dấu "bị thiếu". Và nhớ học cách điền từ tập huấn luyện, không từ toàn bộ dữ liệu.
Nhóm 4: học sâu
Lan truyền ngược hoạt động thế nào?
Tính đạo hàm của hàm mất mát theo từng tham số bằng quy tắc chuỗi, đi ngược từ đầu ra về đầu vào, rồi cập nhật tham số theo hướng giảm mất mát. Nếu bạn từng tự viết một bộ tính đạo hàm nhỏ, hãy kể; đó là câu trả lời thuyết phục nhất.
Vì sao dùng ReLU thay vì sigmoid ở tầng ẩn?
Sigmoid bão hòa ở hai đầu làm gradient rất nhỏ, mạng sâu khó học; ReLU tính rẻ và không bão hòa phía dương. Nêu thêm giới hạn của ReLU (nơ-ron "chết" khi luôn ra 0) để cho thấy bạn hiểu cả hai mặt.
Attention trong Transformer làm gì?
Mỗi vị trí tính điểm với mọi vị trí khác, chuẩn hóa thành trọng số, rồi lấy trung bình có trọng số các giá trị; nhờ đó mô hình nhìn được ngữ cảnh xa mà không cần xử lý tuần tự. Nhắc thêm cần mã hóa vị trí vì attention tự nó không biết thứ tự.
Nhóm 5: đưa vào sản phẩm
Bạn sẽ bắt đầu một dự án học máy thế nào?
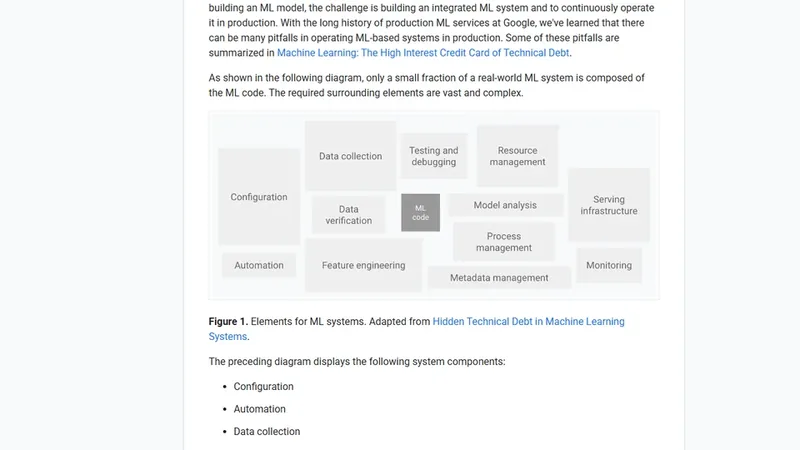
Một câu trả lời được đánh giá cao đi theo tinh thần Rules of Machine Learning của Google: xác định chỉ số đo thành công trước, làm một mốc so sánh đơn giản (có khi chỉ là một quy tắc), giữ mô hình đầu tiên đơn giản và làm đúng hạ tầng, rồi mới cải tiến mô hình. Xem chi tiết các bước trong lộ trình ML Engineer.
Mô hình chạy tốt lúc thử nhưng kém khi đưa vào dùng, vì sao?
Thường do dữ liệu thật khác dữ liệu huấn luyện (lệch phân bố), xử lý đặc trưng lúc huấn luyện và lúc phục vụ không giống nhau, hoặc rò rỉ dữ liệu khiến điểm lúc thử bị đẹp giả. Cách phòng: dùng chung code tiền xử lý, theo dõi phân bố đầu vào, và đánh giá lại định kỳ.
Câu hỏi về dự án và câu hỏi hành vi
Gần như chắc chắn bạn sẽ được hỏi sâu về một dự án trong CV: bài toán là gì, dữ liệu từ đâu, chọn chỉ số nào và vì sao, mốc so sánh là gì, mô hình sai ở đâu, nếu làm lại sẽ đổi gì. Chuẩn bị trả lời được cả năm câu đó cho từng dự án. Nếu dự án có dùng AI hỗ trợ viết code, nói thẳng phần nào; bạn phải giải thích được mọi dòng. Cách chuẩn bị CV và luyện trả lời với AI mà không bịa kinh nghiệm có trong bài dùng AI viết CV.
Câu hỏi hành vi (một lần bất đồng trong nhóm, một lần thất bại) cũng thường có. Trả lời theo cấu trúc tình huống, việc bạn làm, kết quả, điều rút ra; dùng chuyện có thật.
- Học thuộc định nghĩa mà không có ví dụ từ dự án của mình.
- Khoe độ chính xác cao mà không nói dữ liệu có lệch lớp không.
- Chuẩn hóa hay chọn đặc trưng trên toàn bộ dữ liệu trước khi chia tập.
- Nói "ngưỡng là 0,5" như một quy luật.
- Ghi trong CV những kỹ thuật bạn không giải thích được khi bị hỏi sâu.
Câu hỏi thường gặp
Phỏng vấn thực tập có hỏi sâu toán không?
Thường hỏi ở mức hiểu khái niệm (đạo hàm, xác suất có điều kiện, phép nhân ma trận) và áp dụng vào học máy. Vị trí nghiên cứu hỏi sâu hơn.
Có phải viết code trong phỏng vấn không?
Nhiều nơi có vòng lập trình: thuật toán cơ bản, xử lý dữ liệu với Python, đôi khi tự cài một thuật toán đơn giản. Xem trang tuyển dụng của công ty để biết.
Nên chuẩn bị bao nhiêu dự án?
Hai đến ba dự án bạn hiểu rất sâu tốt hơn mười dự án làm theo hướng dẫn. Mỗi dự án phải trả lời được: vì sao chọn chỉ số này, mốc so sánh là gì, mô hình sai ở đâu.
Dùng AI để luyện phỏng vấn được không?
Được: nhờ AI đóng vai người phỏng vấn, hỏi sâu vào dự án của bạn. Nhưng tự trả lời và kiểm lại kiến thức bằng tài liệu chính thức; AI có thể đưa câu trả lời mẫu nghe hay nhưng sai.
Học tiếp
- Các bước của một dự án học máy trong sản phẩm: lộ trình ML Engineer.
- Chuẩn bị CV và luyện phỏng vấn với AI: dùng AI viết CV.
- Toàn cảnh các nghề AI: AI Engineer làm gì.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.