- ML Engineer lo cả vòng đời của mô hình trong sản phẩm. Tài liệu MLOps của Google Cloud chia vòng đời thành tám bước: lấy dữ liệu, phân tích, chuẩn bị, huấn luyện, đánh giá, kiểm định, phục vụ (serving), theo dõi.
- Lộ trình năm giai đoạn: nền tảng; học máy và học sâu; kỹ thuật phần mềm; triển khai; vận hành. Phần thuật toán chỉ là một phần, phần lớn còn lại là kỹ thuật phần mềm và dữ liệu.
- Lời khuyên đầu tiên của Rules of ML (Google): đừng ngại ra sản phẩm khi chưa có học máy; đo chỉ số trước; giữ mô hình đầu đơn giản và làm đúng hạ tầng.
- Trong khảo sát Stack Overflow 2026, lương trung vị toàn cầu của nhóm tự nhận là AI/ML engineer là 95.337 USD/năm, trên 194 người trả lời có dữ liệu lương.
Bài này dựa trên hướng dẫn Rules of Machine Learning của Google, tài liệu MLOps của Google Cloud, bài báo Hidden Technical Debt in Machine Learning Systems (NeurIPS 2015) và khảo sát Stack Overflow 2026, đọc ngày 11/11/2026. Bài tổng về các nghề AI nằm ở AI Engineer làm gì.
ML Engineer làm gì
Một mô hình chạy tốt trong notebook mới là điểm bắt đầu. ML Engineer biến nó thành một dịch vụ mà sản phẩm gọi được hằng ngày, cho kết quả ổn định, đo được chất lượng, và được cập nhật khi dữ liệu ngoài đời thay đổi. Công việc cụ thể thường gồm xây đường ống dữ liệu, huấn luyện và tinh chỉnh mô hình, viết code kiểm thử cho cả dữ liệu lẫn mô hình, đóng gói mô hình thành API, triển khai lên máy chủ hay nền tảng đám mây, theo dõi chất lượng dự đoán và chi phí, rồi lên kế hoạch huấn luyện lại.
Tài liệu MLOps của Google Cloud mô tả quy trình một dự án học máy qua tám bước: lấy và tích hợp dữ liệu từ nhiều nguồn; phân tích khám phá để hiểu dữ liệu; chuẩn bị dữ liệu (làm sạch, chia tập huấn luyện, kiểm định, kiểm tra, tạo đặc trưng); huấn luyện và chỉnh siêu tham số; đánh giá trên tập kiểm tra; kiểm định xem mô hình có đủ tốt để triển khai, tức tốt hơn một mốc so sánh; phục vụ mô hình, ví dụ qua một dịch vụ REST API, trên thiết bị, hay chạy theo lô; và theo dõi hiệu quả trong sản phẩm để quyết định khi nào bắt đầu vòng lặp mới.
Bài báo Hidden Technical Debt in Machine Learning Systems của Sculley và cộng sự (NeurIPS 2015) cảnh báo rằng các thành công nhanh của học máy không miễn phí: hệ thống học máy thật dễ mang "nợ kỹ thuật" với chi phí bảo trì rất lớn. Các rủi ro bài báo nêu gồm ranh giới giữa các thành phần bị xói mòn, sự vướng víu giữa các đặc trưng, vòng phản hồi ẩn, những nơi dùng kết quả mô hình mà không khai báo, phụ thuộc dữ liệu, cấu hình rối, và thế giới bên ngoài thay đổi. Đó là lý do ML Engineer cần kỹ năng kỹ thuật phần mềm không kém kỹ năng mô hình.
Khác AI Engineer và Data Scientist
Data Scientist thường trả lời câu hỏi bằng dữ liệu: phân tích, thí nghiệm, mô hình thống kê, báo cáo cho người ra quyết định. ML Engineer chịu trách nhiệm đưa mô hình vào sản phẩm và giữ nó chạy tốt. AI Engineer, theo nghĩa phổ biến hiện nay, xây ứng dụng trên các mô hình nền tảng có sẵn qua API. Ba vai trò dùng chung nền tảng và ranh giới khác nhau giữa các công ty, nên khi đọc tin tuyển dụng, hãy đọc phần mô tả công việc hơn là chỉ nhìn chức danh.
Giai đoạn 1: nền tảng
Học gì. Python thành thạo (hàm, lớp, xử lý lỗi, đọc ghi tệp, môi trường ảo); numpy, pandas, matplotlib; SQL đủ để truy vấn, nối bảng, nhóm và tổng hợp; toán năm nhất: đại số tuyến tính, đạo hàm, xác suất và thống kê cơ bản. Xem các bài Python cho AI và toán cho AI.
Dự án. Lấy dữ liệu từ một cơ sở dữ liệu nhỏ (SQLite là đủ) bằng SQL, làm sạch bằng pandas, viết báo cáo phân tích ngắn có biểu đồ. Đưa lên GitHub kèm hướng dẫn chạy lại từ đầu.
Dấu hiệu đã xong. Bạn viết được một chương trình Python vài trăm dòng có cấu trúc hàm rõ ràng, và trả lời được một câu hỏi về dữ liệu bằng truy vấn SQL mà không tra cứu từng dòng.
Giai đoạn 2: học máy và học sâu
Học gì. Học có giám sát và không giám sát, đánh giá mô hình (precision, recall, đường ROC, kiểm định chéo), quá khớp và chính quy hóa, chọn đặc trưng; sau đó mạng nơ-ron, PyTorch, mạng tích chập, Transformer ở mức dùng được. Tài liệu: Machine Learning Specialization rồi Deep Learning Specialization (xem các khóa của Andrew Ng), hoặc theo lộ trình 6 tháng học AI.
Dự án. Một bài toán phân loại hoặc dự báo trên dữ liệu thật, so sánh ít nhất ba mô hình với một mốc đơn giản, có phân tích lỗi. Một dự án học sâu nhỏ dùng mô hình huấn luyện sẵn và tinh chỉnh.
Dấu hiệu đã xong. Bạn giải thích được vì sao chọn chỉ số đánh giá đó cho bài toán đó, và nhận ra khi kết quả "đẹp quá" là do rò rỉ dữ liệu.
Giai đoạn 3: kỹ thuật phần mềm cho học máy
Đây là giai đoạn nhiều người học AI bỏ qua, và cũng là chỗ phân biệt người làm được sản phẩm.
Học gì. Tổ chức code thành module thay vì một notebook dài; Git và quy trình pull request; viết test cho hàm xử lý dữ liệu và cho mô hình (ví dụ: đầu ra đúng kích thước, kết quả ổn định khi cố định hạt giống ngẫu nhiên); ghi log; quản lý cấu hình; tái lập kết quả (ghi phiên bản dữ liệu, code, tham số). Khóa Made With ML (của Goku Mohandas, nay thuộc Anyscale) đi đúng các chủ đề này: thiết kế, dữ liệu, mô hình, phát triển, kiểm thử code, dữ liệu và mô hình, tái lập, đưa vào sản phẩm.
Dự án. Chuyển dự án giai đoạn 2 từ notebook thành một gói Python có lệnh huấn luyện và lệnh dự đoán, có test, có workflow tự chạy test trên GitHub Actions (xem bài GitHub Actions).
Dấu hiệu đã xong. Một người khác clone kho của bạn, chạy hai lệnh và ra đúng kết quả bạn báo cáo.
Giai đoạn 4: triển khai mô hình
Học gì. Đóng gói mô hình thành một dịch vụ web trả kết quả dự đoán, ví dụ dùng FastAPI; đóng gói môi trường bằng Docker để chạy giống nhau ở mọi nơi; khái niệm phục vụ trực tuyến (từng yêu cầu) và theo lô (nhiều bản ghi một lúc); độ trễ, thông lượng, chi phí. Tài liệu chính thức của FastAPI và trang Get started của Docker là điểm bắt đầu tốt.
Dự án. Dịch vụ dự đoán cho mô hình của bạn: một endpoint nhận dữ liệu, trả kết quả và phiên bản mô hình; chạy trong container; có tài liệu API và một kịch bản gửi thử 100 yêu cầu để đo độ trễ.
Dấu hiệu đã xong. Bạn triển khai lại được dịch vụ trên một máy khác chỉ bằng vài lệnh, và biết dịch vụ chậm ở bước nào.
Giai đoạn 5: vận hành (MLOps)
Tài liệu MLOps của Google Cloud mô tả ba mức trưởng thành. Mức 0: mọi bước làm tay bằng kịch bản và notebook, người làm dữ liệu và người làm hệ thống tách rời, mô hình ít khi được cập nhật. Mức 1: tự động hóa đường ống học máy để huấn luyện liên tục khi có dữ liệu mới. Mức 2: tự động hóa cả việc xây dựng, kiểm thử và triển khai các thành phần của đường ống (CI/CD), để thử ý tưởng mới nhanh và an toàn.
Học gì. Theo dõi thí nghiệm và quản lý phiên bản mô hình (ví dụ MLflow); kiểm định mô hình trước khi triển khai so với mốc; theo dõi lệch dữ liệu và chất lượng dự đoán; lên lịch huấn luyện lại; quay về phiên bản cũ khi mô hình mới kém.
Dự án. Thêm cho dịch vụ ở giai đoạn 4: ghi lại dữ liệu đầu vào, một báo cáo hằng tuần về phân bố dữ liệu so với lúc huấn luyện, và một quy trình huấn luyện lại chỉ triển khai khi mô hình mới vượt mốc.
Mô phỏng một đường ống nhỏ
Để thấy các bước trên ghép với nhau thế nào, đoạn Python dưới đây mô phỏng một đường ống rất nhỏ, chỉ dùng thư viện có sẵn. Bài toán giả định: dự đoán học viên có hoàn thành khóa học không, dựa trên số giờ học mỗi tuần. Mô hình cố tình đơn giản (một ngưỡng giờ học), đúng tinh thần Rules of ML: giữ mô hình đầu tiên đơn giản và làm đúng hạ tầng. Đường ống chia dữ liệu, huấn luyện, so với mốc "luôn đoán lớp nhiều nhất", chỉ cho qua cổng kiểm định khi hơn mốc rõ rệt, tạo mã phiên bản từ thông tin mô hình, rồi theo dõi dữ liệu mới để phát hiện lệch.
"""Một đường ống ML rất nhỏ, đi qua các bước mà tài liệu MLOps của Google Cloud liệt kê:
chuẩn bị dữ liệu -> huấn luyện -> đánh giá -> kiểm định (phải hơn mốc so sánh) -> lưu mô hình kèm phiên bản -> theo dõi.

Bài toán giả định: dự đoán học viên có hoàn thành khóa học không, từ số giờ học mỗi tuần.
Mô hình cố tình đơn giản (một ngưỡng) để thấy rõ phần "kỹ thuật" quanh mô hình, đúng tinh thần Rules of ML:
giữ mô hình đầu tiên đơn giản và làm đúng hạ tầng.
"""
import hashlib
import json
import random
import statistics


def tao_du_lieu(n, lech=0.0, hat=1):
    rng = random.Random(hat)
    ds = []
    for _ in range(n):
        gio = max(0.0, rng.gauss(6 + lech, 3))
        xong = 1 if gio + rng.gauss(0, 2) > 6 else 0
        ds.append((gio, xong))
    return ds


def chia(ds, ti_le=0.8):
    k = int(len(ds) * ti_le)
    return ds[:k], ds[k:]


def huan_luyen(tap):
    """Tìm ngưỡng giờ học cho độ chính xác cao nhất trên tập huấn luyện."""
    ung_vien = sorted({round(g, 1) for g, _ in tap})
    return max(ung_vien, key=lambda t: sum((g > t) == bool(y) for g, y in tap))


def do_chinh_xac(du_doan, tap):
    return sum(du_doan(g) == y for g, y in tap) / len(tap)


def chay_duong_ong(hat=1):
    ds = tao_du_lieu(500, hat=hat)
    tap_hl, tap_kt = chia(ds)
    nguong = huan_luyen(tap_hl)
    lop_nhieu = round(statistics.mean(y for _, y in tap_hl))
    acc_moc = do_chinh_xac(lambda g: lop_nhieu, tap_kt)           # mốc: luôn đoán lớp nhiều nhất
    acc_mh = do_chinh_xac(lambda g: int(g > nguong), tap_kt)
    dat = acc_mh > acc_moc + 0.05                                  # cổng kiểm định: phải hơn mốc rõ rệt
    the = {"mo_hinh": "nguong_gio_hoc", "nguong": nguong, "acc_kiem_tra": round(acc_mh, 3),
           "acc_moc": round(acc_moc, 3), "tb_gio_hl": round(statistics.mean(g for g, _ in tap_hl), 2),
           "sd_gio_hl": round(statistics.stdev(g for g, _ in tap_hl), 2)}
    the["phien_ban"] = hashlib.sha256(json.dumps(the, sort_keys=True).encode()).hexdigest()[:8]
    return the, dat


def theo_doi(the, du_lieu_moi, nguong_z=3.0):
    """Báo lệch dữ liệu khi trung bình giờ học mới cách trung bình lúc huấn luyện quá nguong_z sai số chuẩn."""
    tb = statistics.mean(g for g, _ in du_lieu_moi)
    sai_so = the["sd_gio_hl"] / len(du_lieu_moi) ** 0.5
    z = (tb - the["tb_gio_hl"]) / sai_so
    return round(z, 1), abs(z) > nguong_z


def chay_thu():
    the, dat = chay_duong_ong()
    dong = [f"Ngưỡng học được: {the['nguong']} giờ/tuần",
            f"Độ chính xác trên tập kiểm tra: mô hình {the['acc_kiem_tra']}, mốc {the['acc_moc']}",
            f"Cổng kiểm định: {'ĐẠT, lưu mô hình phiên bản ' + the['phien_ban'] if dat else 'KHÔNG ĐẠT, giữ mô hình cũ'}"]
    for ten, lech in (("tuần 1", 0.0), ("tuần 8", 2.0)):
        z, canh_bao = theo_doi(the, tao_du_lieu(200, lech=lech, hat=7))
        dong.append(f"Theo dõi {ten}: z = {z} -> {'CẢNH BÁO lệch dữ liệu, xem xét huấn luyện lại' if canh_bao else 'ổn'}")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Kết quả: ngưỡng học được là 5,9 giờ mỗi tuần; trên tập kiểm tra, mô hình đúng 85% trong khi mốc chỉ 48%, nên qua cổng kiểm định và được lưu với một mã phiên bản. Ở bước theo dõi, dữ liệu tuần 1 giống lúc huấn luyện (chỉ số z khoảng -0,3, ổn); dữ liệu tuần 8, khi học viên học nhiều hơn trung bình 2 giờ, có z khoảng 9,6 và bị cảnh báo lệch dữ liệu. Trong hệ thống thật, cảnh báo đó sẽ kích hoạt việc xem xét và huấn luyện lại. Cùng một khung này áp dụng cho mô hình phức tạp hơn; phần khó của nghề nằm ở chỗ làm các bước quanh mô hình chạy ổn định.
Lời khuyên từ Rules of Machine Learning
Hướng dẫn Rules of Machine Learning của Martin Zinkevich (Google) có nhiều quy tắc thực tế; bốn quy tắc đầu đặc biệt hợp với người mới làm sản phẩm. Thứ nhất, đừng ngại ra mắt sản phẩm khi chưa có học máy: một quy tắc đơn giản có thể đủ dùng lúc đầu. Thứ hai, thiết kế và ghi nhận chỉ số trước khi làm mô hình, để biết mô hình có thực sự giúp gì không. Thứ ba, khi quy tắc thủ công trở nên quá phức tạp thì mới chuyển sang học máy. Thứ tư, giữ mô hình đầu tiên đơn giản và tập trung làm đúng hạ tầng. Tinh thần chung của tài liệu là làm học máy như một kỹ sư giỏi, thay vì cố làm như một chuyên gia học máy mà mình chưa phải.
Số liệu nghề, đọc cho đúng
Bảng lương theo vai trò của khảo sát Stack Overflow 2026 (người trả lời toàn cầu, lương quy ra USD) ghi lương trung vị của nhóm tự nhận là AI/ML engineer là 95.337 USD/năm trên 194 người trả lời, data scientist 90.982 USD trên 155 người, data engineer 90.000 USD trên 233 người. Theo trang phương pháp, khảo sát ghi nhận phản hồi từ 23/06 đến 05/08/2026 với 30.903 phản hồi hợp lệ. Đây là số toàn cầu và số người mỗi nhóm nhỏ, nên chỉ dùng để thấy vị trí tương đối giữa các vai trò, không phải mức lương ở Việt Nam. Chi tiết cách đọc số liệu có trong bài AI Engineer làm gì.
Thời gian và cách học
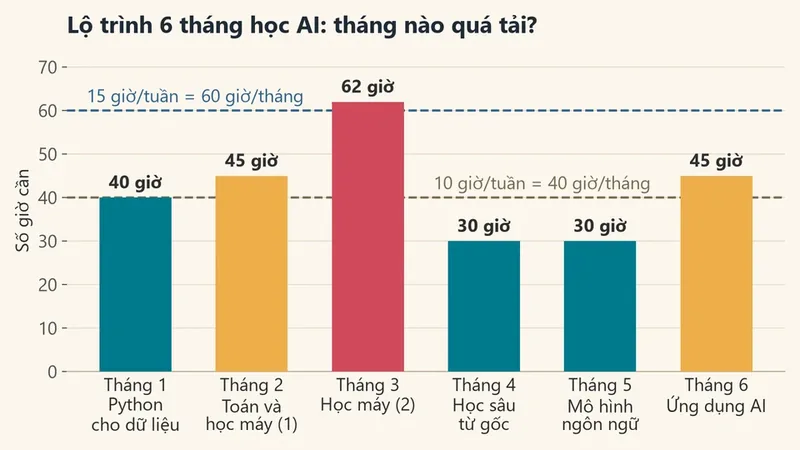
Với sinh viên học đều 10 đến 15 giờ mỗi tuần, giai đoạn 1 và 2 thường mất khoảng sáu tháng, giai đoạn 3 đến 5 thêm khoảng sáu tháng nữa nếu làm dự án nghiêm túc. Đây là ước lượng của bài viết; người đã có nền kỹ thuật phần mềm đi giai đoạn 3 rất nhanh, người có nền thống kê đi giai đoạn 2 nhanh hơn. Không nên học song song quá nhiều giai đoạn; nhưng có thể bắt đầu thói quen của giai đoạn 3 (Git, test) ngay từ dự án đầu tiên.
Khi bắt đầu ứng tuyển, chuẩn bị phỏng vấn theo bài câu hỏi phỏng vấn Machine Learning, và đưa các dự án theo từng giai đoạn vào portfolio.
- Chỉ học thuật toán, bỏ qua Git, test, đóng gói, rồi không đưa được mô hình nào vào sản phẩm.
- Dùng mô hình phức tạp ngay từ đầu khi chưa có mốc so sánh và chưa có chỉ số đo.
- Triển khai mô hình mà không theo dõi, đến khi dữ liệu đổi thì kết quả xấu đi không ai biết.
- Không ghi phiên bản dữ liệu và mô hình, không tái lập được kết quả đã báo cáo.
- Trích lương toàn cầu như thể là lương ở Việt Nam.
Câu hỏi thường gặp
Có cần bằng thạc sĩ để làm ML Engineer không?
Không bắt buộc ở nhiều nơi; yêu cầu khác nhau theo công ty. Với vị trí sản phẩm, kỹ năng kỹ thuật phần mềm và dự án đã triển khai thường được coi trọng không kém bằng cấp. Vị trí nghiên cứu thì hay yêu cầu bằng cao hơn.
Nên học MLOps khi nào?
Sau khi đã làm được ít nhất một mô hình hoàn chỉnh và đóng gói được nó thành dịch vụ. MLOps giải quyết vấn đề của mô hình đang chạy; chưa có mô hình chạy thì khó hiểu vì sao cần.
Phải biết đám mây (cloud) nào?
Biết khái niệm chung (máy ảo, lưu trữ, container, dịch vụ quản lý mô hình) quan trọng hơn biết một nhà cung cấp cụ thể. Khi đi làm, học theo nền tảng công ty dùng.
Từ lập trình viên phần mềm chuyển sang có khó không?
Bạn đã có sẵn giai đoạn 3 và một phần giai đoạn 4. Tập trung vào giai đoạn 2 (học máy, đánh giá mô hình) và phần theo dõi dữ liệu ở giai đoạn 5.
Học tiếp
- Toàn cảnh các nghề AI: AI Engineer làm gì.
- Chuẩn bị phỏng vấn: câu hỏi phỏng vấn Machine Learning.
- Kế hoạch học nền tảng theo tháng: lộ trình 6 tháng học AI.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Google for Developers: Rules of Machine Learning (Martin Zinkevich)
- Google Cloud: MLOps: Continuous delivery and automation pipelines in machine learning
- Sculley và cộng sự (NeurIPS 2015): Hidden Technical Debt in Machine Learning Systems
- Stack Overflow Developer Survey 2026: Work (Full data)
- Made With ML
- FastAPI
- Docker Docs: Get started