- Chưng cất cho mô hình nhỏ học "nhãn mềm": phân phối xác suất của mô hình lớn trên mọi đáp án, không chỉ đáp án đúng. Xác suất của các đáp án sai cho biết thầy thấy những gì giống nhau.
- Hinton và cộng sự chia logit cho một nhiệt độ
Ttrước softmax để nhãn mềm hơn, và nhân phần mất mát mềm vớiT²để giữ cân bằng với phần nhãn thật. - DistilBERT nhỏ hơn BERT 40%, nhanh hơn 60%, giữ 97% điểm hiểu ngôn ngữ trên GLUE.
- Với mô hình ngôn ngữ lớn, cách phổ biến là cho trò học thẳng chữ do thầy viết: DeepSeek-R1-Distill-Qwen-32B học 800 nghìn mẫu của R1 và đạt 72,6% AIME 2024, so với 47,0% khi tự học tăng cường.
Code trong bài là Python 3 dùng numpy (máy viết bài dùng numpy 2.5.4). Số liệu lấy từ bản PDF của các bài báo trên arXiv, đọc ngày 12/11/2026.
Chưng cất mô hình là gì
Bài báo của Hinton, Vinyals và Dean mở đầu bằng hình ảnh côn trùng: ấu trùng sinh ra để hút chất dinh dưỡng, con trưởng thành sinh ra để di chuyển và sinh sản. Học máy cũng có hai giai đoạn với nhu cầu khác nhau. Lúc huấn luyện, ta chịu được một mô hình cồng kềnh, chẳng hạn một tập hợp nhiều mô hình hay một mô hình rất lớn. Lúc đưa cho rất nhiều người dùng, ta cần mô hình nhỏ và nhanh. Chưng cất là bước chuyển kiến thức từ mô hình thứ nhất sang mô hình thứ hai.
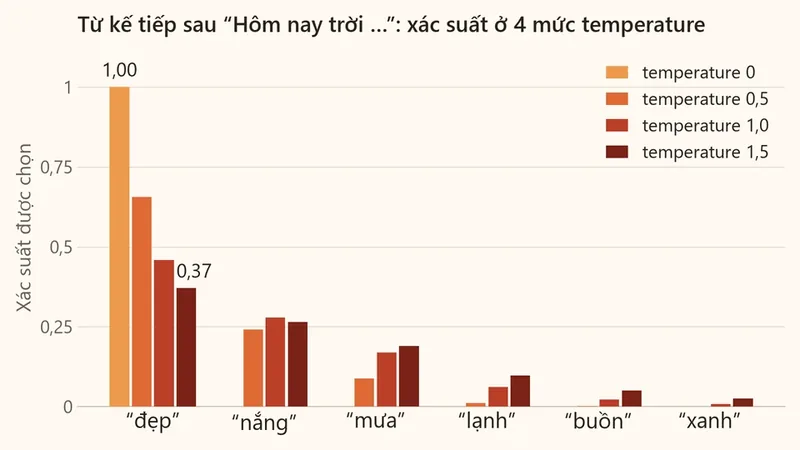
Ý tưởng then chốt của bài báo là đổi cách nhìn về "kiến thức". Nếu coi kiến thức là các giá trị tham số thì khó hình dung chuyện đổi kiến trúc mà vẫn giữ kiến thức. Nếu coi kiến thức là ánh xạ từ đầu vào sang đầu ra thì việc của trò rất rõ: cho ra đầu ra giống thầy. Lưu ý hai chữ dễ nhầm: nhiệt độ ở đây dùng lúc huấn luyện để làm mềm nhãn, khác nhiệt độ lúc sinh chữ trong bài temperature là gì; và chưng cất tạo ra một mô hình mới, khác việc chọn mô hình nhỏ hay lớn cho từng câu hỏi.
Nhãn mềm và nhiệt độ
Một mô hình phân loại tốt vẫn gán xác suất cho mọi đáp án sai, và các xác suất đó không bằng nhau. Bài báo lấy ví dụ: ảnh một chiếc BMW có rất ít khả năng bị nhầm thành xe chở rác, nhưng khả năng đó vẫn lớn hơn nhiều lần khả năng bị nhầm thành củ cà rốt. Với chữ số viết tay, một ảnh số 2 có thể được gán xác suất \(10^{-6}\) là số 3 và \(10^{-9}\) là số 7. Thông tin "số 2 này giống số 3" rất quý, nhưng gần như không ảnh hưởng tới mất mát entropy chéo vì các xác suất quá gần 0.
Cách giải của Hinton là tăng nhiệt độ \(T\) của softmax (phương trình 1):
\[q_i = \frac{\exp(z_i / T)}{\sum_j \exp(z_j / T)}\]
\(T = 1\) là softmax thường; \(T\) càng lớn, phân phối càng phẳng và các đáp án sai càng lộ ra. Hình dưới dùng một bộ logit dựng sẵn cho ảnh số 2, chọn để ở \(T = 1\) ra đúng cỡ \(10^{-6}\) và \(10^{-9}\) như ví dụ trong bài báo.
T = 1, gần như toàn bộ xác suất dồn vào số 2 (số 3 chỉ khoảng 10⁻⁶); ở T = 8, số 3 được 0,10 và số 7 được 0,04: ảnh này giống 3 hơn giống 7.Hàm mất mát chưng cất
Bài báo dùng trung bình có trọng số của hai mục tiêu. Mục tiêu thứ nhất là entropy chéo giữa nhãn mềm của thầy và của trò, cả hai tính ở cùng nhiệt độ cao \(T\). Mục tiêu thứ hai là entropy chéo với nhãn thật, tính ở \(T = 1\), với trọng số nhỏ hơn đáng kể:
\[\begin{aligned} \mathcal{L} = \alpha\, T^2\, &\text{CE}\big(p^{(T)}, q^{(T)}\big) \\ &+ (1 - \alpha)\, \text{CE}\big(y, q^{(1)}\big) \end{aligned}\]
Vì sao có \(T^2\)? Phương trình 2 của bài báo cho đạo hàm của phần mềm theo logit \(z_i\) của trò:
\[\frac{\partial C}{\partial z_i} = \frac{1}{T}\,(q_i - p_i)\]
Khi \(T\) lớn, \(q_i - p_i\) cũng nhỏ đi theo \(1/T\), nên cả gradient nhỏ đi cỡ \(1/T^2\). Nhân với \(T^2\) giữ tỉ lệ đóng góp của hai phần gần như không đổi khi đổi \(T\). Bài báo còn chỉ ra: khi \(T\) rất lớn và logit đã trừ trung bình, gradient xấp xỉ \((z_i - v_i)/(NT^2)\), với \(v_i\) là logit của thầy và \(N\) là số lớp. Tức là khớp logit, cách mà Caruana và cộng sự dùng trước đó, chỉ là một trường hợp riêng của chưng cất. Ở nhiệt độ vừa phải, chưng cất bỏ qua phần nào các logit rất âm, vốn hay nhiễu; khi trò quá nhỏ so với thầy, bài báo thấy nhiệt độ trung bình cho kết quả tốt nhất.
Thí nghiệm nhỏ bằng numpy
Code dưới làm hai việc. Phần đầu tính các xác suất trong Hình 1. Phần sau là một thí nghiệm: ba lớp điểm trên mặt phẳng, thầy là bộ phân loại dùng đặc trưng bậc hai học trên 5.000 điểm, trò chỉ là bộ phân loại tuyến tính học trên 30 điểm. Trò học theo ba cách, mỗi cách lặp 20 lần với 20 bộ 30 điểm khác nhau, rồi đo trên 20.000 điểm kiểm tra.
"""Chưng cất kiểu Hinton trên số nhỏ: softmax có nhiệt độ, hàm mất mát chưng cất, và một thí nghiệm
thầy mạnh (đặc trưng bậc hai) dạy trò yếu (tuyến tính) chỉ với 30 ví dụ.
Chạy: python chung_cat.py
"""
import numpy as np


def softmax(z, T=1.0):
    z = np.asarray(z, dtype=float) / T
    z = z - z.max(axis=-1, keepdims=True)
    e = np.exp(z)
    return e / e.sum(axis=-1, keepdims=True)


# Logit của "thầy" cho một ảnh chữ số 2 (lớp 0..9): rất chắc là 2, hơi giống 3, rất ít giống 7.
LOGIT_SO_2 = np.array([-8, -8, 14, 0.2, -8, -8, -8, -6.7, -8, -8])


def mat_mat(z, v, y, T, alpha):
    """alpha * T^2 * CE(mềm của thầy, mềm của trò) + (1 - alpha) * CE(nhãn thật, trò ở T = 1)."""
    p, q, q1 = softmax(v, T), softmax(z, T), softmax(z, 1.0)
    mem = -np.sum(p * np.log(q), axis=-1)
    cung = -np.log(q1[np.arange(len(y)), y]) if np.ndim(z) > 1 else -np.log(q1[y])
    return np.mean(alpha * T**2 * mem + (1 - alpha) * cung)


def gradient(z, v, y, T, alpha):
    """Đạo hàm theo logit của trò: alpha * T * (q_T - p_T) + (1 - alpha) * (q_1 - một_nóng(y))."""
    p, q, q1 = softmax(v, T), softmax(z, T), softmax(z, 1.0)
    return alpha * T * (q - p) + (1 - alpha) * (q1 - np.eye(z.shape[-1])[y])


# ---------- thí nghiệm: 3 lớp trên mặt phẳng, thầy dùng đặc trưng bậc hai, trò chỉ tuyến tính
TAM = np.array([[0, 0], [2.2, 0.4], [1.0, 2.0]])
DO_RONG = np.array([1.0, 0.5, 1.4])


def du_lieu(n, rng):
    y = rng.integers(0, 3, n)
    return TAM[y] + rng.normal(0, 1.0, (n, 2)) * DO_RONG[y][:, None], y


def tuyen_tinh(X):
    return np.c_[X, np.ones(len(X))]


def bac_hai(X):
    return np.c_[X, X**2, X[:, :1] * X[:, 1:], np.ones(len(X))]


def hoc(F, v_thay, y, T, alpha, so_buoc=4000, toc_do=0.3):
    W = np.zeros((3, F.shape[1]))
    for _ in range(so_buoc):
        W -= toc_do * gradient(F @ W.T, v_thay, y, T, alpha).T @ F / len(F)
    return W


def thi_nghiem(so_lan=20, n_tro=30, seed=0):
    rng = np.random.default_rng(seed)
    X, y = du_lieu(5000, rng)
    W_thay = hoc(bac_hai(X), np.zeros((len(X), 3)), y, 1.0, 0.0, 6000, 0.1)  # alpha = 0: chỉ học nhãn thật
    X_kt, y_kt = du_lieu(20000, rng)
    dung = lambda W, F: float(np.mean(np.argmax(F(X_kt) @ W.T, axis=1) == y_kt))  # noqa: E731
    kq = {"thầy (bậc hai, 5000 ví dụ)": dung(W_thay, bac_hai), "trò học nhãn thật": [],
          "trò học nhãn mềm T = 1": [], "trò học nhãn mềm T = 4": []}
    for _ in range(so_lan):
        Xs, ys = du_lieu(n_tro, rng)
        v = bac_hai(Xs) @ W_thay.T
        F = tuyen_tinh(Xs)
        kq["trò học nhãn thật"].append(dung(hoc(F, v, ys, 1.0, 0.0), tuyen_tinh))
        kq["trò học nhãn mềm T = 1"].append(dung(hoc(F, v, ys, 1.0, 1.0), tuyen_tinh))
        kq["trò học nhãn mềm T = 4"].append(dung(hoc(F, v, ys, 4.0, 1.0), tuyen_tinh))
    return {k: (float(np.mean(x)) if isinstance(x, list) else x) for k, x in kq.items()}


if __name__ == "__main__":
    for T in (1, 4, 8):
        p = softmax(LOGIT_SO_2, T)
        print(f"T = {T}: P(2) = {p[2]:.3g}, P(3) = {p[3]:.3g}, P(7) = {p[7]:.3g}")
    for ten, ty_le in thi_nghiem().items():
        print(f"{ten}: đúng {ty_le:.1%} trên 20.000 điểm kiểm tra")
| Mô hình | Tỉ lệ đúng trung bình |
|---|---|
| Thầy, đặc trưng bậc hai, 5.000 ví dụ | 82,8% |
| Trò tuyến tính, 30 ví dụ, nhãn thật | 75,7% |
Trò tuyến tính, 30 ví dụ, nhãn mềm của thầy ở T = 1 |
78,9% |
Trò tuyến tính, 30 ví dụ, nhãn mềm của thầy ở T = 4 |
73,4% |
Cùng 30 ví dụ, học nhãn mềm của thầy cho trò thêm hơn 3 điểm phần trăm: mỗi ví dụ nói cho trò biết thầy chắc chắn tới đâu, chứ không chỉ một nhãn. Nhưng tăng nhiệt độ lên 4 lại làm trò kém đi. Trò ở đây là đường thẳng, không thể bắt chước đường cong bậc hai của thầy; ở nhiệt độ cao, việc học gần với khớp toàn bộ logit, kể cả những logit trò không thể nào khớp. Kết quả này khớp với xu hướng bài báo ghi: trò càng nhỏ thì nhiệt độ tốt nhất càng thấp. Với mạng chỉ 30 nơ-ron mỗi lớp, nhiệt độ từ 2,5 đến 4 tốt nhất, còn mạng từ 300 nơ-ron mỗi lớp trở lên thì mọi nhiệt độ trên 8 cho kết quả gần như nhau. Nhiệt độ là một siêu tham số phải thử, không có giá trị đúng cho mọi trường hợp.
Kết quả trong bài báo gốc
Trên MNIST, một mạng lớn hai lớp ẩn 1.200 nơ-ron, có dropout và dịch ảnh ngẫu nhiên, mắc 67 lỗi trên tập kiểm tra. Mạng nhỏ hai lớp 800 nơ-ron, học bình thường và không có điều chuẩn, mắc 146 lỗi. Cũng mạng nhỏ đó, chỉ thêm việc khớp nhãn mềm của mạng lớn ở \(T = 20\), còn 74 lỗi. Thí nghiệm ấn tượng nhất: bỏ hết ảnh số 3 khỏi dữ liệu dạy trò. Trò chưa từng thấy số 3, vậy mà sau khi chỉnh độ lệch của lớp 3 thêm 3,5, nó nhận đúng 98,6% số 3 trong tập kiểm tra, nhờ những gì nhãn mềm của các chữ số khác tiết lộ về số 3.
Với nhận dạng tiếng nói, một hệ thống thương mại có tỉ lệ đúng theo khung 58,9% và tỉ lệ lỗi từ 10,9%. Gộp 10 mô hình được 61,1% và 10,7%; một mô hình chưng cất từ 10 mô hình đó được 60,8% và 10,7%, tức giữ gần hết lợi ích của cả tập hợp trong một mô hình.
DistilBERT: chưng cất lúc tiền huấn luyện
DistilBERT của Hugging Face chưng cất BERT ngay ở giai đoạn tiền huấn luyện, để ra một mô hình đa dụng. Trò giữ kiến trúc của BERT nhưng chỉ còn một nửa số lớp, và được khởi tạo bằng cách lấy một lớp trong mỗi hai lớp của thầy. Hàm mất mát gồm ba phần: chưng cất trên nhãn mềm, mô hình hóa ngôn ngữ có che từ như BERT, và một phần kéo hướng các vectơ ẩn của trò về hướng của thầy.
Kết quả: 66 triệu tham số so với 110 triệu, chạy một lượt tập STS-B trên CPU mất 410 giây so với 668 giây, điểm GLUE 77,0 so với 79,5, tức giữ khoảng 97%. Bảng thử bỏ từng phần cho thấy phần chưng cất quan trọng nhất: bỏ nó mất 2,96 điểm GLUE, bỏ phần kéo vectơ mất 1,46, bỏ phần che từ chỉ mất 0,31, còn khởi tạo ngẫu nhiên thay vì lấy lớp của thầy mất 3,69. DistilBERT học trong khoảng 90 giờ trên 8 GPU V100.
Chưng cất mô hình ngôn ngữ lớn
Với mô hình ngôn ngữ lớn, cách hay gặp nhất là cho trò học thẳng chữ do thầy viết, không cần logit. DeepSeek dùng R1 sinh khoảng 800 nghìn mẫu, gồm khoảng 600 nghìn lời giải suy luận đã kiểm đúng và khoảng 200 nghìn mẫu khác, rồi tinh chỉnh có giám sát các mô hình mở Qwen và Llama trong 2 đến 3 vòng, không có bước học tăng cường nào. Theo Bảng 15 của bài báo, bản Qwen 1,5 tỷ tham số đạt 28,9% trên AIME 2024, cao hơn GPT-4o-0513 (9,3%) và Claude-3.5-Sonnet-1022 (16,0%); bản Qwen 32 tỷ đạt 72,6%.
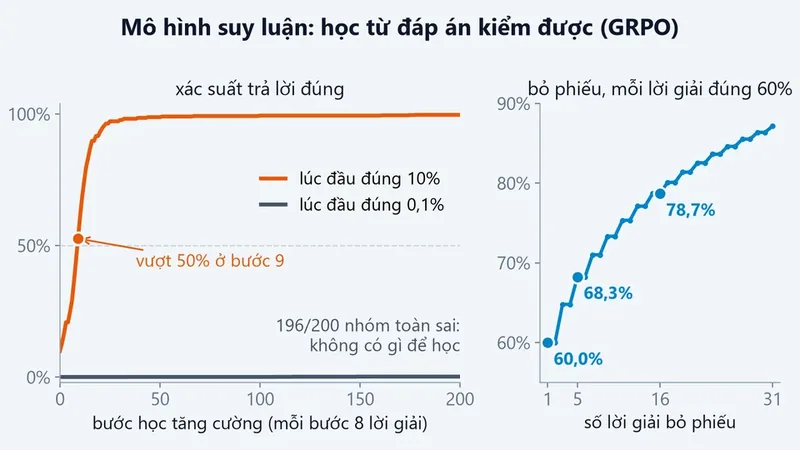
Bảng 16 so trực tiếp: cùng mô hình gốc Qwen2.5-32B, tự học tăng cường hơn 10 nghìn bước chỉ được 47,0%, còn chưng cất từ R1 được 72,6%. Bài báo rút ra hai kết luận. Chưng cất từ mô hình mạnh xuống mô hình nhỏ cho kết quả rất tốt và rẻ hơn nhiều so với để mô hình nhỏ tự học tăng cường. Nhưng muốn vượt xa hơn vẫn cần mô hình gốc mạnh hơn và học tăng cường quy mô lớn hơn, như bài mô hình suy luận mô tả. Nếu thầy là mô hình thương mại gọi qua API, hãy đọc điều khoản sử dụng của nhà cung cấp trước khi dùng đầu ra của họ để huấn luyện mô hình khác.
- Chỉ dùng nhãn cứng do thầy chọn: bỏ mất phần thông tin quý nhất là xác suất của các đáp án khác.
- Quên nhân phần mềm với
T²khi đổi nhiệt độ: tỉ lệ giữa hai phần mất mát thay đổi theoT. - Chọn nhiệt độ rất cao cho một trò quá nhỏ: trò cố khớp cả những logit nó không thể khớp.
- So trò với thầy trên chính dữ liệu dùng để chưng cất thay vì trên tập kiểm tra riêng.
Câu hỏi thường gặp
Knowledge distillation là gì?
Là huấn luyện mô hình nhỏ bắt chước đầu ra của mô hình lớn, thường là phân phối xác suất làm mềm bằng nhiệt độ, kèm một phần nhỏ học nhãn thật.
Chưng cất khác tinh chỉnh thế nào?
Tinh chỉnh học từ nhãn hoặc câu mẫu do người làm; chưng cất học từ đầu ra của một mô hình thầy. Với mô hình ngôn ngữ lớn, chưng cất thường được làm bằng chính phép tinh chỉnh có giám sát trên chữ do thầy sinh ra.
Vì sao mô hình chưng cất lại tốt hơn mô hình cùng cỡ học bình thường?
Vì nhãn mềm mang nhiều thông tin hơn trên mỗi ví dụ: trò biết đáp án nào gần đúng, đáp án nào sai hẳn, và học được cách thầy khái quát hóa.
Có cần logit của thầy không?
Không bắt buộc. Cách của Hinton cần xác suất hoặc logit; cách của DeepSeek-R1 chỉ cần chữ do thầy viết.
Học tiếp
- Mô hình suy luận: DeepSeek-R1 được huấn luyện thế nào trước khi làm thầy.
- Temperature là gì: nhiệt độ lúc sinh chữ, cùng công thức softmax.
- Định tuyến mô hình: khi nào dùng mô hình nhỏ, khi nào dùng mô hình lớn.
- Quantization là gì: một cách nén mô hình khác, giảm số bit của mỗi trọng số.
Nếu bạn muốn học Python và học máy bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Hinton, Vinyals, Dean (2015), Distilling the Knowledge in a Neural Network, arXiv 1503.02531v1 (PDF, đọc 12/11/2026)
- Sanh và cộng sự (2019), DistilBERT, a distilled version of BERT, arXiv 1910.01108v4 (PDF, đọc 12/11/2026)
- DeepSeek-AI (2025), DeepSeek-R1, phụ lục F về chưng cất, arXiv 2501.12948v2 ngày 4/1/2026 (PDF, đọc 12/11/2026)
- NumPy (thư viện dùng trong code)