- Mô hình suy luận được dạy viết chuỗi suy nghĩ dài chủ yếu bằng học tăng cường, với phần thưởng do máy chấm: đáp số đúng hay sai, code qua test hay không.
- DeepSeek-R1-Zero chỉ dùng học tăng cường trên mô hình gốc, không có bước SFT. Điểm AIME 2024 (lấy một lần) tăng từ 15,6% lên 77,9%, và câu trả lời tự dài ra trong lúc học.
- Thuật toán GRPO bỏ mô hình giá trị của PPO: mỗi câu hỏi lấy một nhóm lời giải và so từng lời giải với trung bình nhóm. Nhóm toàn đúng hay toàn sai không cho tín hiệu học.
- Tính toán lúc trả lời (test-time compute) là trục mở rộng thứ hai: lấy nhiều mẫu, bỏ phiếu hoặc cho mô hình tự sửa; Snell và cộng sự cho thấy chia tính toán khéo có thể thắng mô hình lớn hơn khoảng 14 lần trên câu không quá khó.
Code trong bài là Python 3 dùng numpy (máy viết bài dùng numpy 2.5.4). Số liệu lấy từ bản PDF của các bài báo trên arXiv, đọc ngày 12/11/2026. Bài DeepSeek-R1 dùng bản v2 ngày 4/1/2026: bản v1 ngày 22/1/2025 ghi điểm AIME của R1-Zero tăng từ 15,6% lên 71,0%, bản v2 ghi 77,9%, nên khi trích số liệu hãy ghi rõ phiên bản.
Mô hình suy luận là gì
Bài extended thinking là gì chỉ cách bật chế độ suy nghĩ khi gọi API và vì sao nghĩ trước giúp giải bài khó. Bài này đi một tầng sâu hơn: khả năng viết một chuỗi suy nghĩ dài, biết dừng lại kiểm tra và đổi hướng, được huấn luyện ra sao.
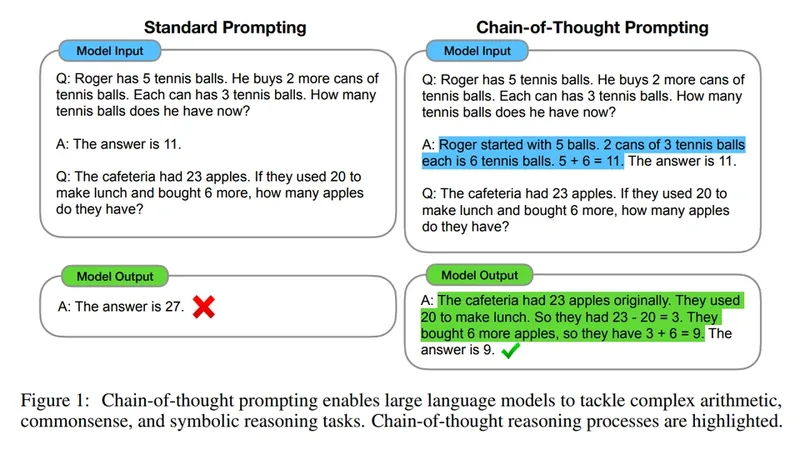
Có hai cách cũ để mô hình viết các bước trung gian. Cách thứ nhất là nhắc trong prompt, kiểu "hãy suy nghĩ từng bước". Cách thứ hai là tinh chỉnh trên lời giải mẫu do người viết. Bài báo DeepSeek-R1 chỉ ra giới hạn của cách thứ hai: cần nhiều người gán nhãn, và mô hình chỉ giỏi tới mức lời giải mẫu cho phép. Hướng mới là để mô hình tự tìm cách suy luận bằng học tăng cường, chỉ thưởng cho đáp án cuối đúng.
DeepSeek-R1-Zero: chỉ học tăng cường
DeepSeek bắt đầu từ mô hình gốc DeepSeek-V3-Base và bỏ hẳn bước tinh chỉnh có giám sát, vì cho rằng khuôn suy luận do người đặt có thể hạn chế việc khám phá. Prompt chỉ có một khuôn cố định: mô hình viết suy nghĩ trong cặp thẻ think, rồi đáp án trong cặp thẻ answer.
Phần thưởng hoàn toàn chấm bằng quy tắc. Phần thưởng đúng sai kiểm đáp số toán viết trong một khung định sẵn, hoặc chạy code qua trình biên dịch và bộ test. Phần thưởng định dạng kiểm mô hình có đặt suy nghĩ vào đúng thẻ. Hai phần cộng với trọng số bằng nhau. Bài báo ghi rõ họ không dùng mô hình thưởng bằng mạng nơ-ron cho bài suy luận, vì mô hình đó dễ bị "lách" (reward hacking) khi học tăng cường ở quy mô lớn, và huấn luyện lại nó tốn kém.
Kết quả: điểm AIME 2024 lấy một lần (pass@1) tăng từ 15,6% lên 77,9% qua 10.400 bước; bỏ phiếu trên 16 lời giải đạt 86,7%. Độ dài câu trả lời tự tăng lên hàng nghìn token, và mô hình bắt đầu tự xem lại cách làm. Bài báo kể một "khoảnh khắc aha", khi tần suất từ "wait" tăng vọt trong các đoạn tự kiểm tra. Mỗi bước học lấy 16 lời giải cho mỗi câu hỏi, giới hạn 32.768 token, nâng lên 65.536 từ bước thứ 8.200, hệ số KL 0,001. Nhược điểm của R1-Zero là khó đọc và hay trộn tiếng Anh với tiếng Trung trong một đoạn suy nghĩ.
GRPO: so mỗi lời giải với cả nhóm
R1-Zero dùng GRPO (Group Relative Policy Optimization), thuật toán ra đời trong bài DeepSeekMath. PPO trong RLHF cần một mô hình giá trị cỡ ngang mô hình chính để ước lượng mỗi token tốt hơn trung bình bao nhiêu, tốn bộ nhớ, và khó học vì phần thưởng chỉ đến ở token cuối. GRPO bỏ mô hình đó: với mỗi câu hỏi, lấy một nhóm \(G\) lời giải, chấm từng lời giải, rồi dùng chính nhóm làm mốc so sánh:
\[A_i = \frac{r_i - \text{mean}(r_1, \dots, r_G)}{\text{std}(r_1, \dots, r_G)}\]
Hàm mục tiêu giữ phần cắt tỉ số xác suất của PPO, và cộng thẳng một phần phạt KL so với mô hình tham chiếu. KL được ước lượng trên từng mẫu bằng \(t - \log t - 1\) với \(t = \pi_{ref}(o_i \mid q) / \pi_\theta(o_i \mid q)\), một đại lượng không bao giờ âm.
Đoạn code tính lợi thế nhóm, kiểm ước lượng KL, chạy một vòng học tăng cường đồ chơi và tính bỏ phiếu đa số.
"""GRPO trên số nhỏ: lợi thế so trong nhóm, ước lượng KL dùng trong GRPO, một vòng học tăng cường đồ chơi
với phần thưởng kiểm được, và bỏ phiếu đa số khi trả lời.
Chạy: python grpo_mini.py
"""
from math import comb

import numpy as np


def loi_the_nhom(r):
    """A_i = (r_i - trung bình nhóm) / độ lệch chuẩn nhóm. Nhóm toàn đúng hoặc toàn sai: mọi A_i = 0."""
    r = np.asarray(r, dtype=float)
    lech = r.std()
    return np.zeros_like(r) if lech == 0 else (r - r.mean()) / lech


def kl_tung_mau(pi_mau, ref_mau):
    """Ước lượng KL cho từng mẫu: pi_ref/pi - log(pi_ref/pi) - 1 (luôn >= 0)."""
    t = ref_mau / pi_mau
    return t - np.log(t) - 1


def huan_luyen(p_dung, so_buoc=200, G=8, toc_do=0.5, seed=0):
    """Chính sách chọn 1 trong 4 cách giải; chỉ cách 0 cho đáp số đúng (phần thưởng 1), còn lại 0.
    Mỗi bước: lấy G mẫu, tính lợi thế trong nhóm, cập nhật logit theo gradient chính sách."""
    rng = np.random.default_rng(seed)
    theta = np.log(np.array([p_dung] + [(1 - p_dung) / 3] * 3))
    toan_sai, buoc_qua_nua = 0, None
    for buoc in range(1, so_buoc + 1):
        pi = np.exp(theta - theta.max())
        pi /= pi.sum()
        mau = rng.choice(4, size=G, p=pi)
        toan_sai += int((mau != 0).all())
        A = loi_the_nhom((mau == 0).astype(float))
        g = sum(adv * (np.eye(4)[a] - pi) for a, adv in zip(mau, A))  # gradient của log pi(a) theo logit
        theta = theta + toc_do * g / G
        p = np.exp(theta - theta.max())
        if buoc_qua_nua is None and p[0] / p.sum() > 0.5:
            buoc_qua_nua = buoc
    p = np.exp(theta - theta.max())
    return float(p[0] / p.sum()), toan_sai, buoc_qua_nua


def bo_phieu(p, k):
    """Xác suất bỏ phiếu đa số k lời giải ra đáp số đúng, khi mỗi lời giải đúng với xác suất p và mọi lời giải
    sai cùng ra một đáp số (trường hợp xấu nhất cho bỏ phiếu); hòa thì chọn ngẫu nhiên."""
    tong = sum(comb(k, j) * p**j * (1 - p) ** (k - j) for j in range(k // 2 + 1, k + 1))
    if k % 2 == 0:
        tong += 0.5 * comb(k, k // 2) * p ** (k // 2) * (1 - p) ** (k // 2)
    return tong


if __name__ == "__main__":
    print("lợi thế nhóm [1,0,1,0,0,1]:", loi_the_nhom([1, 0, 1, 0, 0, 1]))
    print("lợi thế nhóm toàn sai:", loi_the_nhom([0] * 6))
    pi, ref = np.array([0.5, 0.3, 0.2]), np.array([0.4, 0.4, 0.2])
    mau = np.random.default_rng(1).choice(3, size=100_000, p=pi)
    uoc = kl_tung_mau(pi[mau], ref[mau])
    print(f"KL tính thẳng = {np.sum(pi * np.log(pi / ref)):.4f}, trung bình ước lượng trên mẫu = {uoc.mean():.4f}, "
          f"mẫu nhỏ nhất = {uoc.min():.4f}")
    for p0 in (0.1, 0.001):
        p, ts, nua = huan_luyen(p0)
        print(f"bắt đầu P(đúng) = {p0}: sau 200 bước P(đúng) = {p:.3f}, {ts}/200 nhóm toàn sai, "
              f"P(đúng) vượt 0,5 ở bước {nua if nua else 'không bao giờ'}")
    for k in (1, 5, 16):
        print(f"mỗi lời giải đúng 60%, bỏ phiếu {k} lời giải: đúng {bo_phieu(0.6, k):.1%}")
Nhóm 6 lời giải có 3 đúng cho lợi thế đúng bằng +1 và −1, vì trung bình và độ lệch chuẩn đều là 0,5. Ước lượng KL trung bình trên 100 nghìn mẫu là 0,0252, sát giá trị tính thẳng 0,0253, và không mẫu nào âm. Phần học tăng cường đồ chơi là chỗ đáng xem nhất: chính sách chọn một trong bốn cách giải, chỉ một cách cho đáp số đúng.
| Xác suất đúng lúc đầu | Sau 200 bước | Số nhóm toàn sai | Vượt 50% ở bước |
|---|---|---|---|
| 0,1 | 0,997 | 1/200 | 9 |
| 0,001 | 0,002 | 196/200 | không bao giờ |
Khi mô hình đôi khi làm đúng, vài bước là đủ. Khi gần như không bao giờ đúng, gần như mọi nhóm đều toàn sai, lợi thế bằng 0 và không có gì để học. DeepSeek cũng gặp giới hạn của mô hình gốc ở quy mô thật: họ thử học tăng cường trên một mô hình 7 tỷ tham số và một mô hình 16 tỷ tham số kiểu hỗn hợp chuyên gia (MoE), cả hai đều không cải thiện được điểm AIME; câu trả lời càng dài thì càng hay lặp. Chỉ khi chuyển sang mô hình 32 tỷ, 230 tỷ và 671 tỷ tham số, họ mới thấy cải thiện rõ. Mô hình gốc phải đủ giỏi thì phần thưởng kiểm được mới có tác dụng.
Với DeepSeekMath, GRPO được chạy trên 144 nghìn câu hỏi, 64 lời giải cho mỗi câu, hệ số KL 0,04. Mô hình 7 tỷ tham số tăng từ 82,9% lên 88,2% trên GSM8K và từ 46,8% lên 51,7% trên MATH.
Từ R1-Zero tới DeepSeek-R1
Để sửa chỗ khó đọc, DeepSeek-R1 đi qua nhiều chặng. Đầu tiên là vài nghìn ví dụ suy luận dài viết theo giọng trò chuyện làm dữ liệu khởi động. Chặng học tăng cường thứ nhất thêm phần thưởng nhất quán ngôn ngữ, bằng tỉ lệ từ thuộc ngôn ngữ mục tiêu trong đoạn suy nghĩ; bài báo ghi điều này làm điểm giảm nhẹ nhưng dễ đọc hơn. Sau đó họ lấy mẫu nhiều lời giải, chỉ giữ lời giải đúng, gom khoảng 600 nghìn mẫu suy luận và khoảng 200 nghìn mẫu khác như viết văn, dịch, hỏi đáp để tinh chỉnh lại. Chặng học tăng cường cuối dùng quy tắc cho bài suy luận và mô hình thưởng cho câu hỏi chung; phần thưởng sở thích chỉ được bật trong 400 bước cuối của 1.700 bước, vì học lâu hơn với nó dẫn tới bị lách.
Bản DeepSeek-R1 cuối đạt 79,8% trên AIME 2024, 97,3% trên MATH-500 và hệ số Codeforces 2029 (Bảng 3 của bài báo).
Tính toán lúc trả lời
Mô hình suy luận tiêu nhiều token hơn cho mỗi câu trả lời. Snell và cộng sự (2024) hỏi thẳng: nếu được dùng thêm tính toán lúc trả lời, nên dùng thế nào, và có đáng hơn làm mô hình to hơn không? Thí nghiệm của họ trên mô hình PaLM 2-S* và bộ MATH so hai cách: tìm kiếm có một mô hình chấm từng bước giải, và để mô hình tự sửa lời giải nhiều lần. Cách tốt nhất phụ thuộc độ khó của câu hỏi; chọn cách theo độ khó giúp đạt cùng kết quả với ít hơn khoảng 4 lần tính toán so với lấy N mẫu rồi chọn mẫu tốt nhất. Khi so cùng số FLOPs, mô hình nhỏ dùng thêm tính toán lúc trả lời thắng được mô hình lớn hơn khoảng 14 lần trên các câu mà mô hình nhỏ đã làm đúng được một phần; với các câu khó nhất, tăng tiền huấn luyện vẫn hiệu quả hơn.
Cách đơn giản nhất là bỏ phiếu. Trong code, mỗi lời giải đúng 60% và mọi lời giải sai cùng ra một đáp số, trường hợp xấu nhất cho bỏ phiếu; bỏ phiếu 5 lời giải đúng 68,3%, 16 lời giải đúng 78,7%. R1-Zero cũng vậy: 77,9% khi lấy một lần, 86,7% khi bỏ phiếu 16 lời giải. Cái giá là số token, như phần chi phí trong bài extended thinking đã tính. Khi đọc điểm của mô hình suy luận, để ý cách lấy mẫu: DeepSeek báo pass@1 là trung bình đúng sai của nhiều lời giải ở nhiệt độ 0,6, vì giải mã tham lam làm mô hình hay lặp.
Khi nào cách này không hiệu quả
Ngoài yêu cầu mô hình gốc đủ giỏi, phần thưởng chấm bằng quy tắc chỉ có cho bài có đáp án kiểm được; viết văn hay trả lời câu hỏi mở vẫn cần mô hình thưởng, kèm nguy cơ bị lách. Với mô hình nhỏ, DeepSeek thấy chưng cất từ R1 cho kết quả tốt hơn hẳn tự học tăng cường; bài chưng cất mô hình có số liệu. Cuối cùng là chuyện nhiễm đề: DeepSeek lọc dữ liệu bằng cách tìm các đoạn trùng 10-gram với đề và lời giải mẫu của bài kiểm tra, nhưng tự nhận cách này không chặn được đề bị viết lại; bài benchmark AI là gì bàn kỹ hơn.
- So điểm của mô hình suy luận với mô hình thường mà không xem số lời giải được lấy và cách bỏ phiếu.
- Nghĩ học tăng cường dạy được mọi thứ: nó chỉ khuếch đại những cách giải mô hình gốc đôi khi đã làm đúng.
- Dùng mô hình thưởng bằng mạng nơ-ron cho bài có đáp án kiểm được: dễ bị lách hơn phần thưởng chấm bằng quy tắc.
- Quên chi phí: chuỗi suy nghĩ dài hàng nghìn token cho mỗi câu hỏi.
Câu hỏi thường gặp
GRPO là gì?
Là thuật toán học tăng cường từ bài DeepSeekMath: với mỗi câu hỏi, lấy một nhóm lời giải, chấm từng lời giải rồi so với trung bình nhóm, nên không cần mô hình giá trị như PPO.
Test-time compute là gì?
Là lượng tính toán dùng lúc trả lời: chuỗi suy nghĩ dài hơn, nhiều lời giải để bỏ phiếu, hoặc cho mô hình tự sửa. Nó là trục mở rộng bên cạnh việc làm mô hình to hơn.
Mô hình suy luận khác chatbot thường thế nào?
Nó viết một đoạn suy nghĩ dài, có kiểm tra và sửa, trước khi trả lời, nên giỏi toán và lập trình hơn nhưng chậm và tốn token hơn.
Học sinh có tự thử học tăng cường kiểu này được không?
Được ở quy mô nhỏ: chọn một mô hình mở nhỏ, một tập bài có đáp số, chấm bằng code so đáp số. Hãy đo trước tỉ lệ làm đúng ban đầu; gần 0 thì gần như không học được gì.
Học tiếp
- Extended thinking là gì: bật và dùng chế độ suy nghĩ qua API.
- RLHF là gì: PPO, mô hình thưởng và phạt KL mà GRPO kế thừa.
- Chưng cất mô hình: đưa khả năng suy luận xuống mô hình nhỏ.
Nếu bạn muốn học Python và học máy bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- DeepSeek-AI (2025), DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv 2501.12948v2 ngày 4/1/2026 (PDF, đọc 12/11/2026)
- Shao và cộng sự (2024), DeepSeekMath, mục 4.1 về GRPO, arXiv 2402.03300v3 (PDF, đọc 12/11/2026)
- Snell và cộng sự (2024), Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, arXiv 2408.03314v1 (PDF, đọc 12/11/2026)
- NumPy (thư viện dùng trong code)