- Khi suy nghĩ, mô hình viết phần nháp riêng trước câu trả lời: nêu lại đề, thử hướng giải, kiểm kết quả trung gian, bỏ hướng sai. Điều này giúp nhiều ở toán, lập trình, phân tích.
- Trên các mô hình Claude 5, suy nghĩ đã bật sẵn và mô hình tự quyết có cần nghĩ hay không. Bạn chỉnh mức nghĩ bằng effort, không còn đặt ngân sách token như trước.
- Phần suy nghĩ nằm trong khối thinking đứng trước khối text. Muốn đọc bản tóm tắt suy nghĩ, phải bật display summarized.
- Token suy nghĩ được tính như token đầu ra và nằm trong max_tokens, kể cả khi bạn không thấy chữ nào.
Bài dùng Python và thư viện anthropic; phần chạy thử dùng câu trả lời giả lập nên không cần khóa API. Các nguồn chính là ba trang Thinking, Steering thinking và Effort trong tài liệu Claude, đọc ngày 11/11/2026, cùng bài báo về chain-of-thought của Wei và cộng sự năm 2022.
Vì sao suy nghĩ trước lại giúp
Năm 2022, Wei và cộng sự cho thấy chỉ cần đưa vào câu lệnh vài ví dụ có các bước suy luận trung gian, mô hình lớn giải bài toán đố, bài suy luận thường thức tốt hơn hẳn so với khi chỉ đưa đáp án. Họ gọi cách đó là chain-of-thought, chuỗi suy nghĩ. Lý do trực quan: mỗi token mô hình sinh ra là một bước tính toán; cho mô hình viết ra các bước trung gian là cho nó thêm "chỗ để tính" trước khi chốt đáp án.
Chế độ suy nghĩ đưa ý tưởng đó vào thẳng mô hình. Trang Thinking của Claude mô tả: khi suy nghĩ đang bật, mô hình làm bài bằng lời của chính nó trước khi trả lời, nêu lại câu hỏi, thử các cách, kiểm kết quả giữa chừng và bỏ những hướng không đứng vững. Phần đó nằm trong các khối thinking đứng trước câu trả lời, và mô hình dựa vào đó để viết câu trả lời cuối. Tài liệu nêu rõ lợi ích lớn nhất ở toán, lập trình, phân tích và các tác vụ dài, nơi chất lượng câu trả lời phụ thuộc vào phần làm nháp.
Trên API Claude hiện nay
Cách bật đã thay đổi qua các đời mô hình, nên nhiều bài hướng dẫn cũ không còn đúng. Ngày trước, bạn bật bằng kiểu "enabled" kèm một ngân sách token cố định cho phần suy nghĩ. Bảng cấu hình trong tài liệu hiện nay cho thấy: trên Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 và các mô hình Claude 5 khác, không gửi trường thinking thì suy nghĩ thích ứng (adaptive) đã chạy sẵn, còn gửi kiểu "enabled" kèm ngân sách token thì bị lỗi 400.
"Thích ứng" nghĩa là mô hình tự quyết cho từng yêu cầu. Trang Steering thinking viết rằng câu hỏi tra cứu đơn giản có thể được trả lời thẳng, không có khối thinking nào, còn bài toán nhiều bước hay lỗi khó sẽ được nghĩ sâu hơn. Vì vậy tài liệu dặn đừng viết code giả định lượt trả lời nào cũng mở đầu bằng khối thinking.
Cần điều chỉnh thì dùng effort, đặt trong output_config. Theo bảng trong tài liệu, mức low hạn chế suy nghĩ và bỏ qua với việc đơn giản; medium nghĩ vừa phải và là mặc định trên Claude Opus 5.5 và Haiku 5.5; high là mặc định trên phần lớn mô hình; xhigh và max nghĩ sâu nhất. Tài liệu nhấn mạnh effort là gợi ý mềm, không mức nào bảo đảm có khối thinking ở mọi yêu cầu. Muốn mô hình nghĩ ít đi, tài liệu khuyên hạ effort trước rồi mới tính đến việc dặn trong câu lệnh; với Sonnet 5.5 và Haiku 5.5, dặn trong câu lệnh không làm giảm suy nghĩ một cách đáng tin.
Đọc phần suy nghĩ
Bạn không bao giờ nhận được nguyên văn chuỗi suy nghĩ. Tài liệu nói chữ trong khối thinking là bản tóm tắt, do một mô hình khác viết. Trường display quyết định có trả bản tóm tắt đó không: summarized thì có; omitted thì khối thinking vẫn có mặt nhưng trường chữ để trống. Trên các mô hình Claude 5, mặc định là omitted, nên muốn xem phải bật summarized. Để ẩn đi cũng có lợi: khi truyền dần, chữ của câu trả lời đến sớm hơn vì máy chủ bỏ qua phần suy nghĩ.
Mỗi khối thinking có một trường chữ ký, là bản mã hóa của toàn bộ suy nghĩ. Trong hội thoại nhiều lượt hoặc khi dùng công cụ, hãy đưa nguyên các khối này trở lại lịch sử, không sửa, không xóa. Tài liệu cũng lưu ý một điều với các mô hình mới: muốn xem lập luận thì đọc khối thinking, đừng ra lệnh cho mô hình chép suy nghĩ vào câu trả lời; yêu cầu kiểu đó có thể bị từ chối.
Ví dụ bằng Python
Chương trình mẫu có ba hàm. Hàm tao_yeu_cau dựng tham số cho lệnh gọi: kiểu adaptive, bật display summarized, mức effort, max_tokens đủ lớn. Hàm doc_tra_loi tách bản tóm tắt suy nghĩ và câu trả lời, ghi chú các tình huống đáng để ý, và đọc số token suy nghĩ trong usage. Hàm noi_luot đưa nguyên nội dung trả lời vào lịch sử. Phần chạy thử dùng ba câu trả lời giả lập.
"""Cho Claude suy nghĩ trước khi trả lời (thinking): tạo yêu cầu, đọc khối thinking và text, xem token suy nghĩ bị tính tiền.

- tao_yeu_cau: thinking kiểu "adaptive" (mô hình tự quyết có nghĩ hay không), display "summarized" để thấy bản tóm tắt;
  mức effort đặt ở output_config. Không gửi budget_tokens: các mô hình Claude 5 trả lỗi 400 với kiểu "enabled" + budget_tokens.
- doc_tra_loi: tách phần tóm tắt suy nghĩ và câu trả lời; báo khi không có khối thinking hoặc bị cắt vì max_tokens;
  đọc usage.output_tokens_details.thinking_tokens (token suy nghĩ thật, tính như token đầu ra).
- noi_luot: đưa nguyên nội dung trả lời (kể cả khối thinking) vào lịch sử, không sửa.
Chạy thử dùng câu trả lời giả lập; số token 348/312 lấy theo ví dụ trong tài liệu Claude, các số khác do bài tự đặt, không phải số đo.
"""
import os
import sys
from types import SimpleNamespace as NS

MO_HINH = "claude-opus-5-5"


def tao_yeu_cau(cau_hoi, effort="medium", hien_suy_nghi=True, max_tokens=16000):
    thinking = {"type": "adaptive"}
    if hien_suy_nghi:
        thinking["display"] = "summarized"
    return {"model": MO_HINH, "max_tokens": max_tokens, "thinking": thinking,
            "output_config": {"effort": effort}, "messages": [{"role": "user", "content": cau_hoi}]}


def doc_tra_loi(tl):
    suy_nghi = [k.thinking for k in tl.content if k.type == "thinking"]
    tra_loi = "".join(k.text for k in tl.content if k.type == "text")
    ghi_chu = []
    if not suy_nghi:
        ghi_chu.append("không có khối thinking: mô hình thấy câu này không cần nghĩ")
    elif not any(suy_nghi):
        ghi_chu.append("có khối thinking nhưng rỗng: display đang là omitted")
    if tl.stop_reason == "max_tokens":
        ghi_chu.append("bị cắt vì max_tokens: tăng max_tokens hoặc hạ effort")
    chi_tiet = getattr(tl.usage, "output_tokens_details", None)
    nghi = getattr(chi_tiet, "thinking_tokens", 0) if chi_tiet else 0
    return {"tom_tat_suy_nghi": " ".join(s for s in suy_nghi if s), "tra_loi": tra_loi, "ghi_chu": ghi_chu,
            "token_ra": tl.usage.output_tokens, "token_suy_nghi": nghi, "token_con_lai": tl.usage.output_tokens - nghi}


def noi_luot(lich_su, tl, cau_tiep):
    return lich_su + [{"role": "assistant", "content": tl.content}, {"role": "user", "content": cau_tiep}]


def _gia(noi_dung, stop="end_turn", ra=0, nghi=None):
    usage = NS(output_tokens=ra, output_tokens_details=NS(thinking_tokens=nghi) if nghi is not None else None)
    return NS(content=noi_dung, stop_reason=stop, usage=usage)


def chay_thu():
    vi_du = {
        "Câu khó": _gia([NS(type="thinking", thinking="Dùng thuật toán Euclid: 1071 = 2*462 + 147, 462 = 3*147 + 21, 147 = 7*21.", signature="..."),
                         NS(type="text", text="ƯCLN(1071, 462) = 21.")], ra=348, nghi=312),
        "Câu dễ": _gia([NS(type="text", text="Thủ đô của Việt Nam là Hà Nội.")], ra=12, nghi=0),
        "Bị cắt": _gia([NS(type="thinking", thinking="", signature="..."), NS(type="text", text="Bước 1: ")], stop="max_tokens", ra=1024, nghi=1019),
    }
    dong = []
    for ten, tl in vi_du.items():
        kq = doc_tra_loi(tl)
        dong.append(f"{ten}: trả lời '{kq['tra_loi']}', token ra {kq['token_ra']} (suy nghĩ {kq['token_suy_nghi']}, còn lại {kq['token_con_lai']})")
        dong += [f"  - {g}" for g in kq["ghi_chu"]]
    yc = tao_yeu_cau("ƯCLN của 1071 và 462 là bao nhiêu?")
    dong.append(f"Yêu cầu gửi: thinking={yc['thinking']}, effort={yc['output_config']['effort']}, max_tokens={yc['max_tokens']}")
    ls = noi_luot(yc["messages"], vi_du["Câu khó"], "Còn ƯCLN của 21 và 14?")
    dong.append(f"Lịch sử sau một lượt: {len(ls)} tin, khối đầu của trợ lý là '{ls[1]['content'][0].type}'")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    if "--that" in sys.argv:
        if not os.environ.get("ANTHROPIC_API_KEY"):
            sys.exit("Chưa có ANTHROPIC_API_KEY")
        import anthropic
        try:
            tl = anthropic.Anthropic().messages.create(**tao_yeu_cau("ƯCLN của 1071 và 462 là bao nhiêu?"))
        except anthropic.APIConnectionError:
            sys.exit("Không kết nối được tới API")
        print(doc_tra_loi(tl))
    else:
        chay_thu()
Câu trả lời giả lập thứ nhất dùng đúng con số trong ví dụ của tài liệu: 348 token đầu ra, trong đó 312 token là suy nghĩ, chỉ 36 token là phần chữ bạn thấy. Câu thứ hai là câu tra cứu đơn giản, không có khối thinking, và hàm đọc ghi chú điều đó thay vì báo lỗi. Câu thứ ba có khối thinking rỗng vì display là omitted, và bị cắt vì chạm max_tokens; hàm gợi ý hai cách sửa mà tài liệu nêu: tăng max_tokens nếu câu khó thật sự cần suy nghĩ, hoặc hạ effort nếu mô hình đang nghĩ quá tay. Dòng cuối cho thấy sau một lượt, khối đầu tiên của lượt trợ lý trong lịch sử vẫn là khối thinking, giữ nguyên như khi nhận về.
Cái giá của suy nghĩ
Trang Steering thinking ghi rằng token suy nghĩ được tính như token đầu ra, và số token bị tính không khớp với số chữ bạn thấy: bạn trả cho toàn bộ quá trình suy nghĩ, không phải bản tóm tắt. Chọn omitted giảm độ trễ chứ không giảm chi phí. Token suy nghĩ cũng tính vào max_tokens cùng phần trả lời, nên một max_tokens vừa đủ cho câu trả lời ngắn có thể quá nhỏ khi mô hình bắt đầu nghĩ.
Không phải việc nào cũng đáng để mô hình nghĩ sâu. Phân loại nhãn, trích thông tin, viết lại câu văn thường không cần mức effort cao. Bài định tuyến mô hình bàn cách cho câu dễ đi đường rẻ, câu khó đi đường mạnh; effort là thêm một nút chỉnh trong cùng tinh thần đó. Hãy đo trên bộ câu hỏi của chính bạn: chạy với hai mức effort, so chất lượng, độ trễ và số token đầu ra, rồi chọn mức thấp nhất vẫn đạt yêu cầu. Cách đếm token trước khi gửi có trong bài đếm token khi gọi API.
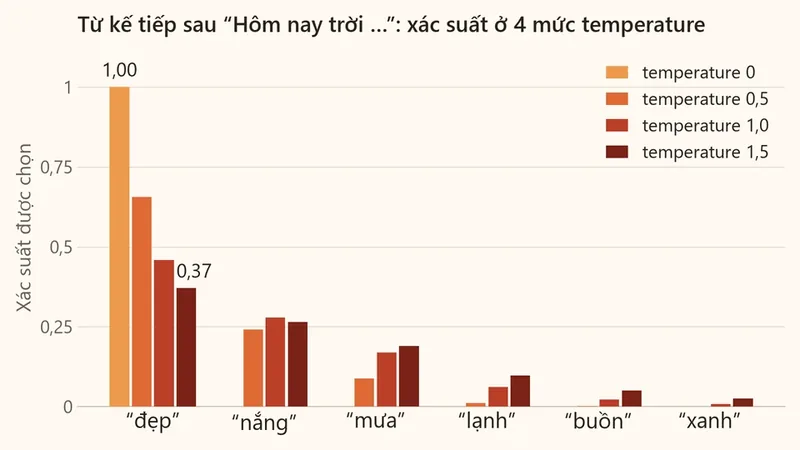
Một điểm nữa: trước đây người ta thường hạ temperature để câu trả lời ổn định, nhưng như bài temperature là gì đã nói, các mô hình Claude mới không nhận giá trị khác mặc định. Với bài toán cần đúng, việc cho mô hình suy nghĩ và tự kiểm thường có ích hơn nhiều.
- Gửi kiểu "enabled" kèm ngân sách token tới mô hình Claude 5 theo bài hướng dẫn cũ.
- Viết code giả định lượt nào cũng có khối thinking.
- Đặt max_tokens quá nhỏ rồi thấy câu trả lời bị cắt.
- Sửa hay bỏ khối thinking khi gửi lại lịch sử hội thoại.
- Dùng effort cao cho mọi việc mà không đo.
Câu hỏi thường gặp
Suy nghĩ có làm câu trả lời luôn đúng không?
Không. Nó giúp nhiều ở bài nhiều bước, nhưng kết quả quan trọng vẫn cần kiểm.
Tắt suy nghĩ được không?
Tùy mô hình. Bảng trong tài liệu cho biết mô hình nào nhận kiểu disabled; Opus 5.5 thì không.
Vì sao số token đầu ra lớn hơn chữ tôi thấy?
Vì bạn trả cho toàn bộ suy nghĩ, còn chữ hiện ra chỉ là bản tóm tắt hoặc không có.
Extended thinking với adaptive thinking khác gì?
Extended thinking cũ dùng ngân sách token cố định; adaptive để mô hình tự quyết, chỉnh bằng effort.
Học tiếp
- Vì sao temperature không còn là nút chỉnh: temperature là gì.
- Cho câu dễ đi đường rẻ: định tuyến mô hình.
- Đếm token trước khi gửi: đếm token khi gọi API.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.