- RLHF gồm ba bước: tinh chỉnh có giám sát (SFT) trên câu mẫu do người viết, học một mô hình thưởng từ các xếp hạng của người, rồi tối ưu mô hình ngôn ngữ bằng PPO theo điểm của mô hình thưởng.
- Mô hình thưởng học từ so sánh theo mô hình Bradley-Terry: hiệu điểm thưởng của hai câu là log của tỉ lệ cược người chọn câu này thay vì câu kia.
- Phần phạt KL giữ mô hình gần bản SFT, để nó không "lách" những chỗ mô hình thưởng chấm sai.
- Trong bài InstructGPT, bản 1,3 tỷ tham số sau RLHF được người chấm ưa hơn GPT-3 175 tỷ tham số, dù nhỏ hơn hơn 100 lần.
Code trong bài là Python 3 dùng numpy (máy viết bài dùng numpy 2.5.4). Số liệu lấy từ bản PDF của các bài báo trên arXiv, đọc ngày 12/11/2026. Bài giả định bạn đã biết ý tưởng chung của học tăng cường (tác tử, hành động, phần thưởng) như trong bài học tăng cường và Q-learning.
RLHF là gì và vì sao cần
Một mô hình ngôn ngữ vừa tiền huấn luyện chỉ học đoán token kế tiếp trên trang web. Bài báo InstructGPT gọi mục tiêu đó là lệch (misaligned) so với điều người dùng muốn: làm theo yêu cầu một cách hữu ích và an toàn. Mô hình có thể bịa chuyện, viết lời độc hại hoặc đơn giản là không làm đúng việc được giao. Viết ra một hàm thưởng bằng tay cho "câu trả lời tốt" thì gần như không thể. RLHF đi đường khác: hỏi con người câu nào tốt hơn, rồi học hàm thưởng từ các câu trả lời đó.
Ý tưởng này có từ bài của Christiano và cộng sự năm 2017. Họ cho người xem hai đoạn video dài 1 đến 2 giây của một tác tử trong trò chơi Atari hoặc mô phỏng robot MuJoCo, rồi chọn đoạn tốt hơn. Từ các lựa chọn đó, một mạng nơ-ron học ra hàm thưởng, và tác tử được huấn luyện theo hàm thưởng học được. Người chỉ phải cho phản hồi trên chưa tới 1% số tương tác của tác tử. Robot Hopper học nhào lộn ngược chỉ với 900 lần hỏi, trong chưa tới một giờ, một hành vi mà rất khó viết hàm thưởng bằng tay. Bài báo còn ghi một chi tiết quan trọng: hỏi người liên tục trong lúc huấn luyện giúp tác tử không khai thác được điểm yếu của hàm thưởng học được.
Ba bước của InstructGPT
InstructGPT áp dụng ý tưởng đó cho GPT-3. OpenAI thuê khoảng 40 người gán nhãn qua Upwork và ScaleAI, chọn qua một bài kiểm tra đầu vào.
Bước 1 là tinh chỉnh có giám sát (supervised fine-tuning, SFT). Người gán nhãn viết câu trả lời mẫu cho khoảng 13 nghìn prompt, và GPT-3 được tinh chỉnh trên đó. Nhóm tác giả thấy mô hình SFT bắt đầu quá khớp trên tập kiểm định chỉ sau 1 vòng, nhưng huấn luyện tiếp tới 16 vòng vẫn làm điểm thưởng và đánh giá của người tốt lên.
Bước 2 là học mô hình thưởng (reward model, RM). Với mỗi prompt, người gán nhãn xếp hạng từ 4 đến 9 câu trả lời của mô hình; tập này có 33 nghìn prompt. Mô hình thưởng là mô hình SFT bỏ lớp đầu ra, thay bằng một đầu ra là một số thực. Họ chỉ dùng mô hình thưởng 6 tỷ tham số, vừa để tiết kiệm tính toán, vừa vì bản 175 tỷ huấn luyện có thể không ổn định.
Bước 3 là học tăng cường bằng PPO trên 31 nghìn prompt lấy từ API. Mỗi lượt là một bài toán "một bước": nhận một prompt, sinh một câu trả lời, nhận điểm của mô hình thưởng, kết thúc.
Mô hình thưởng học từ so sánh
Người chấm không cho điểm tuyệt đối mà chỉ so hai câu. Mô hình Bradley-Terry nối hai thứ đó: xác suất người chọn câu \(y_w\) thay vì \(y_l\) là \(\sigma(r_w - r_l)\), với \(\sigma\) là hàm sigmoid và \(r\) là điểm thưởng. Christiano so sánh cách này với hệ số Elo trong cờ vua: hiệu điểm Elo của hai kỳ thủ cho biết xác suất người này thắng người kia. Mỗi xếp hạng \(K\) câu cho \(\binom{K}{2}\) cặp, và mất mát của InstructGPT (phương trình 1) là:
\[\text{loss}(\theta) = -\frac{1}{\binom{K}{2}}\,\mathbb{E}\big[\log \sigma(\Delta)\big]\]
với \(\Delta = r_\theta(x, y_w) - r_\theta(x, y_l)\). Chi tiết nhỏ mà quan trọng: các cặp từ cùng một xếp hạng tương quan rất mạnh. Trộn chúng thành các điểm dữ liệu riêng thì mô hình thưởng quá khớp ngay sau một lượt; InstructGPT gom cả \(\binom{K}{2}\) cặp của một prompt vào cùng một phần tử của lô, vừa hết quá khớp vừa chỉ cần chạy mô hình một lần cho mỗi câu trả lời.
Đoạn code dưới học điểm thưởng cho 4 câu A, B, C, D từ xếp hạng của 5 người, bằng hạ gradient trên đúng hàm mất mát trên. Phần thứ hai và thứ ba của code dùng ở mục sau.
"""Ba mảnh của RLHF trên số nhỏ: mô hình thưởng học từ xếp hạng, phần thưởng có phạt KL, hàm mục tiêu cắt của PPO.
Chạy: python rlhf_mini.py
"""
from itertools import combinations

import numpy as np

# 1. Mô hình thưởng: 5 người xếp hạng 4 câu trả lời A, B, C, D cho cùng một prompt.
#    Mỗi xếp hạng K = 4 câu sinh ra C(4, 2) = 6 cặp (câu thắng, câu thua).
XEP_HANG = ["ABCD", "ABCD", "ABCD", "BADC", "CABD"]
TEN = "ABCD"


def cac_cap(xep_hang):
    cap = []
    for xh in xep_hang:
        for i, j in combinations(range(len(xh)), 2):  # xh[i] đứng trước xh[j] nên thắng
            cap.append((TEN.index(xh[i]), TEN.index(xh[j])))
    return np.array(cap)


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def hoc_diem_thuong(cap, so_buoc=5000, toc_do=0.5):
    """Hạ gradient trên mất mát -mean(log sigmoid(r_thắng - r_thua)) (phương trình 1 của InstructGPT)."""
    r = np.zeros(len(TEN))
    for _ in range(so_buoc):
        p = sigmoid(r[cap[:, 0]] - r[cap[:, 1]])  # xác suất mô hình cho rằng câu thắng tốt hơn
        g = np.zeros_like(r)
        np.add.at(g, cap[:, 0], -(1 - p))
        np.add.at(g, cap[:, 1], 1 - p)
        r -= toc_do * g / len(cap)
    return r - r.mean()  # mất mát không đổi khi cộng cùng một hằng số, nên dời về trung bình 0


def mat_mat(r, cap):
    return float(-np.mean(np.log(sigmoid(r[cap[:, 0]] - r[cap[:, 1]]))))


# 2. Phần thưởng dùng khi chạy PPO: điểm mô hình thưởng trừ phạt KL so với mô hình SFT (beta = 0,02 như InstructGPT).
def thuong_co_phat(diem_rm, tong_log_ti_so, beta=0.02):
    return diem_rm - beta * tong_log_ti_so


# 3. Hàm mục tiêu cắt của PPO cho một bước: min(r*A, clip(r, 1 - eps, 1 + eps)*A).
def ppo_cat(ti_so, loi_the, eps=0.2):
    return min(ti_so * loi_the, float(np.clip(ti_so, 1 - eps, 1 + eps)) * loi_the)


if __name__ == "__main__":
    cap = cac_cap(XEP_HANG)
    r = hoc_diem_thuong(cap)
    print(f"{len(cap)} cặp so sánh; điểm thưởng: " + ", ".join(f"{t} = {v:+.2f}" for t, v in zip(TEN, r)))
    print(f"mất mát lúc đầu = {mat_mat(np.zeros(4), cap):.4f}, sau khi học = {mat_mat(r, cap):.4f}")
    print(f"P(A tốt hơn B) = {sigmoid(r[0] - r[1]):.2f}")
    for ten, diem, lech in [("câu bám sát SFT", 1.0, 5.0), ("câu lệch xa SFT", 1.5, 40.0)]:
        print(f"{ten}: điểm RM = {diem}, tổng log tỉ số = {lech}, phần thưởng sau phạt = {thuong_co_phat(diem, lech):.2f}")
    for ti_so, A in [(1.5, 1.0), (0.7, 1.0), (0.5, -1.0), (1.3, -1.0)]:
        print(f"tỉ số {ti_so}, lợi thế {A:+.0f}: mục tiêu PPO = {ppo_cat(ti_so, A):+.2f}")
Năm xếp hạng cho 30 cặp. Điểm học được là A = +1,78, B = +0,82, C = −0,38, D = −2,22, và mất mát giảm từ ln 2 ≈ 0,6931 (đoán bừa) xuống 0,3568. Mô hình cho rằng A tốt hơn B với xác suất 0,72, dù trong dữ liệu A thắng B 4 trên 5 lần: điểm thưởng dùng chung cho mọi cặp, nên mỗi cặp không được khớp riêng. Vì hàm mất mát không đổi khi cộng cùng một hằng số vào mọi điểm, code dời điểm về trung bình 0; InstructGPT cũng chuẩn hóa để câu mẫu của người có điểm trung bình 0 trước khi chạy PPO.
Mô hình thưởng không đoán đúng mọi lần. Trong InstructGPT, người gán nhãn đồng ý với nhau 72,6 ± 1,5% số lần. Mô hình thưởng đoán đúng lựa chọn của nhóm người đã cho dữ liệu 72,4 ± 0,4% số lần, và của một nhóm người khác 69,6 ± 0,9%.
PPO và phần phạt KL
Nếu chỉ tối đa hóa điểm thưởng, mô hình sẽ tìm ra những câu mà mô hình thưởng chấm cao nhầm. InstructGPT thêm phạt KL theo từng token so với mô hình SFT để giảm việc "tối ưu quá tay" (over-optimization) mô hình thưởng. Phần thưởng dùng khi huấn luyện là:
\[R(x, y) = r_\theta(x, y) - \beta \log \frac{\pi^{RL}(y \mid x)}{\pi^{SFT}(y \mid x)}\]
với \(\beta = 0{,}02\) trong bài báo. Biến thể PPO-ptx còn cộng thêm một phần giữ khả năng mô hình hóa dữ liệu tiền huấn luyện:
\[\begin{aligned} J &= \mathbb{E}\big[R(x, y)\big] \\ &\quad + \gamma\, \mathbb{E}_{x \sim D_{pre}}\big[\log \pi^{RL}(x)\big] \end{aligned}\]
Trong code, câu bám sát SFT có điểm thưởng 1,0 và tổng log tỉ số xác suất là 5, nên phần thưởng còn 0,90. Câu lệch xa có điểm 1,5 nhưng tổng log tỉ số là 40, nên chỉ còn 0,70: phạt KL lật ngược thứ tự của mô hình thưởng.
PPO cập nhật mô hình bằng hàm mục tiêu cắt. Gọi \(r_t\) là tỉ số giữa xác suất mô hình mới và mô hình cũ chọn token \(t\), \(\hat{A}_t\) là lợi thế (advantage), tức token đó tốt hơn mức trung bình bao nhiêu:
\[\begin{aligned} &L^{CLIP} = \hat{\mathbb{E}}_t \big[ \min \big( r_t \hat{A}_t, \\ &\quad \text{clip}(r_t, 1-\epsilon, 1+\epsilon)\, \hat{A}_t \big) \big] \end{aligned}\]
Bài PPO đề xuất \(\epsilon = 0{,}2\). Bảng 4 dòng cuối của code cho thấy cách cắt hoạt động:
| Tỉ số mới/cũ | Lợi thế | Mục tiêu PPO | Vì sao |
|---|---|---|---|
| 1,5 | +1 | +1,20 | lợi rồi, không thưởng thêm khi vượt 1,2 |
| 0,7 | +1 | +0,70 | chưa cắt, vẫn được kéo lên |
| 0,5 | −1 | −0,80 | đã giảm đủ, không thưởng thêm khi xuống dưới 0,8 |
| 1,3 | −1 | −1,30 | đi sai hướng, phạt đầy đủ |
Bài báo diễn đạt ngắn: chỉ bỏ qua thay đổi tỉ số khi nó làm mục tiêu đẹp lên, còn khi nó làm mục tiêu xấu đi thì giữ nguyên. Trên 7 bài mô phỏng robot, bản cắt với \(\epsilon = 0{,}2\) đạt điểm chuẩn hóa trung bình 0,82, còn bản không cắt cũng không phạt chỉ được −0,39.
Kết quả và cái giá
Người chấm ưa câu trả lời của InstructGPT 175 tỷ hơn GPT-3 175 tỷ trong 85 ± 3% số lần, và hơn GPT-3 có prompt kèm ví dụ trong 71 ± 4% số lần. Trên các việc phải bám vào văn bản cho sẵn như tóm tắt, InstructGPT bịa thông tin trong 21% câu trả lời, so với 41% của GPT-3. Khi được dặn trả lời lịch sự, nó sinh ít hơn khoảng 25% câu độc hại, nhưng không ít thiên kiến hơn trên các bài đo Winogender và CrowS-Pairs.
Cái giá có hai phần. Một là "thuế căn chỉnh" (alignment tax): điểm trên vài bài đo công khai như SQuAD, DROP, HellaSwag giảm; trộn thêm gradient tiền huấn luyện (PPO-ptx) bù lại phần lớn. Hai là tính toán: huấn luyện bản PPO-ptx 175 tỷ tốn 60 petaflop/s-ngày, so với 3.640 của GPT-3, nên căn chỉnh rẻ hơn nhiều so với làm mô hình to hơn. Bài báo cũng thẳng thắn: RLHF căn mô hình theo sở thích của một nhóm người cụ thể, chủ yếu là người gán nhãn và nhóm nghiên cứu, chứ không phải "giá trị của nhân loại" nói chung.
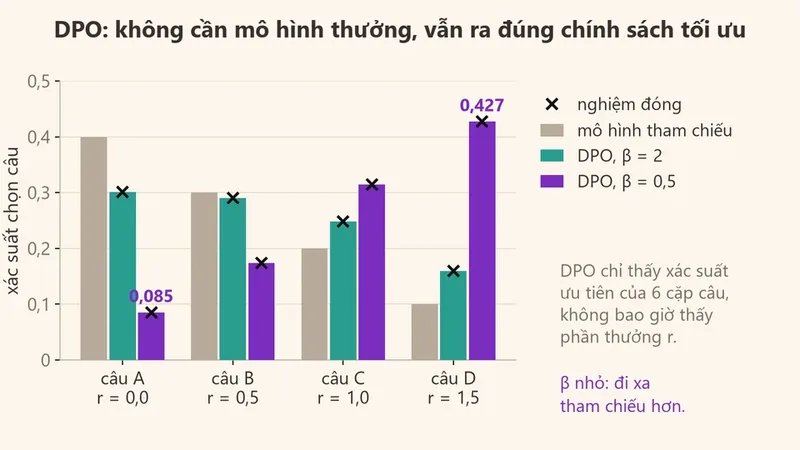
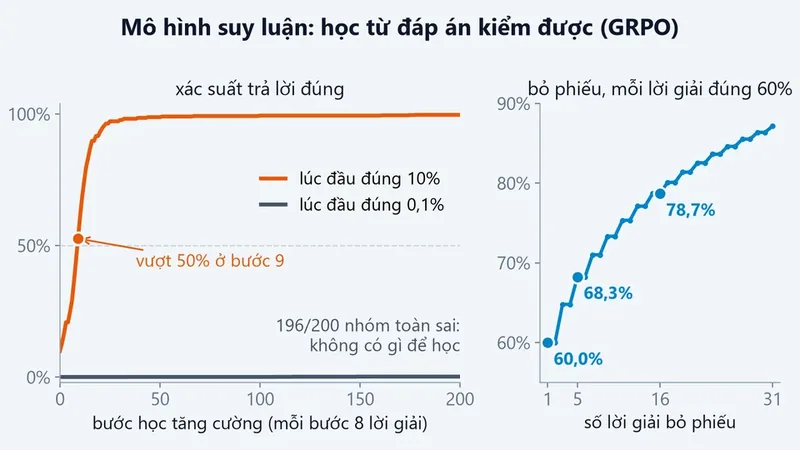
Một hệ thống PPO như vậy phải giữ bốn mô hình trong bộ nhớ: mô hình đang học, mô hình SFT để tính KL, mô hình thưởng, và mô hình giá trị (value function, khởi tạo từ mô hình thưởng). Đó là động lực cho hai hướng đơn giản hơn: DPO bỏ hẳn mô hình thưởng, còn GRPO trong mô hình suy luận bỏ mô hình giá trị và chấm bằng đáp án kiểm được.
- Nghĩ mô hình thưởng là "sự thật": nó chỉ đúng khoảng 70% số lần so với người, và sai nhiều hơn ở những câu khác xa dữ liệu nó từng thấy.
- Bỏ phạt KL để điểm thưởng tăng nhanh: điểm tăng nhưng câu trả lời có thể tệ đi trong mắt người.
- Trộn các cặp so sánh của cùng một xếp hạng thành dữ liệu rời: mô hình thưởng quá khớp rất nhanh.
- Quên rằng RLHF căn theo sở thích của một nhóm người gán nhãn cụ thể.
Câu hỏi thường gặp
RLHF dùng để làm gì?
Để dạy mô hình ngôn ngữ làm theo yêu cầu theo cách con người thấy hữu ích, trung thực và vô hại, những điều khó viết thành một hàm thưởng bằng tay.
Reward model là gì?
Là mô hình nhận một prompt và một câu trả lời, trả về một số thực; nó học từ các cặp so sánh của người để câu được chọn có điểm cao hơn câu bị loại.
Vì sao không dùng thẳng điểm của người làm phần thưởng?
Vì học tăng cường cần rất nhiều lượt chấm: InstructGPT chạy PPO qua 256 nghìn lượt. Người chỉ chấm một phần nhỏ, mô hình thưởng học lại cách chấm và chấm thay ở quy mô lớn.
RLHF có còn được dùng không?
Có, nhưng thường kết hợp với các cách mới hơn như DPO hoặc học tăng cường với đáp án kiểm được; mỗi cách có ưu nhược riêng.
Học tiếp
- DPO là gì: học thẳng từ cặp so sánh, không cần mô hình thưởng.
- Mô hình suy luận: học tăng cường với phần thưởng kiểm được và GRPO.
- 10 bài báo AI kinh điển: đặt InstructGPT cạnh GPT-3 và Transformer.
Nếu bạn muốn học Python và học máy bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Ouyang và cộng sự (2022), Training language models to follow instructions with human feedback (InstructGPT), arXiv 2203.02155v1 (PDF, đọc 12/11/2026)
- Christiano và cộng sự (2017), Deep Reinforcement Learning from Human Preferences, arXiv 1706.03741v4 (PDF, đọc 12/11/2026)
- Schulman và cộng sự (2017), Proximal Policy Optimization Algorithms, arXiv 1707.06347v2 (PDF, đọc 12/11/2026)
- NumPy (thư viện dùng trong code)