- DPO giải cùng bài toán với RLHF: tối đa phần thưởng nhưng không đi quá xa mô hình tham chiếu. Khác ở chỗ nó không học mô hình thưởng và không chạy PPO.
- Mấu chốt là bài toán RLHF có nghiệm đóng. Đảo ngược nghiệm đó, phần thưởng được viết bằng chính mô hình ngôn ngữ, và hằng số chuẩn hóa khó tính tự triệt tiêu.
- Hàm mất mát DPO là một bài toán phân loại trên cặp (câu được chọn, câu bị loại), với "phần thưởng ngầm" bằng
βnhân log tỉ số xác suất so với mô hình tham chiếu. - Trong bài báo, DPO thắng bản tóm tắt mẫu của tập TL;DR khoảng 61% số lần, so với 57% của PPO, và ít nhạy với nhiệt độ lấy mẫu hơn.
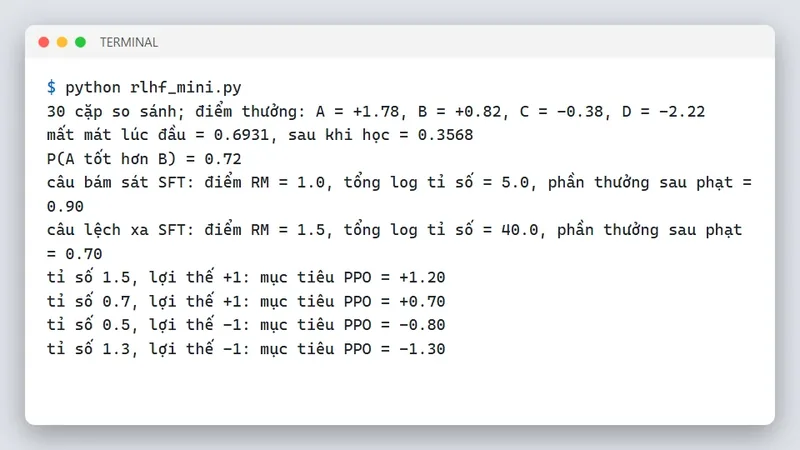
Code trong bài là Python 3 dùng numpy (máy viết bài dùng numpy 2.5.4). Số liệu lấy từ bản PDF của bài báo DPO trên arXiv (bản v3), đọc ngày 12/11/2026. Bài RLHF là gì giải thích mô hình thưởng, PPO và phạt KL; ở đây chỉ dùng lại kết quả.
DPO là gì
Bài Direct Preference Optimization của Rafailov và cộng sự ở Stanford (2023) mở đầu bằng một nhận xét: RLHF phức tạp và hay mất ổn định. Phải học một mô hình thưởng, rồi chạy học tăng cường, liên tục lấy mẫu câu trả lời từ mô hình trong lúc huấn luyện để chấm. Nhóm tác giả cho thấy có thể bỏ cả hai bước đó. Thay vào là một hàm mất mát giống phân loại nhị phân, học thẳng trên các cặp câu trả lời mà người đã chọn, giống hệt dữ liệu dùng để học mô hình thưởng.
Tên phụ của bài báo nói lên ý chính: mô hình ngôn ngữ của bạn thực ra là một mô hình thưởng. Mỗi mô hình ngôn ngữ, so với một mô hình tham chiếu cố định, ngầm định nghĩa một phần thưởng; DPO huấn luyện mô hình sao cho phần thưởng ngầm đó khớp với lựa chọn của người.
Từ bài toán RLHF tới nghiệm đóng
RLHF tối ưu phần thưởng \(r\) trừ phạt KL so với mô hình tham chiếu \(\pi_{ref}\), thường là mô hình SFT (phương trình 3 của bài báo):
\[\begin{aligned} \max_{\pi_\theta}\ &\mathbb{E}_{x,\, y \sim \pi_\theta}\big[r(x, y)\big] \\ &- \beta\, \mathbb{D}_{KL}\big[\pi_\theta \,\|\, \pi_{ref}\big] \end{aligned}\]
Bài toán này có nghiệm đóng, một kết quả đã biết từ các công trình trước (phương trình 4):
\[\pi_r(y \mid x) = \frac{\pi_{ref}(y \mid x)\, e^{r(x, y)/\beta}}{Z(x)}\]
với \(Z(x)\) là tổng của tử số trên mọi câu trả lời có thể. Ý nghĩa dễ thấy: nghiệm tối ưu giữ nguyên mô hình tham chiếu rồi nhân thêm trọng số \(e^{r/\beta}\); \(\beta\) nhỏ thì phần thưởng lấn át, \(\beta\) lớn thì nghiệm bám sát \(\pi_{ref}\). Cái khó là \(Z(x)\) cộng trên mọi câu có thể viết ra, không tính nổi. Lấy log hai vế và chuyển vế, phần thưởng được viết qua chính chính sách (phương trình 5):
\[\begin{aligned} r(x, y) &= \beta \log \frac{\pi_r(y \mid x)}{\pi_{ref}(y \mid x)} \\ &\quad + \beta \log Z(x) \end{aligned}\]
Mô hình Bradley-Terry chỉ dùng hiệu phần thưởng của hai câu cho cùng một prompt, nên khi thay vào, hai số hạng \(\beta \log Z(x)\) trừ nhau và biến mất. Xác suất người chọn \(y_1\) thay vì \(y_2\) giờ chỉ còn phụ thuộc vào chính sách tối ưu và mô hình tham chiếu (phương trình 6). Không còn gì phải ước lượng ngoài chính mô hình ngôn ngữ.
Hàm mất mát và gradient của DPO
Đặt phần thưởng ngầm \(\hat{r}_\theta(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{ref}(y \mid x)}\). Hàm mất mát DPO (phương trình 7) là entropy chéo nhị phân trên cặp \((y_w, y_l)\) với \(y_w\) là câu được chọn:
\[\begin{aligned} &\mathcal{L}_{DPO} = -\mathbb{E}\Big[\log \sigma\Big( \\ &\quad \beta \log \frac{\pi_\theta(y_w \mid x)}{\pi_{ref}(y_w \mid x)} \\ &\quad - \beta \log \frac{\pi_\theta(y_l \mid x)}{\pi_{ref}(y_l \mid x)}\Big)\Big] \end{aligned}\]
Gradient của nó cho biết DPO thật sự làm gì:
\[\begin{aligned} &\nabla_\theta \mathcal{L}_{DPO} = -\beta\, \mathbb{E}\big[\sigma(\hat{r}_l - \hat{r}_w) \\ &\quad \times \big(\nabla_\theta \log \pi_\theta(y_w) \\ &\qquad - \nabla_\theta \log \pi_\theta(y_l)\big)\big] \end{aligned}\]
Mỗi bước tăng xác suất câu được chọn, giảm xác suất câu bị loại, với trọng số \(\sigma(\hat{r}_l - \hat{r}_w)\): trọng số lớn khi phần thưởng ngầm đang xếp sai thứ tự, nhỏ khi đã xếp đúng. Bài báo ghi rằng bản bỏ trọng số này có thể làm mô hình thoái hóa. Lúc bắt đầu, \(\pi_\theta = \pi_{ref}\) nên mọi phần thưởng ngầm bằng 0 và trọng số đều là 0,5.
Kiểm chứng bằng numpy
Ví dụ nhỏ: một prompt có 4 câu trả lời A, B, C, D. Mô hình tham chiếu chọn chúng với xác suất 0,40; 0,30; 0,20; 0,10. Người chấm ngầm dùng phần thưởng 0; 0,5; 1,0; 1,5 và chọn theo Bradley-Terry. Code chỉ cho DPO thấy xác suất ưu tiên của 6 cặp và mô hình tham chiếu, không bao giờ cho thấy phần thưởng, rồi hạ gradient trên hàm mất mát DPO.
"""DPO trên một prompt có 4 câu trả lời: học thẳng từ xác suất ưu tiên, không có mô hình thưởng.

Người chấm ngầm dùng phần thưởng R_THAT và chọn theo Bradley-Terry: P(i hơn j) = sigmoid(R_i - R_j).
DPO chỉ thấy các xác suất ưu tiên đó và mô hình tham chiếu PI_REF; nó không bao giờ thấy R_THAT.
Chạy: python dpo_mini.py
"""
import numpy as np

PI_REF = np.array([0.40, 0.30, 0.20, 0.10])  # mô hình SFT chọn câu A, B, C, D
R_THAT = np.array([0.0, 0.5, 1.0, 1.5])  # phần thưởng ẩn của người chấm
I, J = np.triu_indices(4, k=1)  # 6 cặp (i, j) với i < j


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def softmax(z):
    e = np.exp(z - z.max())
    return e / e.sum()


def mat_mat_mot_cap(lech_thang, lech_thua, beta):
    """Phương trình 7: -log sigmoid(beta * (lệch log của câu thắng - lệch log của câu thua))."""
    return float(-np.log(sigmoid(beta * (lech_thang - lech_thua))))


def hoc_dpo(beta, so_buoc=20000, toc_do=1.0):
    theta = np.log(PI_REF)  # bắt đầu đúng bằng mô hình tham chiếu
    p = sigmoid(R_THAT[I] - R_THAT[J])  # xác suất người chọn i thay vì j
    for _ in range(so_buoc):
        pi = softmax(theta)
        h = np.log(pi) - np.log(PI_REF)  # beta * h là "phần thưởng ngầm"
        z = beta * (h[I] - h[J])
        d = beta * (sigmoid(z) - p) / len(I)  # đạo hàm mất mát trung bình theo h_i (và trừ cho h_j)
        g_h = np.zeros(4)
        np.add.at(g_h, I, d)
        np.add.at(g_h, J, -d)
        theta = theta - toc_do * (g_h - pi * g_h.sum())  # nhân với đạo hàm của log softmax
    return softmax(theta)


def chinh_sach_toi_uu(beta):
    """Phương trình 4: pi*(y) tỉ lệ với pi_ref(y) * exp(r(y) / beta)."""
    return softmax(np.log(PI_REF) + R_THAT / beta)


if __name__ == "__main__":
    np.set_printoptions(precision=3, suppress=True)
    for beta in (0.5, 2.0):
        pi = hoc_dpo(beta)
        print(f"beta = {beta}: DPO học được {pi}, công thức đóng {chinh_sach_toi_uu(beta)}")
        r_ngam = beta * (np.log(pi) - np.log(PI_REF))
        print(f"  phần thưởng ngầm dời về 0: {r_ngam - r_ngam.mean()}, phần thưởng thật dời về 0: {R_THAT - R_THAT.mean()}")
    print(f"mất mát một cặp (beta 0.1, lệch +0.2 và -0.1) = {mat_mat_mot_cap(0.2, -0.1, 0.1):.4f}")
    print(f"trọng số gradient lúc bắt đầu = {sigmoid(0.0):.2f}")
| Câu | Tham chiếu | DPO với β = 0,5 |
DPO với β = 2 |
|---|---|---|---|
| A | 0,40 | 0,085 | 0,302 |
| B | 0,30 | 0,173 | 0,290 |
| C | 0,20 | 0,314 | 0,249 |
| D | 0,10 | 0,427 | 0,160 |
Với cả hai giá trị β, kết quả trùng tới ba chữ số với nghiệm đóng \(\pi_{ref}\, e^{r/\beta} / Z\) của bài toán RLHF, dù DPO chưa từng thấy phần thưởng. Phần thưởng ngầm, sau khi dời về trung bình 0, đúng bằng −0,75; −0,25; 0,25; 0,75, tức phần thưởng thật dời về 0. Hai điều đáng nhớ: DPO chỉ khôi phục phần thưởng sai khác một hằng số, vì dữ liệu cặp không cho biết mức tuyệt đối; và β quyết định mô hình được đi xa đến đâu. Với β = 2, câu D chỉ lên 0,16 thay vì 0,43.
Dòng gần cuối tính mất mát cho một cặp với β = 0,1: câu thắng có log xác suất tăng 0,2 so với tham chiếu, câu thua giảm 0,1, nên \(z = 0{,}1 \times 0{,}3 = 0{,}03\) và mất mát là \(\log(1 + e^{-0{,}03}) \approx 0{,}6783\), chỉ nhỉnh dưới ln 2. Nếu bạn tự cài DPO, hai phép thử này rất đáng làm: kết quả phải khớp nghiệm đóng trên ví dụ nhỏ, và mất mát lúc bắt đầu phải đúng bằng ln 2.
Bài báo đo được gì
Thí nghiệm có kiểm soát đầu tiên là sinh đánh giá phim mang cảm xúc tích cực: mô hình GPT-2-large, phần thưởng thật lấy từ một bộ phân loại cảm xúc. Vì biết phần thưởng thật, nhóm tác giả vẽ được đường biên giữa phần thưởng đạt được và độ lệch KL qua 22 lần chạy. DPO cho đường biên tốt nhất, hơn cả PPO được dùng thẳng phần thưởng thật.
Với tóm tắt bài đăng Reddit (tập TL;DR, mô hình GPT-J), GPT-4 làm giám khảo so bản tóm tắt sinh ra với bản tóm tắt mẫu. DPO thắng khoảng 61% ở nhiệt độ 0, còn PPO ở nhiệt độ tốt nhất của nó là 57%. PPO tụt về mức của mô hình gốc khi nhiệt độ cao, DPO thì giữ được. Người chấm thật cũng chọn tóm tắt của DPO hơn PPO trong 58% số lần. Đem cả hai sang tóm tắt tin CNN/DailyMail, một kiểu văn bản chưa từng học, DPO thắng bản mẫu 36% so với 26% của PPO. Với hội thoại một lượt trên tập Anthropic HH (mô hình Pythia-2.8B), DPO là phương pháp tiết kiệm tính toán duy nhất vượt được câu trả lời được chọn trong tập kiểm tra.
Các số này phụ thuộc vào giám khảo GPT-4. Nhóm tác giả kiểm lại bằng người: mức đồng ý giữa người và GPT-4 thường ngang hoặc cao hơn mức đồng ý giữa hai người với nhau. Cách đọc tỉ lệ thắng và giám khảo là mô hình được nói kỹ trong bài đánh giá câu trả lời AI.
Dùng DPO trong thực tế
Dữ liệu cho DPO là các bộ ba: prompt, câu được chọn, câu bị loại. Mô hình tham chiếu nên là mô hình SFT đã sinh ra các câu đó. Nếu bạn dùng một tập ưu tiên có sẵn mà không có mô hình SFT tương ứng, bài báo khuyên tinh chỉnh trước trên các câu được chọn rồi lấy mô hình đó làm tham chiếu, để giảm độ lệch phân phối. Bài fine-tuning là gì nói về bước tinh chỉnh có giám sát này.
Về tham số, bài báo mặc định β = 0,1, dùng β = 0,5 cho TL;DR, tối ưu RMSprop với tốc độ học \(10^{-6}\), mỗi lô có 64 ví dụ, tăng dần tốc độ học trong 150 bước đầu. Nhóm tác giả ghi họ gần như không chỉnh β, nên kết quả có thể còn thấp hơn khả năng thật của DPO. Khi chạy, hãy theo dõi cả tỉ lệ thắng lẫn độ lệch KL so với tham chiếu: điểm tốt hơn mà lệch quá xa chưa chắc đã đáng.
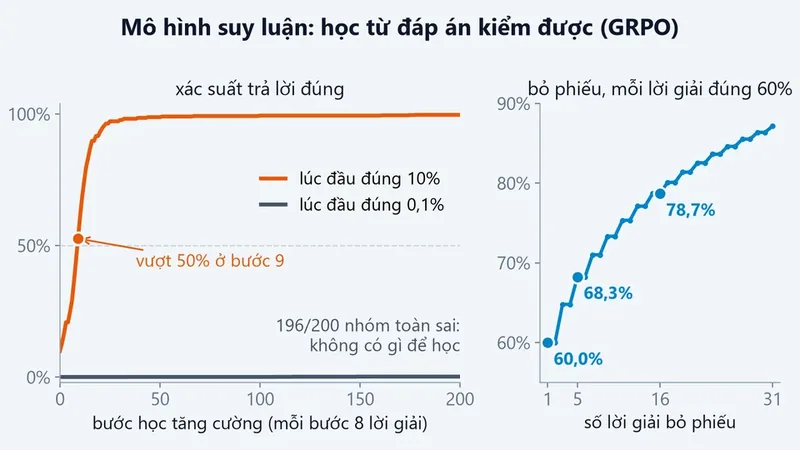
Phần giới hạn trong bài báo đáng đọc kỹ. DPO học trên dữ liệu cố định, không tự sinh câu mới trong lúc học; khả năng tổng quát ra ngoài phân phối mới có bằng chứng ban đầu; câu hỏi DPO có bị "tối ưu quá tay" như RLHF hay không vẫn còn mở; và thí nghiệm chỉ tới mô hình 6 tỷ tham số. Với bài toán có đáp án kiểm được như toán và lập trình, DeepSeek-R1 lại dùng học tăng cường với phần thưởng chấm bằng quy tắc, như bài mô hình suy luận mô tả.
- Dùng mô hình tham chiếu khác với mô hình đã sinh dữ liệu cặp mà không tinh chỉnh trước: độ lệch phân phối làm DPO kém đi.
- Đặt
βquá nhỏ rồi chỉ nhìn mất mát: mô hình có thể đi rất xa tham chiếu. - Nghĩ DPO không cần dữ liệu tốt: nó học đúng những gì cặp so sánh nói, kể cả thiên lệch của người gán nhãn.
- Tin tuyệt đối vào tỉ lệ thắng do một mô hình chấm: kết quả đổi theo prompt của giám khảo.
Câu hỏi thường gặp
DPO khác RLHF ở đâu?
Cùng mục tiêu, khác cách giải. RLHF học mô hình thưởng rồi tối ưu bằng PPO; DPO tối ưu thẳng mô hình ngôn ngữ trên cặp so sánh bằng một hàm mất mát phân loại.
DPO có cần mô hình thưởng không?
Không cần mô hình thưởng riêng. Phần thưởng nằm ngầm trong tỉ số xác suất giữa mô hình đang học và mô hình tham chiếu.
Beta trong DPO nghĩa là gì?
Là độ mạnh của ràng buộc giữ gần mô hình tham chiếu. Beta nhỏ cho phép mô hình thay đổi nhiều; beta lớn giữ nó gần bản gốc.
Dữ liệu cho DPO lấy ở đâu?
Từ các cặp câu trả lời cho cùng một prompt mà người, hoặc một mô hình làm giám khảo, đã chọn câu tốt hơn.
Học tiếp
- RLHF là gì: mô hình thưởng, PPO và phạt KL mà DPO thay thế.
- Fine-tuning là gì: bước tinh chỉnh có giám sát trước DPO.
- Mô hình suy luận: học tăng cường với đáp án kiểm được.
Nếu bạn muốn học Python và học máy bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.