- Ghi một dòng cho mỗi lần gọi: thời điểm, mô hình, token vào và ra, token đọc và ghi cache, độ trễ, lý do dừng, lỗi, mã yêu cầu.
- Bốn con số xem hằng ngày: chi phí theo mô hình, độ trễ trung vị và phân vị 95, tỷ lệ lỗi theo loại, tỷ lệ câu trả lời bị cắt.
- Không ghi nguyên văn câu hỏi và câu trả lời mặc định, vì có thể chứa thông tin cá nhân; ghi độ dài hoặc mã băm thay vào.
- Phía nhà cung cấp cũng có công cụ: tiêu đề giới hạn tốc độ trong mỗi phản hồi, trang sử dụng trong bảng điều khiển, và API báo cáo chi phí cho tổ chức.
Bài này dựa trên trang Rate limits (mục tiêu đề phản hồi) và Usage and Cost API trong tài liệu của Anthropic, cùng quy ước đặt tên của OpenTelemetry cho ứng dụng AI tạo sinh, đọc ngày 11/11/2026.
Ghi gì cho mỗi lần gọi
Mỗi phản hồi của API mang sẵn những thông tin quý: số token đầu vào, số token đầu ra, số token đọc và ghi cache, lý do dừng. Tài liệu lỗi API còn ghi mỗi phản hồi có một mã yêu cầu duy nhất, dùng khi cần hỏi hỗ trợ. Bạn chỉ cần lưu chúng lại, thêm hai thứ phía bạn đo: thời điểm và độ trễ (từ lúc gửi tới lúc nhận xong). Khi lỗi, ghi tên loại lỗi.
Một dòng JSON cho mỗi lần gọi, nối vào một tệp, là đủ cho ứng dụng nhỏ. Khi lớn hơn, đẩy vào một hệ thống nhật ký hay cơ sở dữ liệu. Nếu dùng công cụ giám sát chung, quy ước của OpenTelemetry cho ứng dụng AI tạo sinh đặt sẵn tên các trường như mô hình, số token, giúp các công cụ khác nhau hiểu cùng một dữ liệu.
Bốn con số nên xem
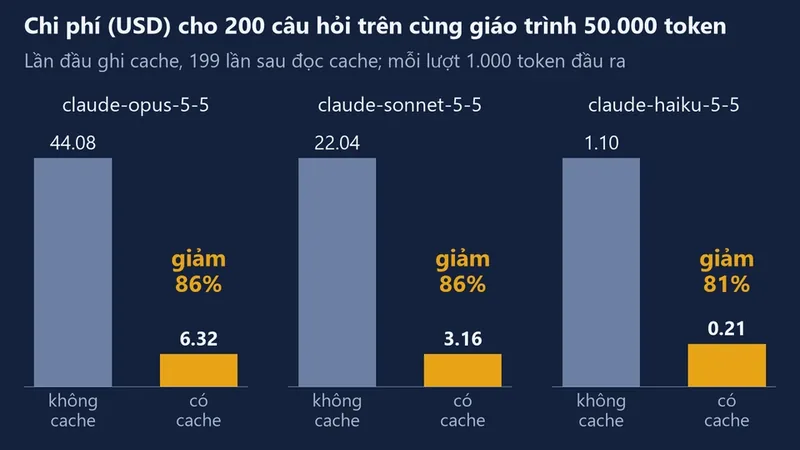
Chi phí theo mô hình. Nhân token với giá của từng mô hình, nhớ tính riêng token đọc cache và token ghi cache vì giá khác: ghi cache đắt hơn token vào thường, đọc cache rẻ hơn nhiều. Với Haiku 5.5, lần gọi có prompt trên 100.000 token (tính cả phần đọc và ghi cache) trả giá cao hơn cho mọi loại token. Xem theo ngày và theo tính năng của ứng dụng, để biết tính năng nào tốn nhất. Một con số tăng vọt thường do một thay đổi prompt, một vòng lặp gọi lại không dừng, hoặc ai đó lạm dụng.
Độ trễ trung vị và phân vị 95. Trung bình che mất những lần rất chậm. Phân vị 95 cho biết 5% người dùng chậm nhất chờ bao lâu, thường là con số người dùng phàn nàn.
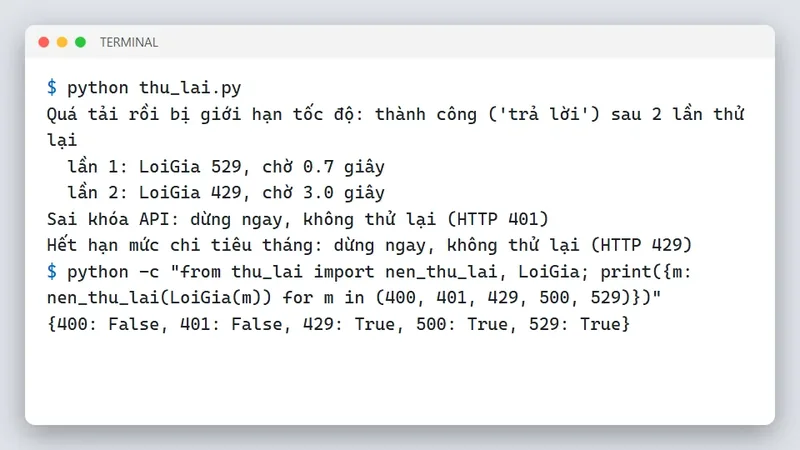
Tỷ lệ lỗi theo loại. Giới hạn tốc độ tăng là dấu hiệu cần gửi đều hơn hoặc xin nâng hạng; quá tải thường là tạm thời; lỗi yêu cầu sai là lỗi code của bạn. Gộp chung mọi lỗi làm mất thông tin này, vì mỗi loại cần một cách xử lý khác nhau.
Tỷ lệ bị cắt. Lý do dừng là chạm giới hạn token nghĩa là người dùng nhận câu trả lời cụt. Tỷ lệ này tăng là lúc xem lại giới hạn độ dài hoặc prompt.
Ví dụ bằng Python
Hàm goi_co_ghi bọc một lời gọi mô hình: đo thời gian, ghi một dòng JSON gồm các trường ở trên vào tệp, kể cả khi lỗi (ghi xong rồi ném lại lỗi để phần gọi xử lý). Hàm tong_hop đọc các dòng và tính bốn con số cho từng mô hình. Dòng nhật ký không chứa nội dung câu hỏi.
"""Giám sát ứng dụng gọi mô hình AI: ghi mỗi lần gọi thành một dòng JSON, rồi tổng hợp chi phí, độ trễ, lỗi.

Mỗi dòng nhật ký: thời điểm, mô hình, token vào/ra/đọc cache/ghi cache, độ trễ (giây), lý do dừng, mã lỗi, mã yêu cầu.
KHÔNG ghi nguyên văn câu hỏi và câu trả lời (có thể chứa thông tin cá nhân); nếu cần, ghi độ dài hoặc mã băm.
Giá USD / 1 triệu token theo trang Pricing của Anthropic, đọc lại 14/11/2026 (vào, ra, đọc cache, ghi cache 5 phút,
ghi cache 1 giờ). Haiku 5.5 tính giá theo độ dài prompt: lần gọi có prompt trên 100.000 token, tính cả token đọc và
ghi cache, trả giá cao hơn cho mọi loại token.
"""
import json
import time

GIA = {"claude-opus-5-5": (4.0, 20.0, 0.20, 5.0, 8.0), "claude-haiku-5-5": (0.10, 0.50, 0.01, 0.125, 0.20)}
GIA_PROMPT_DAI = {"claude-haiku-5-5": (100_000, (0.50, 2.50, 0.05, 0.625, 1.0))}  # (ngưỡng token prompt, giá khi vượt)


def chi_phi(dong):
    doc, ghi, ghi_1g = (dong.get(k, 0) for k in ("token_doc_cache", "token_ghi_cache", "token_ghi_cache_1g"))
    gia = GIA[dong["mo_hinh"]]
    nguong, gia_dai = GIA_PROMPT_DAI.get(dong["mo_hinh"], (None, None))
    if nguong and dong["token_vao"] + doc + ghi > nguong:
        gia = gia_dai
    vao, ra, gia_doc, gia_ghi_5p, gia_ghi_1g = gia
    return (dong["token_vao"] * vao + dong["token_ra"] * ra + doc * gia_doc
            + (ghi - ghi_1g) * gia_ghi_5p + ghi_1g * gia_ghi_1g) / 1e6


def goi_co_ghi(client, tep, **tham_so):
    """Bọc một lời gọi: đo thời gian, ghi một dòng JSON vào tệp, trả về phản hồi (hoặc ném lại lỗi sau khi ghi)."""
    bat_dau, dong = time.monotonic(), {"luc": time.strftime("%Y-%m-%dT%H:%M:%S"), "mo_hinh": tham_so["model"]}
    try:
        tl = client.messages.create(**tham_so)
        u = tl.usage
        theo_han = getattr(u, "cache_creation", None)  # chia token ghi cache theo thời hạn 5 phút / 1 giờ; có thể None
        dong.update(token_vao=u.input_tokens, token_ra=u.output_tokens,
                    token_doc_cache=getattr(u, "cache_read_input_tokens", 0) or 0,
                    token_ghi_cache=getattr(u, "cache_creation_input_tokens", 0) or 0,
                    token_ghi_cache_1g=getattr(theo_han, "ephemeral_1h_input_tokens", 0) or 0,
                    ly_do_dung=tl.stop_reason, loi=None, ma_yeu_cau=getattr(tl, "_request_id", None))
        return tl
    except Exception as e:  # noqa: BLE001
        dong.update(token_vao=0, token_ra=0, ly_do_dung=None, loi=type(e).__name__)
        raise
    finally:
        dong["do_tre"] = round(time.monotonic() - bat_dau, 3)
        with open(tep, "a", encoding="utf-8") as f:
            f.write(json.dumps(dong, ensure_ascii=False) + "\n")


def phan_vi(ds, p):
    ds = sorted(ds)
    return ds[min(len(ds) - 1, int(p * len(ds)))] if ds else 0.0


def tong_hop(cac_dong):
    kq = {}
    for m in sorted({d["mo_hinh"] for d in cac_dong}):
        ds = [d for d in cac_dong if d["mo_hinh"] == m]
        tot = [d for d in ds if not d["loi"]]
        kq[m] = {
            "so_lan": len(ds),
            "chi_phi": round(sum(chi_phi(d) for d in tot), 4),
            "tre_p50": phan_vi([d["do_tre"] for d in tot], 0.5),
            "tre_p95": phan_vi([d["do_tre"] for d in tot], 0.95),
            "ty_le_loi": round(1 - len(tot) / len(ds), 3),
            "ty_le_bi_cat": round(sum(d["ly_do_dung"] == "max_tokens" for d in tot) / max(1, len(tot)), 3),
        }
    return kq


def tao_nhat_ky_mau():
    """Dữ liệu giả lập có quy luật để chạy thử (không phải số đo thật)."""
    ds = []
    for i in range(200):
        m = "claude-haiku-5-5" if i % 4 else "claude-opus-5-5"
        loi = "RateLimitError" if i % 50 == 7 else None
        ds.append({"mo_hinh": m, "token_vao": 0 if loi else 800, "token_ra": 0 if loi else 200 + (i % 5) * 50,
                   "token_doc_cache": 0 if loi else 3000, "do_tre": round(0.5 + (i % 10) * 0.2 + (2 if m.endswith("opus-5-5") else 0), 3),
                   "ly_do_dung": None if loi else ("max_tokens" if i % 25 == 3 else "end_turn"), "loi": loi})
    return ds


def chay_thu():
    dong = []
    for m, s in tong_hop(tao_nhat_ky_mau()).items():
        dong.append(f"{m}: {s['so_lan']} lần, {s['chi_phi']} USD, trễ p50 {s['tre_p50']}s p95 {s['tre_p95']}s, "
                    f"lỗi {s['ty_le_loi']:.1%}, bị cắt {s['ty_le_bi_cat']:.1%}")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Phần chạy thử dùng 200 dòng nhật ký giả lập có quy luật (không phải số đo thật): ba phần tư lần gọi dùng Haiku 5.5, một phần tư dùng Opus 5.5, có vài lần lỗi giới hạn tốc độ và vài lần bị cắt. Kết quả cho Haiku 5.5: 150 lần, khoảng 0,038 USD, độ trễ trung vị 1,5 giây, phân vị 95 là 2,3 giây, lỗi 2,7%, bị cắt 4,1%. Opus 5.5: 50 lần, khoảng 0,49 USD, chậm hơn, không lỗi. Dù là số giả, cách đọc giống hệt với số thật: mô hình lớn chiếm phần lớn chi phí dù ít lần gọi hơn.
Đọc nhật ký để ra quyết định
Con số chỉ có ích khi dẫn tới hành động. Vài ví dụ cách đọc. Chi phí một tính năng chiếm phần lớn hóa đơn mà ít người dùng: xem lại prompt của tính năng đó, thử mô hình nhỏ hơn, hoặc thêm cache cho phần chỉ dẫn dài. Phân vị 95 độ trễ cao vì một nhóm câu hỏi rất dài: giới hạn độ dài đầu vào, hoặc chuyển nhóm đó sang xử lý nền. Tỷ lệ bị cắt tăng sau khi đổi prompt: prompt mới làm câu trả lời dài hơn, tăng giới hạn token hoặc dặn trả lời gọn. Tỷ lệ lỗi giới hạn tốc độ tăng vào giờ cao điểm: dàn đều yêu cầu, dùng hàng đợi, hoặc chuyển phần không gấp sang xử lý theo lô.
Gắn thêm một trường tên tính năng vào mỗi dòng nhật ký ngay từ đầu. Không có trường này, bạn chỉ biết tổng chi phí tăng mà không biết tăng ở đâu. Thêm mã phiên bản prompt cũng rất đáng: khi số liệu thay đổi, bạn biết ngay có trùng với lần đổi prompt nào không.
Riêng tư khi ghi nhật ký
Câu hỏi của người dùng có thể chứa tên, số điện thoại, điểm số, nội dung riêng. Ghi nguyên văn vào nhật ký nghĩa là tạo thêm một nơi chứa dữ liệu cá nhân phải bảo vệ. Mặc định, chỉ ghi các con số. Khi cần xem nội dung để dò lỗi, bật ghi nội dung trong thời gian ngắn, cho một nhóm nhỏ, che thông tin cá nhân trước khi ghi, và xóa sau khi xong. Nhật ký cũng không bao giờ được chứa khóa API.
Công cụ phía nhà cung cấp
Trang giới hạn tốc độ mô tả các tiêu đề trong mỗi phản hồi cho biết giới hạn số yêu cầu và token, còn lại bao nhiêu, khi nào hồi lại; ghi các giá trị này giúp thấy trước khi sắp chạm giới hạn. Bảng điều khiển của tài khoản có trang sử dụng với biểu đồ token và tỷ lệ đọc cache. Với tổ chức, có API báo cáo sử dụng và chi phí dành cho quản trị viên; theo tài liệu, API quản trị không có cho tài khoản cá nhân. Đối chiếu tổng của nhật ký bạn với số của nhà cung cấp định kỳ để chắc nhật ký không bỏ sót. Nếu hai con số lệch nhiều, thường là có chỗ gọi mô hình chưa đi qua hàm ghi nhật ký, ví dụ một đoạn thử nghiệm ai đó viết vội, hoặc một tác vụ chạy nền bị quên. Tìm và đưa nó vào hàm ghi chung.
Cảnh báo tự động
Đặt vài ngưỡng và gửi thông báo khi vượt: chi phí trong ngày vượt mức dự kiến, tỷ lệ lỗi trong một giờ vượt vài phần trăm, phân vị 95 độ trễ tăng gấp đôi so với tuần trước. Kết hợp với hạn mức chi tiêu đặt ở tài khoản API để có lớp chặn cứng. Với lỗi tạm thời, cơ chế thử lại trong bài xử lý lỗi khi gọi API AI giảm ảnh hưởng tới người dùng; nhật ký cho bạn biết bao nhiêu lần đã phải thử lại.
- Không ghi gì, tới cuối tháng mới thấy hóa đơn bất thường.
- Chỉ xem độ trễ trung bình, bỏ qua những lần rất chậm.
- Gộp mọi lỗi làm một con số.
- Ghi nguyên văn câu hỏi có thông tin cá nhân, hoặc ghi cả khóa API.
- Tính chi phí bỏ qua token đọc và ghi cache.
Câu hỏi thường gặp
Có cần công cụ giám sát trả phí không?
Không bắt buộc với ứng dụng nhỏ. Tệp JSON và một đoạn tổng hợp là đủ để bắt đầu.
Lưu nhật ký bao lâu?
Đủ để so sánh theo tuần, theo tháng. Dữ liệu chỉ có con số thì lưu lâu ít rủi ro; dữ liệu có nội dung thì xóa sớm.
Đo độ trễ khi truyền dần thế nào?
Ghi cả thời gian tới đoạn chữ đầu tiên và thời gian tới khi xong.
Ghi nhật ký có làm chậm ứng dụng?
Ghi một dòng vào tệp rất nhanh. Với hệ thống lớn, gửi nhật ký bất đồng bộ.
Học tiếp
- Xử lý những lỗi nhật ký ghi lại: xử lý lỗi khi gọi API AI.
- Ước token trước khi gọi: đếm token trước khi gọi API.
- Giảm phần lớn nhất trong hóa đơn: prompt caching.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.