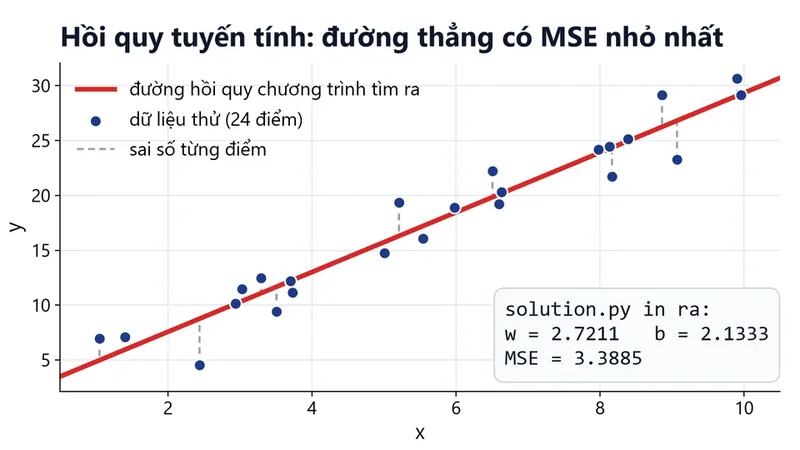
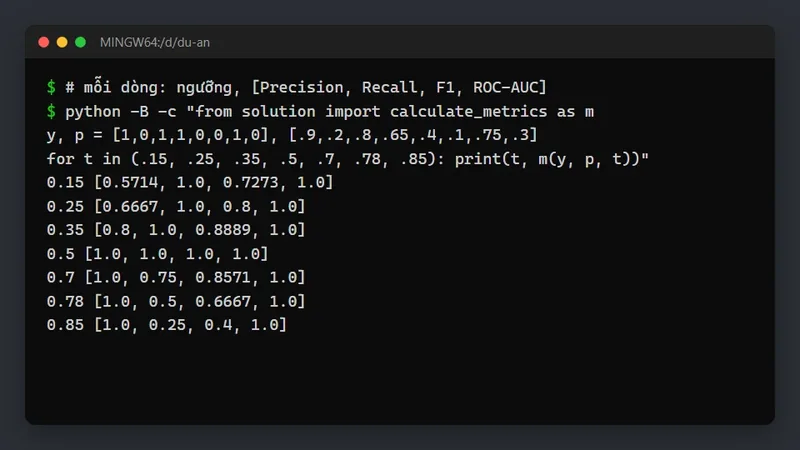
- Loss vs Cost vs Metric: Phân biệt rõ Loss trên từng mẫu đơn lẻ, Cost trên toàn bộ tập dữ liệu, và Metric phi khả vi dùng để con người đánh giá.
- MSE vs MAE: MSE nhạy cảm và phạt nặng sai số lớn do phép bình phương, trong khi MAE mạnh mẽ và bền vững trước các điểm dữ liệu dị biệt (Outliers).
- Huber Loss (Smooth L1): Kết hợp hoàn hảo tính mượt mà của MSE khi sai số nhỏ và tính bền vững tuyến tính của MAE khi sai số lớn.
- Cross-Entropy Loss: Thước đo khoảng cách phân phối xác suất dựa trên lý thuyết thông tin, mang lại gradient mạnh mẽ giúp mạng nơ-ron phân loại hội tụ nhanh.
Nếu thuật toán tối ưu hóa (như Gradient Descent hay Adam) được xem như động cơ đẩy chiếc thuyền học máy tiến về phía trước, thì Hàm mất mát (Loss Function) chính là chiếc la bàn định hướng cho toàn bộ hành trình đó. Hàm mất mát chuyển hóa mục tiêu kinh doanh trừu tượng thành một giá trị toán học vô hướng duy nhất đo lường mức độ sai khác giữa dự đoán của mô hình và thực tế khách quan. Chọn sai hàm mất mát đồng nghĩa với việc bạn đang hướng dẫn thuật toán đi sai đường, khiến mô hình học vẹt vào các điểm ngoại lai vô nghĩa hoặc bị tê liệt hoàn toàn trong quá trình hội tụ.
1. Phân biệt Khái niệm: Loss Function vs Cost Function vs Metric
Trước khi đi sâu vào công thức, chúng ta cần làm rõ 3 thuật ngữ thường bị đánh đồng:
- Loss Function (Hàm mất mát): Đo lường sai số trên một mẫu dữ liệu đơn lẻ \((\mathbf{x}_i, y_i)\), ký hiệu \(\mathcal{L}(y_i, \hat{y}_i)\).
- Cost Function (Hàm chi phí): Là giá trị trung bình của Loss Function trên toàn bộ tập dữ liệu huấn luyện gồm \(N\) mẫu, thường cộng thêm thành phần điều chuẩn (Regularization): \[J(\mathbf{w}) = \frac{1}{N} \sum_{i=1}^N \mathcal{L}(y_i, \hat{y}_i) + \lambda \mathcal{R}(\mathbf{w})\]
- Metric (Chỉ số đánh giá): Là thước đo định lượng dùng để con người đánh giá và so sánh chất lượng mô hình (như Accuracy, F1-Score, BLEU). Metric không nhất thiết phải khả vi, trong khi Loss Function bắt buộc phải khả vi (hoặc khả vi dưới mức sub-differentiable) để thuật toán có thể tính đạo hàm cập nhật trọng số.
2. Nhóm Hàm Mất mát cho Bài toán Hồi quy (Regression)
1. Mean Squared Error (MSE / L2 Loss)
Là hàm mất mát phổ biến nhất trong bài toán dự đoán giá trị liên tục (như dự báo giá nhà, nhiệt độ): \[\text{MSE} = \frac{1}{N} \sum_{i=1}^N (y_i - \hat{y}_i)^2\]
- Đạo hàm: \(\frac{\partial \text{MSE}}{\partial \hat{y}_i} = -\frac{2}{N}(y_i - \hat{y}_i)\).
- Đặc điểm: Đạo hàm tuyến tính mượt mà, suy giảm dần về \(0\) khi mô hình tiệm cận nghiệm tối ưu. Tuy nhiên, do phép toán bình phương sai số, MSE phạt cực nặng các sai số lớn. Nếu tập dữ liệu có các điểm ngoại lai (Outliers) dị biệt, MSE sẽ ép buộc mô hình bẻ cong đường dự đoán để chiều theo các ngoại lai đó, làm hỏng độ chính xác trên đa số mẫu bình thường.
2. Mean Absolute Error (MAE / L1 Loss)
Tính trung bình độ lệch tuyệt đối giữa giá trị thực tế và dự đoán: \[\text{MAE} = \frac{1}{N} \sum_{i=1}^N |y_i - \hat{y}_i|\]
- Đạo hàm: Bằng \(+1\) nếu \(\hat{y}_i \gt y_i\) và \(-1\) nếu \(\hat{y}_i \lt y_i\).
- Đặc điểm: Độ dốc không đổi bất kể sai số lớn hay nhỏ, giúp MAE cực kỳ bền bỉ (Robust) trước các điểm ngoại lai. Tuy nhiên, tại điểm tối ưu \(y_i = \hat{y}_i\), hàm số không khả vi (gấp khúc nhọn), khiến thuật toán Gradient Descent dễ bị dao động nhảy qua lại điểm cực tiểu nếu không giảm dần tốc độ học.
3. Huber Loss: Sự kết hợp hoàn hảo giữa MSE và MAE
Được nhà thống kê Peter Huber đề xuất để tận dụng trọn vẹn điểm mạnh của cả MSE và MAE thông qua ngưỡng sai số \(\delta \gt 0\): \[\mathcal{L}_\delta(y, \hat{y}) = \begin{cases} \frac{1}{2}(y - \hat{y})^2 & \text{khi } |y - \hat{y}| \le \delta \\ \delta \cdot \left(|y - \hat{y}| - \frac{1}{2}\delta\right) & \text{khi } |y - \hat{y}| \gt \delta \end{cases}\]
- Trực giác: Khi sai số nhỏ (\(|e| \le \delta\)), hàm hoạt động như MSE có đạo hàm trơn tru giúp hội tụ nhanh. Khi sai số lớn (\(|e| \gt \delta\)), hàm chuyển sang tính chất tuyến tính của MAE, giới hạn lực phạt của các điểm ngoại lai cực đoan. Đây là hàm mất mát tiêu chuẩn trong bài toán Object Detection (như Smooth L1 Loss trong mạng Faster R-CNN).
3. Nhóm Hàm Mất mát cho Bài toán Phân loại (Classification)
1. Binary Cross-Entropy (BCE / Log Loss)
Dành cho bài toán phân loại nhị phân (\(y \in \{0, 1\}\)) với xác suất dự đoán \(\hat{y} = P(y = 1 \mid \mathbf{x}) \in (0, 1)\): \[\text{BCE} = -\frac{1}{N} \sum_{i=1}^N \left[ y_i \log(\hat{y}_i) + (1 - y_i) \log(1 - \hat{y}_i) \right]\]
- Trực giác xác suất: Xuất phát từ nguyên lý Ước lượng Hợp lý Cực đại (Maximum Likelihood Estimation - MLE) cho phân phối Bernoulli. Khi nhãn thực tế \(y = 1\), hàm mất mát thu gọn thành \(-\log(\hat{y})\). Nếu mô hình tự tin dự đoán \(\hat{y} = 0.99\), \(-\log(0.99) \approx 0.01\) (mất mát rất nhỏ). Nhưng nếu mô hình đoán sai nghiêm trọng \(\hat{y} = 0.01\), \(-\log(0.01) \approx 4.60\), phạt cấp số mũ cực kỳ nặng!
2. Categorical Cross-Entropy (CCE)
Mở rộng cho bài toán phân loại đa lớp (\(K \gt 2\) lớp loại trừ lẫn nhau, ví dụ nhận diện 10 chữ số từ 0 đến 9), kết hợp với tầng kích hoạt Softmax: \[\text{CCE} = -\frac{1}{N} \sum_{i=1}^N \sum_{k=1}^K y_{i,k} \log(\hat{y}_{i,k})\] Trong đó \(y_i\) là vector One-Hot (chỉ có đúng một vị trí bằng 1, các vị trí còn lại bằng 0). Do đó hàm CCE chỉ đơn giản tính \(-\log\) xác suất của đúng lớp nhãn thực tế.
3. Focal Loss: Vũ khí cho dữ liệu mất cân bằng cực đoan
Được giới thiệu bởi Tsung-Yi Lin và nhóm nghiên cứu FAIR (Meta), Focal Loss bổ sung hệ số điều chế \((1 - p_t)^\gamma\) vào Cross-Entropy: \[\text{FL}(p_t) = -\alpha_t (1 - p_t)^\gamma \log(p_t)\] Hệ số này tự động làm suy giảm trọng số của các mẫu "dễ học" (các mẫu nền đã dự đoán chắc chắn với \(p_t \gt 0.9\)), buộc mô hình tập trung toàn bộ năng lượng gradient vào các mẫu "khó học" và mẫu hiếm.
4. Ví dụ chạy tay so sánh giá trị các hàm mất mát
Xét tập kiểm tra gồm 5 mẫu với nhãn thực tế \(y\) và giá trị dự đoán \(\hat{y}\):
| Mẫu \(i\) | Nhãn thực tế \(y_i\) | Dự đoán \(\hat{y}_i\) | Sai số \(|y - \hat{y}|\) | MSE: \((y - \hat{y})^2\) | MAE: \(|y - \hat{y}|\) | Huber (\(\delta=1.0\)) | BCE (\(y \in \{0, 1\}\)) |
|---|---|---|---|---|---|---|---|
| 1 | \(1.0\) | \(0.85\) | \(0.15\) | \(0.0225\) | \(0.1500\) | \(0.0113\) | \(-\log(0.85) = 0.1625\) |
| 2 | \(0.0\) | \(0.15\) | \(0.15\) | \(0.0225\) | \(0.1500\) | \(0.0113\) | \(-\log(0.85) = 0.1625\) |
| 3 | \(1.0\) | \(0.70\) | \(0.30\) | \(0.0900\) | \(0.3000\) | \(0.0450\) | \(-\log(0.70) = 0.3567\) |
| 4 | \(0.0\) | \(0.35\) | \(0.35\) | \(0.1225\) | \(0.3500\) | \(0.0613\) | \(-\log(0.65) = 0.4308\) |
| 5 | \(1.0\) | \(0.92\) | \(0.08\) | \(0.0064\) | \(0.0800\) | \(0.0032\) | \(-\log(0.92) = 0.0834\) |
Tính trung bình trên 5 mẫu:
- MSE trung bình: \(\frac{0.0225 + 0.0225 + 0.0900 + 0.1225 + 0.0064}{5} = \frac{0.2639}{5} \approx 0.0528\).
- MAE trung bình: \(\frac{0.15 + 0.15 + 0.30 + 0.35 + 0.08}{5} = \frac{1.03}{5} = 0.2060\).
- Huber Loss trung bình: \(\frac{0.0113 + 0.0113 + 0.0450 + 0.0613 + 0.0032}{5} = \frac{0.1321}{5} \approx 0.0264\).
- BCE Loss trung bình: \(\frac{0.1625 + 0.1625 + 0.3567 + 0.4308 + 0.0834}{5} = \frac{1.1959}{5} \approx 0.2392\).
Chủ đề này nằm trong Lecture 04 - Linear Regression của Khóa AI. Xem đề cương
5. Cài đặt các Hàm Mất mát bằng Python và C++
import math

def compute_losses(y_true, y_pred, delta=1.0):
    n = len(y_true)
    mse = sum((y_true[i] - y_pred[i]) ** 2 for i in range(n)) / n
    mae = sum(abs(y_true[i] - y_pred[i]) for i in range(n)) / n

    huber = 0.0
    for i in range(n):
        diff = abs(y_true[i] - y_pred[i])
        if diff <= delta:
            huber += 0.5 * (diff ** 2)
        else:
            huber += delta * (diff - 0.5 * delta)
    huber /= n

    eps = 1e-12
    bce = 0.0
    for i in range(n):
        p = max(eps, min(1.0 - eps, y_pred[i]))
        bce -= (y_true[i] * math.log(p) + (1.0 - y_true[i]) * math.log(1.0 - p))
    bce /= n

    return [round(mse, 4), round(mae, 4), round(huber, 4), round(bce, 4)]

def solve(case):
    y_true, y_pred = case
    return compute_losses(y_true, y_pred)
#include <iostream>
#include <vector>
#include <cmath>
#include <iomanip>
#include <algorithm>

std::vector<double> compute_losses(const std::vector<double>& y_true, const std::vector<double>& y_pred, double delta = 1.0) {
    int n = y_true.size();
    double mse = 0.0, mae = 0.0, huber = 0.0, bce = 0.0;
    double eps = 1e-12;

    for (int i = 0; i < n; ++i) {
        double diff = std::abs(y_true[i] - y_pred[i]);
        mse += (y_true[i] - y_pred[i]) * (y_true[i] - y_pred[i]);
        mae += diff;
        if (diff <= delta) {
            huber += 0.5 * diff * diff;
        } else {
            huber += delta * (diff - 0.5 * delta);
        }
        double p = std::max(eps, std::min(1.0 - eps, y_pred[i]));
        bce -= (y_true[i] * std::log(p) + (1.0 - y_true[i]) * std::log(1.0 - p));
    }
    mse /= n;
    mae /= n;
    huber /= n;
    bce /= n;

    return {std::round(mse * 10000.0) / 10000.0,
            std::round(mae * 10000.0) / 10000.0,
            std::round(huber * 10000.0) / 10000.0,
            std::round(bce * 10000.0) / 10000.0};
}

int main() {
    int n;
    if (!(std::cin >> n)) return 0;
    std::vector<double> yt(n), yp(n);
    for (int i = 0; i < n; ++i) std::cin >> yt[i];
    for (int i = 0; i < n; ++i) std::cin >> yp[i];

    auto res = compute_losses(yt, yp);
    std::cout << std::fixed << std::setprecision(4);
    for (int i = 0; i < (int)res.size(); ++i) {
        if (i > 0) std::cout << " ";
        std::cout << res[i];
    }
    std::cout << "\n";
    return 0;
}
6. Hướng dẫn chọn hàm mất mát theo ngữ cảnh thực tế
| Bài toán nghiệp vụ | Hàm mất mát khuyến nghị | Lý do kỹ thuật cốt lõi |
|---|---|---|
| Dự báo giá cổ phiếu / Tài chính | Huber Loss / MAE | Thị trường có nhiều đột biến giá ngoại lai, MSE sẽ làm lệch mô hình |
| Phân loại nhị phân (Spam, Bệnh) | Binary Cross-Entropy | Dựa trên MLE, đạo hàm kết hợp Sigmoid cho gradient cực kỳ ổn định |
| Nhận diện hình ảnh đa nhãn (Multi-label) | BCE with Logits per class | Mỗi nhãn là một quyết định độc lập, không dùng Categorical Cross-Entropy |
| Phát hiện vật thể có class imbalance | Focal Loss | Tự động làm suy giảm gradient từ hàng nghìn vùng nền trống rỗng |
7. Bảng so sánh đặc tính toán học của các Hàm Mất mát
| Hàm mất mát | Dạng bài toán | Tính khả vi tại 0 | Độ nhạy ngoại lai | Tốc độ hội tụ |
|---|---|---|---|---|
| MSE (L2) | Hồi quy | Khả vi mượt mà | Rất cao (Bình phương) | Rất nhanh ở xa, chậm lại khi gần 0 |
| MAE (L1) | Hồi quy | Không khả vi tại 0 | Rất thấp (Bền vững) | Đều đặn, dễ dao động quanh cực tiểu |
| Huber Loss | Hồi quy | Khả vi liên tục \(C^1\) | Thấp (Tuyến tính ở xa) | Rất nhanh và ổn định tuyệt đối |
| Cross-Entropy | Phân loại | Khả vi mượt mà | Cao nếu gán nhãn sai | Cực nhanh nhờ cơ chế phạt logarit |
8. Câu hỏi thường gặp
Tại sao không dùng MSE cho bài toán phân loại nhị phân với hàm Sigmoid?
Nếu kết hợp MSE với hàm kích hoạt Sigmoid, hàm mất mát sẽ trở thành hàm không lồi (Non-convex) với rất nhiều điểm cực tiểu cục bộ (Local Minima) và các vùng yên ngựa phẳng. Khi mô hình dự đoán sai hoàn toàn (ví dụ \(y = 1\) nhưng \(\hat{y} \approx 0\)), đạo hàm của Sigmoid \(\sigma'(z) = \hat{y}(1 - \hat{y})\) sẽ gần bằng \(0\), khiến gradient của MSE bị triệt tiêu hoàn toàn! Ngược lại, Binary Cross-Entropy triệt tiêu chính xác số hạng \(\sigma'(z)\), giữ cho gradient luôn tỷ lệ thuận với \((\hat{y} - y)\), giúp mô hình học cực nhanh khi mắc sai lầm.
Thêm \(\epsilon = 10^{-12}\) vào hàm logarit để làm gì?
Khi mô hình dự đoán xác suất đạt tuyệt đối \(\hat{y} = 0.0\) hoặc \(\hat{y} = 1.0\), phép toán \(\log(0)\) trên máy tính sẽ trả về giá trị âm vô cùng (\(-\infty\)) hoặc lỗi NaN (Not a Number). Việc kẹp giá trị xác suất trong khoảng \([\epsilon, 1 - \epsilon]\) là một cách phòng thủ số học phổ biến để ngăn chặn việc sập luồng tính toán; PyTorch (nn.BCELoss) làm theo cách khác: kẹp đầu ra của hàm log ở mức không nhỏ hơn \(-100\).
9. Góc nhìn Lý thuyết Thông tin: Mối liên hệ giữa Cross-Entropy và KL Divergence
Tại sao trong các bài toán phân loại nhị phân và đa lớp, các nhà khoa học luôn ưu tiên sử dụng hàm mất mát Cross-Entropy thay vì sử dụng sai số bình phương trung bình MSE? Để thấu hiểu câu trả lời ở mức độ sâu sắc nhất, chúng ta cần tiếp cận dưới lăng kính của Lý thuyết Thông tin (Information Theory) do nhà toán học lỗi lạc Claude Shannon khởi xướng:
Trong lý thuyết thông tin, Độ phân kỳ Kullback-Leibler (KL Divergence) là thước đo định lượng mức độ sai khác hoặc khoảng cách phi đối xứng giữa hai phân phối xác suất. Gọi P là phân phối xác suất thực tế của dữ liệu (nhãn thật dạng one-hot) và Q là phân phối xác suất mà mô hình học máy đang dự đoán ra. Khi triển khai công thức tính toán, KL Divergence chính bằng hiệu số giữa Cross-Entropy của hai phân phối trừ đi Entropy tự thân của phân phối thực P.
Vì nhãn thực tế của dữ liệu là cố định và bất biến trong suốt quá trình huấn luyện, Entropy của phân phối thực P là một hằng số không phụ thuộc vào trọng số của mô hình. Do đó, việc tối thiểu hóa hàm mất mát Cross-Entropy hoàn toàn tương đương toán học với việc tối thiểu hóa độ phân kỳ KL Divergence giữa phân phối dự đoán của mô hình và phân phối chân lý khách quan!
Hơn thế nữa, về mặt động học tối ưu hóa Gradient Descent: khi kết hợp hàm kích hoạt Softmax ở tầng cuối cùng với hàm mất mát Cross-Entropy, đạo hàm của hàm mất mát đối với tín hiệu tuyến tính trước hàm kích hoạt có dạng rút gọn vô cùng thanh lịch: chính bằng hiệu số giữa xác suất dự đoán và nhãn thực tế. Khi mô hình dự đoán hoàn toàn sai lầm (ví dụ xác suất chỉ đạt 0.01 nhưng nhãn thật là 1.0), độ chênh lệch đạt xấp xỉ âm 0.99, tạo ra một lực đẩy gradient cực mạnh để kéo mô hình thoát khỏi vùng sai lầm trong tích tắc. Ngược lại, nếu dùng MSE kết hợp Softmax, đạo hàm sẽ bị kẹt trong vùng bão hòa bằng 0 của hàm số, khiến mô hình gần như tê liệt không thể học tập.
10. Hàm Mất mát Focal Loss: Cứu cánh cho Dữ liệu Mất cân bằng Cực đoan
Trong các bài toán nhận diện vật thể thời gian thực như RetinaNet, một bức ảnh chứa khoảng 100 nghìn khung hình neo (Anchor Boxes) nhưng chỉ có một vài khung hình chứa vật thể thực sự, còn lại 99.9% là khung hình nền trống rỗng. Nếu áp dụng hàm Cross-Entropy tiêu chuẩn, dù mỗi khung hình nền chỉ tạo ra một lượng mất mát rất nhỏ, nhưng tổng hợp của khoảng 100 nghìn khung hình nền dễ học (Easy Examples) sẽ áp đảo hoàn toàn tín hiệu của các vật thể hiếm hoi, khiến mô hình không thể học được cách nhận diện đối tượng chính.
Để giải quyết bài toán hóc búa này, Tsung-Yi Lin, Kaiming He và các cộng sự tại FAIR đã đề xuất hàm mất mát Focal Loss. Ý tưởng cách mạng của Focal Loss là bổ sung một hệ số điều biến lũy thừa vào phía trước hàm Cross-Entropy. Khi một mẫu dữ liệu đã được mô hình dự đoán chính xác với xác suất cao (mẫu dễ học), hệ số điều biến này sẽ nhanh chóng tiệm cận về 0, chủ động triệt tiêu và dập tắt tới 99% lượng mất mát của mẫu đó. Ngược lại, đối với các mẫu dữ liệu khó bị dự đoán sai, hệ số điều biến giữ nguyên giá trị gần bằng 1, buộc thuật toán tối ưu hóa phải dồn 100% năng lượng gradient vào việc giải quyết các trường hợp gai góc. Focal Loss đã trở thành giải pháp hàng đầu trong phát hiện gian lận tài chính, tầm soát bệnh lý hiếm và thị giác máy tính chuyên sâu.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.