- Nền tảng vững chắc: Toán học (Đại số tuyến tính, Giải tích vi phân, Xác suất thống kê) và Python là điều kiện tiên quyết để hiểu bản chất mô hình.
- Thực hành liên tục: Tự cài đặt thuật toán từ đầu với NumPy trước khi chuyển sang các thư viện cao cấp như scikit-learn hay PyTorch.
- Lộ trình 4 giai đoạn: Đi từ Nền tảng toán học & công cụ -> Học máy cổ điển -> Deep Learning & PyTorch -> Ứng dụng GenAI, LLM và MLOps.
- Tránh bẫy học vẹt: Hiểu rõ hàm mất mát (Loss Function), quy tắc tối ưu Gradient Descent và cơ chế đánh giá mô hình để xử lý tốt dữ liệu thực tế.
Bức tranh toàn cảnh về Trí tuệ nhân tạo
Trí tuệ nhân tạo (Artificial Intelligence - AI) là lĩnh vực khoa học máy tính hướng tới việc xây dựng các hệ thống có khả năng thực hiện những nhiệm vụ đòi hỏi trí thông minh của con người. Trong đó, Học máy (Machine Learning - ML) là phân ngành cốt lõi tập trung vào việc phát triển các thuật toán có khả năng tự học quy luật từ dữ liệu mà không cần phải lập trình cứng từng quy tắc. Tiếp theo, Học sâu (Deep Learning - DL) là tập con của Machine Learning sử dụng các mạng nơ-ron nhiều lớp để tự động trích xuất các đặc trưng phức tạp từ dữ liệu thô như hình ảnh, âm thanh và văn bản.
Nhiều người mới bắt đầu thường mắc sai lầm nghiêm trọng: nhảy ngay vào các mô hình phức tạp như Transformer, Stable Diffusion hoặc gọi các API có sẵn mà chưa hiểu bản chất của một hàm mất mát hay một bước cập nhật trọng số đơn giản. Hệ quả là khi mô hình gặp lỗi quá khớp (overfitting), dữ liệu bị trôi (data drift) hoặc kết quả dự đoán sai lệch, họ hoàn toàn bất lực vì thiếu nền tảng suy luận. Một lộ trình học chuẩn mực đòi hỏi sự kiên nhẫn đi qua từng tầng kiến thức từ gốc rễ toán học đến kỹ năng thực chiến.
Hành trình chinh phục AI không phải là một cuộc chạy nước rút trong vài tuần, mà là một quá trình tích lũy kiến thức có hệ thống. Khi bạn hiểu rõ từng viên gạch nền móng, bạn sẽ có khả năng tự đọc các bài báo nghiên cứu khoa học mới nhất, tự debug các lỗi khó hiểu trong quá trình huấn luyện và tùy biến kiến trúc mô hình cho các bài toán đặc thù của doanh nghiệp.
Giai đoạn 1: Toán học nền tảng và lập trình Python
Không có cỗ máy AI nào có thể hoạt động mà thiếu đi ngôn ngữ toán học. Toán học trong Machine Learning không phải là việc giải các bài toán đố phức tạp trên giấy, mà là công cụ để mô hình hóa thế giới thực thành các vector, ma trận và không gian xác suất:
1. Đại số tuyến tính (Linear Algebra)
- Vector và Ma trận: Cách biểu diễn tập dữ liệu \(N\) mẫu với \(D\) đặc trưng dưới dạng ma trận \(X \in \mathbb{R}^{N \times D}\). Mỗi hàng là một quan sát thực tế và mỗi cột đại diện cho một thuộc tính đo lường được.
- Phép nhân ma trận, chuyển vị, ma trận nghịch đảo và định thức. Bạn cần hiểu tại sao phép nhân ma trận lại tương ứng với một phép biến đổi hình học (xoay, co giãn, phản chiếu) trong không gian nhiều chiều.
- Trị riêng và Vector riêng (Eigenvalues & Eigenvectors): Nền tảng cho thuật toán giảm chiều dữ liệu PCA (Principal Component Analysis) và phân tích phổ trong xử lý đồ thị.
- Tích vô hướng (Dot Product) và các chuẩn khoảng cách: Đo lường độ tương đồng ngữ nghĩa giữa các vector đặc trưng (Cosine Similarity) hay khoảng cách vật lý (Euclidean Distance).
2. Giải tích vi phân đa biến (Multivariate Calculus)
- Đạo hàm riêng và Gradient \(\nabla f\): Hướng dốc nhất của hàm số trên không gian nhiều chiều, chỉ dẫn cho các thuật toán tối ưu biết phải thay đổi tham số theo hướng nào để giảm sai số.
- Ma trận Jacobian và Hessian: Chứa thông tin về đạo hàm bậc nhất và bậc hai, giúp xác định độ cong của bề mặt hàm mất mát và hỗ trợ các thuật toán tối ưu hóa bậc hai như Newton-Raphson hay XGBoost.
- Quy tắc chuỗi (Chain Rule): Linh hồn của thuật toán lan truyền ngược (Backpropagation) trong mạng nơ-ron nhân tạo, cho phép tính đạo hàm của hàm hợp qua hàng chục tầng ẩn liên tiếp.
- Khái niệm về hàm lồi (Convex Function) và điểm cực tiểu toàn cục, giúp phân biệt bài toán có nghiệm tối ưu duy nhất với bài toán có nhiều cực tiểu địa phương.
3. Xác suất và Thống kê (Probability & Statistics)
- Biến ngẫu nhiên, hàm mật độ xác suất và các phân phối phổ biến (Gaussian / Normal, Bernoulli, Poisson). Hầu hết các giả định về nhiễu trong học máy đều bắt nguồn từ phân phối chuẩn Gaussian.
- Kỳ vọng (Mean), Phương sai (Variance), Độ lệch chuẩn (Standard Deviation) và Hiệp phương sai (Covariance) để đo lường mức độ phân tán và mối tương quan giữa các biến.
- Định lý Bayes và xác suất có điều kiện: Nền tảng của bộ phân loại Naive Bayes và lý thuyết quyết định xác suất trong điều kiện bất định.
- Ước lượng hợp lý cực đại (Maximum Likelihood Estimation - MLE) và Maximum A Posteriori (MAP): Hai trụ cột tư duy để thiết lập các hàm mất mát kinh điển như MSE hay Cross-Entropy.
Song song với toán, bạn cần thành thạo ngôn ngữ lập trình Python 3. Python là tiêu chuẩn thực tế của ngành AI nhờ hệ sinh thái thư viện khoa học dữ liệu vô cùng đồ sộ. Hãy tập trung làm chủ:
- Thư viện NumPy: Thao tác mảng nhiều chiều với tốc độ C, kỹ thuật phát sóng (Broadcasting) và vector hóa tính toán (Vectorization) để tránh hoàn toàn các vòng lặp
forchậm chạp. - Thư viện Pandas: Xử lý bảng dữ liệu (DataFrames), tiền xử lý và làm sạch dữ liệu khuyết, lọc dữ liệu ngoại lai, nối bảng và biến đổi đặc trưng theo nhóm.
- Thư viện Matplotlib & Seaborn: Vẽ đồ thị phân phối, biểu đồ hộp (Boxplot), ma trận tương quan và trực quan hóa dữ liệu trực tiếp trên biểu đồ để khám phá dữ liệu (EDA).
Giai đoạn 2: Học máy cổ điển (Classical Machine Learning)
Sau khi nắm vững công cụ và toán học, bạn bước vào thế giới của các thuật toán học máy cổ điển. Đây là bước đệm tối quan trọng giúp bạn hình thành trực giác về cách một mô hình học tập, đánh giá và tối ưu:
1. Học có giám sát (Supervised Learning)
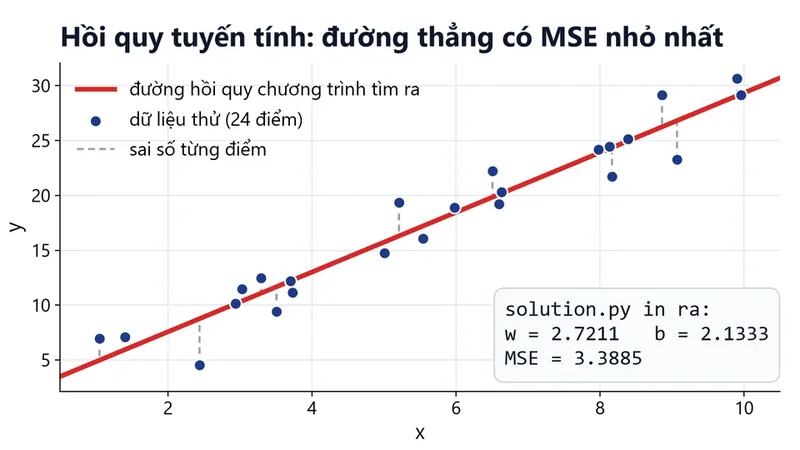
- Hồi quy (Regression): Dự đoán giá trị liên tục. Bắt đầu với Hồi quy tuyến tính (Linear Regression), hàm mất mát sai số toàn phương trung bình (MSE), công thức nghiệm đóng Normal Equation và phương pháp Gradient Descent. Tìm hiểu hồi quy đa thức để nắm bắt quan hệ phi tuyến.
- Phân loại (Classification): Dự đoán nhãn rời rạc. Hồi quy Logistic (Logistic Regression) sử dụng hàm Sigmoid và Log Loss, phân loại nhiều lớp với Softmax, K láng giềng gần nhất (KNN), Cây quyết định (Decision Tree) với chỉ số Gini Impurity và Entropy.
- Mô hình kết hợp (Ensemble Learning): Random Forest áp dụng cơ chế đóng bao (Bagging) và giảm phương sai; Gradient Boosting (GBDT), XGBoost, LightGBM áp dụng cơ chế học tuần tự từ sai số thặng dư để thống trị các bảng xếp hạng dữ liệu dạng bảng.
- Máy vector hỗ trợ (SVM): Tìm siêu phẳng phân cách có khoảng cách lề lớn nhất (Maximal Margin) kết hợp hàm nhân Kernel Trick để giải quyết bài toán phi tuyến trong không gian nhiều chiều.
2. Học không giám sát (Unsupervised Learning)
- Phân cụm (Clustering): Thuật toán K-Means phân chia cụm theo tâm cụm, phân cụm phân cấp (Hierarchical Clustering), phân cụm dựa trên mật độ DBSCAN để tìm kiếm các nhóm tự nhiên trong dữ liệu không nhãn.
- Giảm chiều dữ liệu (Dimensionality Reduction): Phân tích thành phần chính (PCA) giúp nén không gian nhiều chiều về 2D/3D để trực quan hóa hoặc loại bỏ hiện tượng đa cộng tuyến giữa các biến.
3. Đánh giá và xác thực mô hình
- Kỹ thuật kiểm định chéo K-Fold Cross-Validation để đánh giá độ ổn định của mô hình.
- Phân biệt hiện tượng Overfitting (quá khớp) và Underfitting (chưa khớp) thông qua sự đánh đổi giữa Độ chệch (Bias) và Phương sai (Variance).
- Kỹ thuật điều chuẩn Regularization: L1 Lasso (triệt tiêu trọng số về 0, tự động chọn lọc đặc trưng) và L2 Ridge (thu nhỏ trọng số đều về gần 0, chống biến động số học).
- Các chỉ số đo lường hiệu năng: Accuracy, Precision, Recall, F1-Score, ROC-AUC cho bài toán phân loại; MAE, MSE, RMSE, R² cho bài toán hồi quy.
Chủ đề này nằm trong Lecture 01 - Data Preprocess and Visualization của Khóa AI. Xem đề cương
Giai đoạn 3: Deep Learning và Mạng nơ-ron nhân tạo
Khi khối lượng dữ liệu bùng nổ và bài toán chuyển sang dữ liệu phi cấu trúc (hình ảnh, âm thanh, văn bản), các thuật toán cổ điển dần bộc lộ giới hạn vì phụ thuộc quá nhiều vào việc chế tác đặc trưng thủ công (Manual Feature Engineering). Đây là lúc Deep Learning phát huy sức mạnh vượt trội nhờ khả năng tự động học biểu diễn đặc trưng phân cấp:
1. Mạng nơ-ron cơ bản (Multilayer Perceptron (MLP))
- Cấu trúc tầng đầu vào (Input Layer), các tầng ẩn (Hidden Layers) và tầng đầu ra (Output Layer).
- Các hàm kích hoạt phi tuyến (ReLU, Sigmoid, Tanh, GELU) giúp mạng có khả năng xấp xỉ bất kỳ hàm số phức tạp nào (Universal Approximation Theorem).
- Thuật toán lan truyền xuôi (Forward Propagation) để tính toán đầu ra và lan truyền ngược (Backpropagation) tính gradient theo từng trọng số dựa trên quy tắc chuỗi.
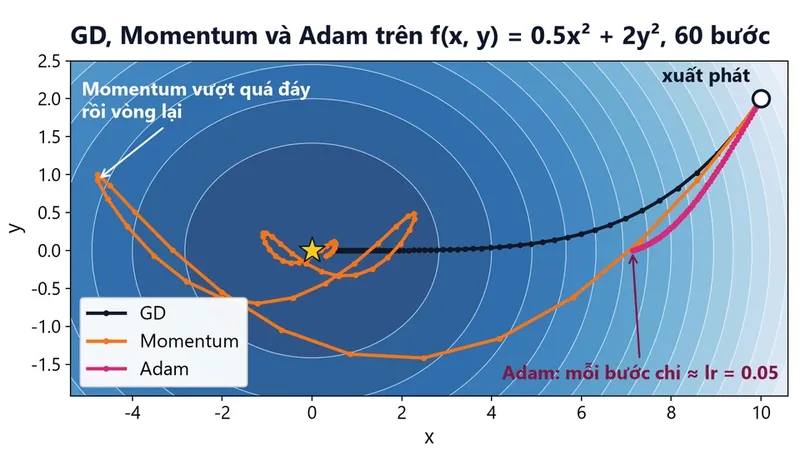
- Các bộ tối ưu hóa hiện đại: SGD with Momentum, RMSprop, Adam, AdamW và chiến lược giảm tốc độ học (Learning Rate Scheduler).
- Kỹ thuật điều chuẩn riêng cho mạng sâu: Dropout ngẫu nhiên ngắt kết nối nơ-ron và Batch Normalization ổn định phân phối dữ liệu đầu vào qua từng tầng.
2. Thị giác máy tính với Mạng nơ-ron tích chập (CNN)
- Phép tích chập 2D (Convolution), lớp gộp mẫu (Pooling), đệm viền (Padding) và bước nhảy (Stride). Cách mạng nơ-ron tích chập trích xuất các đặc trưng biên cạnh ở tầng nông và các hình khối phức tạp ở tầng sâu.
- Các kiến trúc kinh điển: AlexNet, VGG, ResNet (với liên kết tắt Residual Connection giải quyết triệt để vấn đề mất mát gradient khi mạng sâu hàng trăm tầng), EfficientNet.
- Các bài toán ứng dụng: Phân loại ảnh (Image Classification), Phát hiện vật thể (Object Detection với YOLO), Phân vùng ảnh (Segmentation với U-Net).
3. Xử lý chuỗi và Ngôn ngữ tự nhiên với RNN & LSTM
- Mạng nơ-ron hồi quy (Recurrent Neural Networks - RNN) xử lý dữ liệu chuỗi có tính thứ tự và phụ thuộc thời gian.
- Bộ nhớ ngắn dài (Long Short-Term Memory - LSTM) và GRU với cơ chế cổng (Gates) giải quyết vấn đề triệt tiêu gradient trên chuỗi văn bản dài.
- Biểu diễn từ ngữ trong không gian vector (Word Embeddings): Word2Vec, GloVe, FastText nắm bắt mối quan hệ ngữ nghĩa giữa các từ ngữ.
4. Framework học sâu
- Làm chủ PyTorch: Framework linh hoạt, đồ thị tính toán động (Dynamic Computation Graph), thân thiện với nghiên cứu và triển khai công nghiệp. Bạn cần nắm vững cách định nghĩa
nn.Module, viết vòng lặp huấn luyệntrain_loop, xử lý dữ liệu vớiDatasetvàDataLoader, cùng kỹ thuật huấn luyện trên GPU với CUDA.
Giai đoạn 4: Kỷ nguyên GenAI, Large Language Models và MLOps
Từ năm 2023 đến nay, AI đã bước sang một kỷ nguyên mới với sự thống trị của các mô hình nền tảng (Foundation Models) và Trí tuệ nhân tạo tạo sinh:
1. Kiến trúc Transformer
- Cơ chế tự chú ý (Self-Attention Mechanism) và Multi-Head Attention: Cho phép mô hình nhìn thấy mối liên hệ giữa mọi từ trong câu mà không bị giới hạn tuần tự như RNN.
- Mã hóa vị trí (Positional Encoding) để bổ sung thông tin thứ tự từ và cấu trúc chuẩn Encoder-Decoder.
- Các mô hình họ Encoder (BERT, RoBERTa) cho bài toán phân loại và trích xuất thông tin, họ Decoder (GPT, Llama, Claude, Gemini) cho bài toán sinh ngôn ngữ tự nhiên.
2. Kỹ thuật ứng dụng Large Language Models (LLMs)
- Prompt Engineering: Kỹ thuật Zero-shot, Few-shot, Chain-of-Thought (CoT) để điều hướng mô hình tạo câu trả lời chính xác, suy luận từng bước logic.
- Retrieval-Augmented Generation (RAG): Kết hợp mô hình ngôn ngữ lớn với cơ sở dữ liệu vector (Vector Database như Chroma, Pinecone, Milvus, Qdrant) để truy xuất dữ liệu doanh nghiệp chính xác, giảm thiểu triệt để hiện tượng bịa thông tin (Hallucination).
- Tinh chỉnh mô hình (Fine-tuning): Các kỹ thuật Parameter-Efficient Fine-Tuning (PEFT) như LoRA, QLoRA giúp huấn luyện lại mô hình hàng tỷ tham số trên một máy tính cá nhân có GPU phổ thông.
- AI Agents: Xây dựng hệ thống tác tử tự động lập kế hoạch, sử dụng công cụ (Tool Use / Function Calling) và tương tác môi trường qua LangChain hoặc LlamaIndex.
3. Vận hành mô hình Machine Learning (MLOps)
- Quản lý thử nghiệm và theo dõi siêu tham số với MLflow hoặc Weights & Biases.
- Đóng gói mô hình thành dịch vụ API hiệu năng cao với FastAPI và Docker.
- Giám sát chất lượng mô hình trên môi trường production, phát hiện trôi dạt dữ liệu (Data Drift) và trôi dạt khái niệm (Concept Drift) để kích hoạt cơ chế tự động huấn luyện lại (Continuous Training).
Cài đặt Pipeline mẫu hoàn chỉnh
Dưới đây là một chương trình minh họa quy trình học máy hoàn chỉnh: tiếp nhận tập dữ liệu huấn luyện, tiền xử lý tính giá trị trung bình, tối ưu hàm mục tiêu hồi quy bằng phương pháp bình phương tối thiểu, tính sai số tuyệt đối trung bình (MAE) trên chính tập huấn luyện, rồi dự đoán cho các điểm truy vấn mới (các điểm này không có nhãn nên chương trình không đo được MAE trên tập kiểm thử).
# Pipeline Machine Learning co ban: Tien xu ly va Hoi quy tuyen tinh
import sys

def main():
    input_data = sys.stdin.read().split()
    if not input_data:
        return
    it = iter(input_data)
    n = int(next(it))
    xs = []
    ys = []
    for _ in range(n):
        xs.append(float(next(it)))
        ys.append(float(next(it)))

    q = int(next(it))
    q_xs = [float(next(it)) for _ in range(q)]

    # Tinh trung binh
    mean_x = sum(xs) / n
    mean_y = sum(ys) / n

    # Tinh he so w va b: y = w * x + b
    num = sum((xs[i] - mean_x) * (ys[i] - mean_y) for i in range(n))
    den = sum((xs[i] - mean_x) ** 2 for i in range(n))

    w = num / den if abs(den) > 1e-9 else 0.0
    b = mean_y - w * mean_x

    # Tinh MAE tren tap huan luyen
    mae = sum(abs((w * xs[i] + b) - ys[i]) for i in range(n)) / n

    print(f"w={w:.4f} b={b:.4f} MAE={mae:.4f}")
    for qx in q_xs:
        pred = w * qx + b
        print(f"{pred:.4f}")

if __name__ == "__main__":
    main()
#include <iostream>
#include <vector>
#include <cmath>
#include <iomanip>
#include <numeric>

using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n;
    if (!(cin >> n)) return 0;
    vector<double> xs(n), ys(n);
    for (int i = 0; i < n; ++i) {
        cin >> xs[i] >> ys[i];
    }
    int q;
    cin >> q;
    vector<double> q_xs(q);
    for (int i = 0; i < q; ++i) {
        cin >> q_xs[i];
    }

    double sum_x = 0, sum_y = 0;
    for (int i = 0; i < n; ++i) {
        sum_x += xs[i];
        sum_y += ys[i];
    }
    double mean_x = sum_x / n;
    double mean_y = sum_y / n;

    double num = 0, den = 0;
    for (int i = 0; i < n; ++i) {
        num += (xs[i] - mean_x) * (ys[i] - mean_y);
        den += (xs[i] - mean_x) * (xs[i] - mean_x);
    }
    double w = (abs(den) > 1e-9) ? (num / den) : 0.0;
    double b = mean_y - w * mean_x;

    double mae = 0;
    for (int i = 0; i < n; ++i) {
        mae += abs((w * xs[i] + b) - ys[i]);
    }
    mae /= n;

    cout << fixed << setprecision(4);
    cout << "w=" << w << " b=" << b << " MAE=" << mae << "\n";
    for (int i = 0; i < q; ++i) {
        double pred = w * q_xs[i] + b;
        cout << pred << "\n";
    }
    return 0;
}
Lời khuyên vàng để không bỏ cuộc
- Học đi đôi với làm dự án (Project-based Learning): Đừng chỉ xem video lý thuyết suông. Sau mỗi thuật toán, hãy tự viết lại bằng code Python thuần không dùng thư viện, sau đó tạo một notebook phân tích trên dữ liệu thực tế từ Kaggle hoặc UCI Machine Learning Repository.
- Xây dựng Portfolio trên GitHub: Tạo các kho lưu trữ mã nguồn sạch sẽ, có file README giải thích bài toán, kiến trúc mô hình, biểu đồ trực quan hóa và bảng so sánh kết quả đạt được. Đây là minh chứng rõ ràng và thuyết phục nhất cho năng lực thực tế của bạn khi ứng tuyển việc làm.
- Đọc tài liệu gốc: Tập thói quen đọc tài liệu chính thức (official documentation) của NumPy, scikit-learn, PyTorch và các bài báo khoa học (papers) nền tảng trên arXiv để hiểu sâu ngọn nguồn thuật toán thay vì chỉ đọc các bài tóm tắt hời hợt.
- Bẫy gọi hàm black-box: Nhập dữ liệu rồi gọi ngay
model.fit()vàmodel.predict()mà không hiểu ý nghĩa siêu tham số và giả định toán học phía sau. Khi mô hình hoạt động kém, bạn sẽ hoàn toàn không biết cách điều chỉnh. - Quên chuẩn hóa dữ liệu: Các mô hình dựa trên khoảng cách (KNN, SVM, K-Means) hoặc tối ưu bằng Gradient Descent sẽ hoạt động rất kém nếu các đặc trưng có thang đo chênh lệch lớn (ví dụ tuổi tác so với thu nhập).
- Rò rỉ dữ liệu (Data Leakage): Tính toán giá trị chuẩn hóa (mean, std) trên toàn bộ tập dữ liệu trước khi chia tập train/test. Luôn luôn tính toán chỉ số chỉ dựa trên tập huấn luyện, sau đó áp dụng biến đổi đó lên tập kiểm thử!
Câu hỏi thường gặp
Học AI có bắt buộc phải giỏi toán xuất sắc không?
Bạn không cần phải là một nhà toán học nghiên cứu chuyên sâu, nhưng bạn bắt buộc phải hiểu bản chất hình học và đại số của vector, ma trận, đạo hàm và xác suất thống kê. Hiểu toán giúp bạn biết vì sao mô hình hội tụ chậm, vì sao xảy ra overfitting và chọn đúng hàm mất mát cho bài toán thực tế.
Nên bắt đầu với PyTorch hay TensorFlow?
Hiện nay PyTorch là tiêu chuẩn số một trong cả giới nghiên cứu học thuật lẫn các công ty công nghệ lớn nhờ tính linh hoạt, cú pháp Pythonic tự nhiên và hệ sinh thái thư viện phong phú. Trừ khi công ty của bạn có hệ thống cũ viết bằng TensorFlow, bạn nên chọn PyTorch.
Mất bao lâu để tự học từ người mới đến khi đi làm được?
Với người đã có nền tảng lập trình cơ bản và dành khoảng 15-20 giờ mỗi tuần, lộ trình thông thường mất từ 6 đến 9 tháng để làm chủ học máy cổ điển và deep learning cơ bản, đủ khả năng ứng tuyển vị trí AI Engineer hoặc Data Scientist ở mức khởi điểm.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.