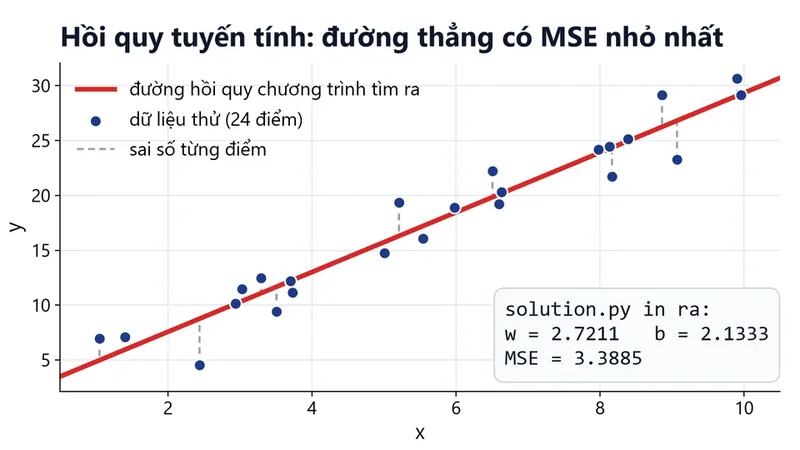
- Ý tưởng cốt lõi: Gradient Descent di chuyển từng bước ngược hướng với vector gradient \(\nabla J(\theta)\) để hạ thấp giá trị hàm mất mát.
- 3 dạng cơ bản: Batch Gradient Descent (chậm nhưng ổn định), Stochastic Gradient Descent (nhanh nhưng dao động lớn), Mini-batch Gradient Descent (kết hợp hài hòa cả hai).
- Các cải tiến thích nghi: Momentum (bổ sung quán tính vượt thung lũng), RMSprop (tự co giãn tốc độ học từng chiều), Adam (kết hợp tinh hoa của cả Momentum và RMSprop).
- Siêu tham số quyết định: Tốc độ học \(\alpha\) (learning rate) là yếu tố quyết định mô hình có hội tụ thành công hay bị bùng nổ phân kỳ.
Gradient Descent là gì?
Hãy hình dung bạn đang bị bịt mắt đứng trên đỉnh một ngọn núi mù sương và nhiệm vụ của bạn là tìm đường xuống điểm sâu nhất của thung lũng. Cách tự nhiên nhất bạn có thể làm là dùng chân cảm nhận độ dốc của mặt đất xung quanh, xác định hướng dốc xuống nhanh nhất và bước một bước nhỏ về hướng đó. Lặp lại quá trình này liên tục, bạn sẽ dần dần tiến về đáy thung lũng.
Đó chính là nguyên lý vận hành của Gradient Descent (Phương pháp hạ gradient). Trong Machine Learning, độ cao của ngọn núi chính là giá trị của hàm mất mát \(J(\theta)\), vị trí của bạn là bộ tham số mô hình \(\theta = (w, b)\), và hướng dốc nhất chính là vector Gradient \(\nabla J(\theta)\).
Thuật toán Gradient Descent xuất hiện ở khắp mọi nơi trong khoa học máy tính hiện đại: từ hồi quy tuyến tính đơn giản, hồi quy logistic, mạng nơ-ron tích chập (CNN), cho đến các mô hình ngôn ngữ lớn (LLMs) hàng trăm tỷ tham số. Bất kể bài toán có quy mô lớn đến đâu, nguyên lý cốt lõi vẫn không thay đổi: tính toán gradient sai số và dịch chuyển trọng số ngược hướng dốc để giảm thiểu tổn thất.
Ba biến thể cơ bản của Gradient Descent
Tùy thuộc vào lượng dữ liệu được nạp vào để tính toán gradient ở mỗi bước lặp, chúng ta phân biệt 3 biến thể cơ bản:
1. Batch Gradient Descent (BGD)
Ở mỗi bước lặp, thuật toán duyệt qua toàn bộ \(N\) mẫu của tập huấn luyện để tính gradient chính xác:
\[\theta := \theta - \alpha \frac{1}{N} \sum_{i=1}^N \nabla J(\theta; x_i, y_i)\]
- Ưu điểm: Quỹ đạo di chuyển mượt mà, hội tụ ổn định và chắc chắn tới cực tiểu toàn cục đối với hàm lồi.
- Nhược điểm: Cực kỳ chậm chạp khi dữ liệu lớn hàng triệu mẫu; đòi hỏi toàn bộ dữ liệu phải vừa vặn trong bộ nhớ RAM; không thể vừa huấn luyện vừa nạp dữ liệu trực tuyến (online learning).
2. Stochastic Gradient Descent (SGD)
Ở mỗi bước lặp, thuật toán chỉ lấy ngẫu nhiên đúng 1 mẫu \((x_i, y_i)\) duy nhất để tính gradient và cập nhật trọng số ngay lập tức:
\[\theta := \theta - \alpha \nabla J(\theta; x_i, y_i)\]
- Ưu điểm: Tính toán cực nhanh, tốn rất ít bộ nhớ RAM. Tính dao động ngẫu nhiên mạnh giúp mô hình có cơ hội thoát khỏi các điểm cực tiểu cục bộ nông.
- Nhược điểm: Quỹ đạo di chuyển hình ziczac hỗn loạn, không bao giờ thực sự đứng yên ở điểm đáy mà liên tục dao động xung quanh cực tiểu, đòi hỏi phải giảm dần learning rate theo thời gian.
3. Mini-batch Gradient Descent
Giải pháp cân bằng hoàn hảo: chia tập dữ liệu thành các lô nhỏ (mini-batch) có kích thước điển hình \(B \in \{32, 64, 128, 256, 512\}\) mẫu:
\[\theta := \theta - \alpha \frac{1}{B} \sum_{i=1}^B \nabla J(\theta; x_i, y_i)\]
Đây là phương pháp tiêu chuẩn được sử dụng trong toàn bộ các framework học sâu hiện đại nhờ tận dụng tối đa khả năng tính toán ma trận song song của GPU.
Các bộ tối ưu hóa thích nghi nâng cao
Trong các mạng nơ-ron học sâu, bề mặt hàm mất mát cực kỳ phức tạp với hàng triệu tham số, chứa nhiều điểm yên ngựa (saddle points) và thung lũng hẹp dốc đứng một chiều nhưng lại cực kỳ thoai thoải ở chiều còn lại (ravines). SGD thông thường sẽ bị dao động dữ dội qua lại giữa hai vách thung lũng mà tiến rất chậm về phía đáy. Các thuật toán nâng cao ra đời để khắc phục nhược điểm này:
1. Gradient Descent with Momentum
Lấy cảm hứng từ vật lý: một quả cầu lăn xuống dốc sẽ tích lũy động lượng (quán tính) để tiếp tục lăn nhanh theo hướng cũ và ít bị chao đảo bởi các gờ đá nhỏ. Thuật toán duy trì một vector vận tốc \(v\):
\[v := \beta v + \alpha \nabla J(\theta)\]
\[\theta := \theta - v\]
Hệ số suy giảm quán tính \(\beta\) thường được chọn là \(0.9\). Nhờ có \(v\), các dao động ngược chiều nhau bị triệt tiêu dần, trong khi vận tốc theo hướng dốc dài được cộng dồn tăng tốc mạnh mẽ.
2. RMSprop (Root Mean Square Propagation)
Được đề xuất bởi Geoffrey Hinton, RMSprop giải quyết vấn đề điều chỉnh tốc độ học riêng biệt cho từng tham số. Nó duy trì trung bình trượt có trọng số của bình phương gradient:
\[s := \beta s + (1 - \beta) (\nabla J(\theta))^2\]
\[\theta := \theta - \frac{\alpha}{\sqrt{s + \epsilon}} \odot \nabla J(\theta)\]
Với chiều nào có gradient liên tục quá lớn, \(s\) sẽ lớn khiến tốc độ học hiệu dụng bị chia nhỏ lại, dập tắt dao động. Ngược lại, chiều nào có gradient thoai thoải, \(s\) nhỏ sẽ giúp bước nhảy được phóng to lên.
3. Adam (Adaptive Moment Estimation)
Adam là sự kết hợp hoàn hảo giữa Momentum (ước lượng kỳ vọng bậc 1) và RMSprop (ước lượng phương sai bậc 2), bổ sung thêm cơ chế hiệu chỉnh độ chệch ban đầu (bias correction):
\[m_t = \beta_1 m_{t-1} + (1 - \beta_1) g_t\]
\[v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2\]
\[\hat{m}_t = \frac{m_t}{1 - \beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1 - \beta_2^t}\]
\[\theta := \theta - \frac{\alpha}{\sqrt{\hat{v}_t} + \epsilon} \hat{m}_t\]
Các giá trị siêu tham số mặc định được kiểm chứng thực nghiệm cực tốt: \(\alpha = 0.001\), \(\beta_1 = 0.9\), \(\beta_2 = 0.999\), \(\epsilon = 10^{-8}\).
Kỹ thuật Learning Rate Scheduling và Khởi tạo Trọng số
Một vấn đề sống còn khi áp dụng Gradient Descent trên các mô hình phức tạp là điều khiển tốc độ học (Learning Rate Scheduling). Tốc độ học cố định rất khó cân bằng giữa hai giai đoạn: khám phá nhanh ở đầu khóa huấn luyện và hội tụ chính xác ở giai đoạn cuối:
- Step Decay: Giảm tốc độ học một nửa sau mỗi số lượng epoch nhất định khi hàm mất mát trên tập kiểm định chững lại.
- Cosine Annealing: Hạ dần tốc độ học theo đồ thị hàm cosin, giúp mô hình trượt êm ái vào các lòng chảo sâu nhất của không gian tham số.
- Warmup: Ở những vòng lặp đầu tiên, khởi động với tốc độ học rất nhỏ rồi tăng dần lên mức chuẩn trước khi giảm dần. Kỹ thuật này ngăn chặn các gradient ban đầu làm lệch hướng hoàn toàn các trọng số mới khởi tạo.
- Khởi tạo trọng số (Weight Initialization): Nếu khởi tạo toàn bộ trọng số bằng 0, mọi nơ-ron hoặc đặc trưng sẽ cập nhật đối xứng hoàn toàn giống nhau. Sử dụng các kỹ thuật như He Initialization hoặc Xavier/Glorot Initialization giúp phương sai của tín hiệu truyền đi ổn định qua từng tầng tính toán.
Chủ đề này nằm trong Lecture 05 - Gradient Descent của Khóa AI. Xem đề cương
Cài đặt mô phỏng so sánh thuật toán
Dưới đây là mã nguồn cài đặt và đối chiếu trực tiếp hành vi tối ưu của Gradient Descent thường (GD: dùng gradient chính xác của hàm, không lấy mẫu dữ liệu nên không phải SGD), Momentum và Adam trên cùng một bài toán tối ưu hàm mất mát bậc hai bằng cả Python và C++17.
# So sanh Gradient Descent (GD), Momentum va Adam tren ham loi f(x, y) = a*x^2 + b*y^2
# Ham co gradient chinh xac, khong lay mau du lieu, nen buoc co ban la GD (khong phai SGD)
import sys
import math

def grad_f(x, y, a, b):
    # f(x, y) = a * x^2 + b * y^2
    # grad = (2 * a * x, 2 * b * y)
    return 2.0 * a * x, 2.0 * b * y

def solve_gd(x0, y0, a, b, lr, steps):
    x, y = x0, y0
    for _ in range(steps):
        gx, gy = grad_f(x, y, a, b)
        x -= lr * gx
        y -= lr * gy
    return x, y

def solve_momentum(x0, y0, a, b, lr, beta, steps):
    x, y = x0, y0
    vx, vy = 0.0, 0.0
    for _ in range(steps):
        gx, gy = grad_f(x, y, a, b)
        vx = beta * vx + lr * gx
        vy = beta * vy + lr * gy
        x -= vx
        y -= vy
    return x, y

def solve_adam(x0, y0, a, b, lr, beta1, beta2, eps, steps):
    x, y = x0, y0
    m_x, m_y = 0.0, 0.0
    v_x, v_y = 0.0, 0.0
    for t in range(1, steps + 1):
        gx, gy = grad_f(x, y, a, b)
        m_x = beta1 * m_x + (1.0 - beta1) * gx
        m_y = beta1 * m_y + (1.0 - beta1) * gy
        v_x = beta2 * v_x + (1.0 - beta2) * (gx ** 2)
        v_y = beta2 * v_y + (1.0 - beta2) * (gy ** 2)
        m_x_hat = m_x / (1.0 - (beta1 ** t))
        m_y_hat = m_y / (1.0 - (beta1 ** t))
        v_x_hat = v_x / (1.0 - (beta2 ** t))
        v_y_hat = v_y / (1.0 - (beta2 ** t))
        x -= lr * m_x_hat / (math.sqrt(v_x_hat) + eps)
        y -= lr * m_y_hat / (math.sqrt(v_y_hat) + eps)
    return x, y

def main():
    data = sys.stdin.read().split()
    if not data:
        return
    it = iter(data)
    x0 = float(next(it))
    y0 = float(next(it))
    a = float(next(it))
    b = float(next(it))
    steps = int(next(it))

    lr = 0.05
    beta_mom = 0.9
    beta1, beta2, eps = 0.9, 0.999, 1e-8

    gd_x, gd_y = solve_gd(x0, y0, a, b, lr, steps)
    mx, my = solve_momentum(x0, y0, a, b, lr, beta_mom, steps)
    ax, ay = solve_adam(x0, y0, a, b, lr, beta1, beta2, eps, steps)

    print(f"GD: x={gd_x:.4f} y={gd_y:.4f}")
    print(f"Momentum: x={mx:.4f} y={my:.4f}")
    print(f"Adam: x={ax:.4f} y={ay:.4f}")

if __name__ == "__main__":
    main()
#include <iostream>
#include <cmath>
#include <iomanip>

using namespace std;

void grad_f(double x, double y, double a, double b, double &gx, double &gy) {
    gx = 2.0 * a * x;
    gy = 2.0 * b * y;
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    double x0, y0, a, b;
    int steps;
    if (!(cin >> x0 >> y0 >> a >> b >> steps)) return 0;

    double lr = 0.05;
    double beta_mom = 0.9;
    double beta1 = 0.9, beta2 = 0.999, eps = 1e-8;

    // GD: ham co gradient chinh xac, khong lay mau du lieu (khong phai SGD)
    double sx = x0, sy = y0;
    for (int t = 0; t < steps; ++t) {
        double gx, gy;
        grad_f(sx, sy, a, b, gx, gy);
        sx -= lr * gx;
        sy -= lr * gy;
    }

    // Momentum
    double mx = x0, my = y0;
    double vx = 0, vy = 0;
    for (int t = 0; t < steps; ++t) {
        double gx, gy;
        grad_f(mx, my, a, b, gx, gy);
        vx = beta_mom * vx + lr * gx;
        vy = beta_mom * vy + lr * gy;
        mx -= vx;
        my -= vy;
    }

    // Adam
    double ax = x0, ay = y0;
    double m_x = 0, m_y = 0;
    double v_x = 0, v_y = 0;
    for (int t = 1; t <= steps; ++t) {
        double gx, gy;
        grad_f(ax, ay, a, b, gx, gy);
        m_x = beta1 * m_x + (1.0 - beta1) * gx;
        m_y = beta1 * m_y + (1.0 - beta1) * gy;
        v_x = beta2 * v_x + (1.0 - beta2) * (gx * gx);
        v_y = beta2 * v_y + (1.0 - beta2) * (gy * gy);
        double m_x_hat = m_x / (1.0 - pow(beta1, t));
        double m_y_hat = m_y / (1.0 - pow(beta1, t));
        double v_x_hat = v_x / (1.0 - pow(beta2, t));
        double v_y_hat = v_y / (1.0 - pow(beta2, t));
        ax -= lr * m_x_hat / (sqrt(v_x_hat) + eps);
        ay -= lr * m_y_hat / (sqrt(v_y_hat) + eps);
    }

    cout << fixed << setprecision(4);
    cout << "GD: x=" << sx << " y=" << sy << "\n";
    cout << "Momentum: x=" << mx << " y=" << my << "\n";
    cout << "Adam: x=" << ax << " y=" << ay << "\n";
    return 0;
}
Tầm quan trọng của Learning Rate
Tốc độ học \(\alpha\) (Learning Rate) là siêu tham số quan trọng bậc nhất quyết định sự sống còn của quá trình huấn luyện:
- Tốc độ học quá lớn: Mô hình sẽ bước những bước quá dài vượt qua đáy thung lũng, dẫn đến hiện tượng dao động phân kỳ dữ dội và hàm mất mát nổ ra giá trị vô cùng
NaN. - Tốc độ học quá nhỏ: Mô hình bò về đích quá chậm chạp, mất hàng ngày trời để huấn luyện hoặc bị kẹt mãi mãi tại các vùng cao nguyên phẳng (plateau).
Trong thực tế huấn luyện mô hình lớn, người ta thường áp dụng kỹ thuật Learning Rate Schedule: bắt đầu với bước khởi động (Warm-up) tăng dần lr trong vài epoch đầu, sau đó giảm dần theo đồ thị Cosine Annealing hoặc giảm theo bậc thang khi hàm mất mát chững lại.
- Quên khởi tạo đúng số mũ trong Adam: Nếu bỏ qua bước hiệu chỉnh độ chệch bias correction \(\hat{m} = m / (1 - \beta_1^t)\), trong những bước lặp đầu tiên khi \(m_0 = 0\), vector vận tốc sẽ bị kéo về gần 0 khiến mô hình khởi động cực kỳ chậm chạp.
- Hiện tượng nổ gradient (Exploding Gradients): Khi mạng quá sâu, gradient nhân liên tiếp có thể vọt lên giá trị khổng lồ. Luôn luôn áp dụng kỹ thuật cắt tỉa gradient (Gradient Clipping) để giới hạn chuẩn tối đa của vector đạo hàm.
Câu hỏi thường gặp
Nên chọn bộ tối ưu nào khi bắt đầu một bài toán mới?
Hãy luôn luôn bắt đầu với Adam (hoặc biến thể cải tiến AdamW có điều chuẩn trọng số chuẩn mực) với tốc độ học \(\alpha = 10^{-3}\) hoặc \(3 \times 10^{-4}\). Adam rất bền bỉ với siêu tham số và giúp mô hình hội tụ nhanh chóng.
Tại sao trong các bài thi phân loại ảnh ResNet, người ta vẫn chuộng SGD with Momentum hơn Adam?
Nhiều thực nghiệm chỉ ra rằng dù Adam hội tụ rất nhanh trên tập huấn luyện, nhưng SGD with Momentum lại có xu hướng tìm ra các lòng chảo cực tiểu rộng và phẳng hơn (flat minima), mang lại khả năng tổng quát hóa trên tập kiểm thử (test set) nhỉnh hơn một chút so với Adam.
Điểm yên ngựa (Saddle Point) là gì và vì sao nó nguy hiểm hơn cực tiểu địa phương?
Điểm yên ngựa là điểm mà gradient bằng 0, nhưng nó là cực tiểu theo một chiều và là cực đại theo chiều khác (giống như hình chiếc yên ngựa). Trong không gian hàng triệu chiều của Deep Learning, điểm yên ngựa xuất hiện với tần suất dày đặc gấp hàng ngàn lần cực tiểu địa phương. Bộ tối ưu có Momentum hoặc nhiễu ngẫu nhiên như SGD có thể dễ dàng lăn vượt qua yên ngựa, trong khi Batch GD thuần túy có thể đi rất chậm khi qua vùng gần yên ngựa (dù với khởi tạo ngẫu nhiên, GD hầu như chắc chắn không hội tụ về yên ngựa).
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.