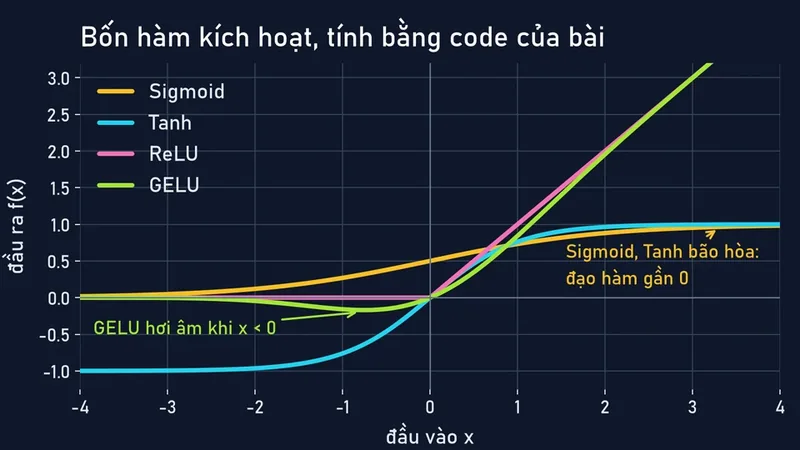
- Kiến trúc 3 tầng cơ bản: Gồm tầng đầu vào (Input), một hoặc nhiều tầng ẩn phi tuyến (Hidden Layer) và tầng đầu ra (Output).
- Lan truyền xuôi (Forward Propagation): Tính toán tuần tự các tích ma trận trọng số \(\mathbf{z} = \mathbf{x} \mathbf{W} + \mathbf{b}\) kết hợp hàm kích hoạt phi tuyến như ReLU và Sigmoid.
- Lan truyền ngược (Backpropagation): Ứng dụng quy tắc dây chuyền (Chain Rule) trong giải tích đa biến để tính đạo hàm riêng của hàm mất mát theo từng trọng số.
- Tối ưu hóa Gradient Descent: Cập nhật trọng số theo hướng ngược chiều gradient: \(\mathbf{W} \leftarrow \mathbf{W} - \alpha \nabla_{\mathbf{W}} \mathcal{L}\) để thu nhỏ sai số dự đoán.
Ngày nay, với sự trợ giúp của các thư viện học sâu cao cấp như PyTorch hay TensorFlow, chỉ cần 4 dòng code là bạn đã có thể định nghĩa và huấn luyện một mạng nơ-ron sâu. Tuy nhiên, việc coi các framework này như một "chiếc hộp đen" (Black box) sẽ khiến các kỹ sư AI gặp bế tắc hoàn toàn khi mô hình gặp lỗi phân kỳ gradient, mất ổn định số học hoặc cần tối ưu hóa hiệu năng biên dịch. Không có bài học nào giúp bạn thấu hiểu bản chất của Deep Learning sâu sắc bằng việc tự tay viết thuật toán Lan truyền ngược (Backpropagation) từ con số 0 chỉ với Python thuần túy và thư viện ma trận NumPy.
1. Cấu trúc của Mạng Nơ-ron Nhân tạo Multi-Layer Perceptron
Một mạng nơ-ron truyền thẳng nhiều tầng (Feedforward Neural Network hay Multi-Layer Perceptron - MLP) bao gồm ít nhất 3 thành phần cơ bản:
- Tầng đầu vào (Input Layer): Chứa \(D\) nơ-ron tương ứng với các chiều đặc trưng của vector đầu vào \(\mathbf{x} \in \mathbb{R}^D\).
- Tầng ẩn (Hidden Layers): Một hoặc nhiều tầng nơ-ron trung gian thực hiện phép biến đổi tuyến tính kết hợp với hàm kích hoạt phi tuyến (Non-linear Activation) để học các biểu diễn đặc trưng trừu tượng.
- Tầng đầu ra (Output Layer): Tạo ra dự đoán cuối cùng \(\hat{y}\) (ví dụ hàm Sigmoid cho phân loại nhị phân hoặc Softmax cho phân loại đa lớp).
Trong bài viết này, chúng ta sẽ xây dựng một mạng nơ-ron 2 tầng kinh điển:
- Tầng vào: \(2\) đặc trưng \(\mathbf{x} = [x_1, x_2]\).
- Tầng ẩn: \(H\) nơ-ron với hàm kích hoạt ReLU \(a(z) = \max(0, z)\).
- Tầng ra: \(1\) nơ-ron với hàm kích hoạt Sigmoid \(\hat{y} = \sigma(z) = \frac{1}{1 + e^{-z}}\).
2. Pha 1: Lan truyền xuôi (Forward Propagation)
Quá trình lan truyền xuôi là chuỗi các phép nhân ma trận và áp dụng hàm phi tuyến tính tuần tự từ trái sang phải:
Bước 1: Tính toán tại tầng ẩn
Nhân vector đầu vào \(\mathbf{x}\) với ma trận trọng số \(\mathbf{W}_1\) kích thước \(D \times H\), sau đó cộng vector độ chệch \(\mathbf{b}_1\): \[\mathbf{z}_1 = \mathbf{x} \mathbf{W}_1 + \mathbf{b}_1\] Áp dụng hàm kích hoạt ReLU lên từng phần tử để tạo ra tín hiệu kích hoạt \(\mathbf{a}_1\): \[\mathbf{a}_1 = \text{ReLU}(\mathbf{z}_1) = \max(0, \mathbf{z}_1)\]
Bước 2: Tính toán tại tầng đầu ra
Tín hiệu \(\mathbf{a}_1\) tiếp tục được truyền qua tầng thứ hai với trọng số \(\mathbf{W}_2\) (kích thước \(H \times 1\)) và bias \(b_2\): \[z_2 = \mathbf{a}_1 \mathbf{W}_2 + b_2\] Đưa qua hàm kích hoạt Sigmoid để tính xác suất dự đoán \(\hat{y} \in (0, 1)\): \[\hat{y} = \sigma(z_2) = \frac{1}{1 + e^{-z_2}}\]
Bước 3: Tính hàm mất mát Binary Cross-Entropy
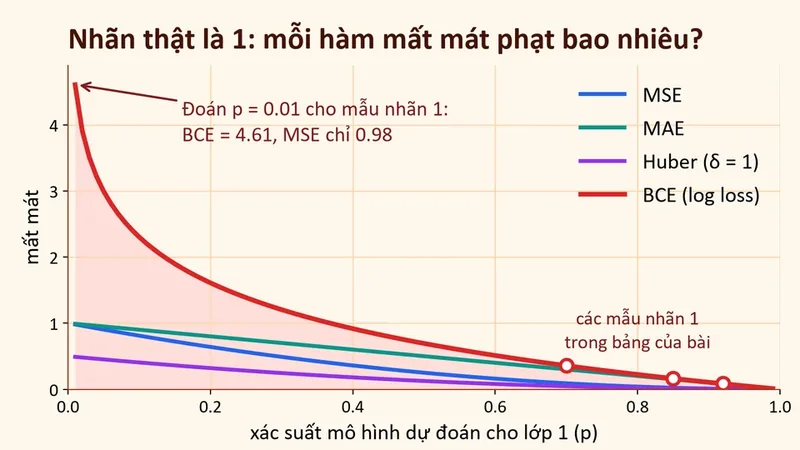
Để đo lường sai số giữa xác suất dự đoán \(\hat{y}\) và nhãn thực tế \(y \in \{0, 1\}\), ta sử dụng hàm mất mát Log Loss (Binary Cross-Entropy): \[\mathcal{L}(y, \hat{y}) = -\left[ y \log(\hat{y}) + (1 - y) \log(1 - \hat{y}) \right]\]
3. Pha 2: Lan truyền ngược (Backpropagation) và Quy tắc Chuỗi
Mục tiêu của quá trình huấn luyện là tìm đạo hàm riêng của hàm mất mát \(\mathcal{L}\) đối với từng tham số trong mạng: \(\frac{\partial \mathcal{L}}{\partial \mathbf{W}_1}, \frac{\partial \mathcal{L}}{\partial \mathbf{b}_1}, \frac{\partial \mathcal{L}}{\partial \mathbf{W}_2}, \frac{\partial \mathcal{L}}{\partial b_2}\).
Nhờ Quy tắc chuỗi (Chain Rule) trong giải tích vi phân, sai số được truyền ngược một cách cực kỳ trang nhã từ tầng ra về tầng vào:
Bước 1: Đạo hàm tại tầng đầu ra
Đạo hàm của hàm mất mát BCE kết hợp với hàm kích hoạt Sigmoid tạo nên một kết quả tối giản kinh điển: \[\delta_2 = \frac{\partial \mathcal{L}}{\partial z_2} = \frac{\partial \mathcal{L}}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial z_2} = \left(-\frac{y}{\hat{y}} + \frac{1-y}{1-\hat{y}}\right) \cdot \left(\hat{y}(1 - \hat{y})\right) = \hat{y} - y\] Sai số tại đầu ra đơn giản chính là hiệu số giữa giá trị dự đoán và nhãn thực tế!
Từ đó, ta có gradient của các tham số tầng 2: \[\frac{\partial \mathcal{L}}{\partial \mathbf{W}_2} = \mathbf{a}_1^T \cdot \delta_2\] \[\frac{\partial \mathcal{L}}{\partial b_2} = \delta_2\]
Bước 2: Truyền sai số ngược về tầng ẩn
Để tính gradient cho tầng 1, trước hết ta truyền sai số \(\delta_2\) qua ma trận trọng số \(\mathbf{W}_2\): \[\frac{\partial \mathcal{L}}{\partial \mathbf{a}_1} = \delta_2 \cdot \mathbf{W}_2^T\] Tiếp tục nhân với đạo hàm của hàm kích hoạt ReLU: \[\delta_1 = \frac{\partial \mathcal{L}}{\partial \mathbf{z}_1} = \frac{\partial \mathcal{L}}{\partial \mathbf{a}_1} \odot \text{ReLU}'(\mathbf{z}_1) = (\delta_2 \cdot \mathbf{W}_2^T) \odot (\mathbf{z}_1 \gt 0)\] Trong đó \(\odot\) là phép nhân từng phần tử (Hadamard product). Đạo hàm ReLU chỉ đơn giản bằng \(1\) nếu giá trị dương và bằng \(0\) nếu giá trị âm.
Cuối cùng, tính gradient cho các tham số tầng 1: \[\frac{\partial \mathcal{L}}{\partial \mathbf{W}_1} = \mathbf{x}^T \cdot \delta_1\] \[\frac{\partial \mathcal{L}}{\partial \mathbf{b}_1} = \delta_1\]
Bước 3: Cập nhật trọng số bằng Gradient Descent
Sau khi tính được toàn bộ gradient, ta cập nhật các tham số theo hướng ngược gradient với tốc độ học \(\alpha\): \[\mathbf{W}_2 \leftarrow \mathbf{W}_2 - \alpha \frac{\partial \mathcal{L}}{\partial \mathbf{W}_2}, \quad b_2 \leftarrow b_2 - \alpha \frac{\partial \mathcal{L}}{\partial b_2}\] \[\mathbf{W}_1 \leftarrow \mathbf{W}_1 - \alpha \frac{\partial \mathcal{L}}{\partial \mathbf{W}_1}, \quad \mathbf{b}_1 \leftarrow \mathbf{b}_1 - \alpha \frac{\partial \mathcal{L}}{\partial \mathbf{b}_1}\]
4. Ví dụ tính toán từng con số cụ thể
Để kiểm chứng tính chính xác của thuật toán, chúng ta xét một ví dụ số học thực tế với mạng có 2 đầu vào, tầng ẩn 2 nơ-ron và 1 đầu ra:
- Đầu vào: \(\mathbf{x} = [0.5, -0.2]\), nhãn thực tế \(y = 1.0\).
- Khởi tạo trọng số tầng 1: \[\mathbf{W}_1 = \begin{bmatrix} 0.2 & -0.4 \\ 0.7 & 0.1 \end{bmatrix}, \quad \mathbf{b}_1 = [0.1, -0.1]\]
- Trọng số tầng 2: \[\mathbf{W}_2 = [0.6, -0.5]^T, \quad b_2 = 0.05\]
Bước 1: Forward Pass
- Tính \(\mathbf{z}_1 = \mathbf{x} \mathbf{W}_1 + \mathbf{b}_1\):
- \(z_{1,0} = 0.5(0.2) + (-0.2)(0.7) + 0.1 = 0.10 - 0.14 + 0.1 = 0.06\).
- \(z_{1,1} = 0.5(-0.4) + (-0.2)(0.1) - 0.1 = -0.20 - 0.02 - 0.1 = -0.32\).
- Áp dụng ReLU:
- \(a_{1,0} = \max(0, 0.06) = 0.06\).
- \(a_{1,1} = \max(0, -0.32) = 0.00\) (Nơ-ron bị tắt do giá trị âm).
- Tính \(z_2 = a_{1,0} W_{2,0} + a_{1,1} W_{2,1} + b_2\):
- \(z_2 = 0.06(0.6) + 0.00(-0.5) + 0.05 = 0.036 + 0.05 = 0.086\).
- Tính đầu ra dự đoán:
- \(\hat{y} = \sigma(0.086) = \frac{1}{1 + e^{-0.086}} \approx 0.5215\).
- Hàm mất mát BCE:
- \(\mathcal{L} = -\log(0.5215) \approx 0.6511\).
Bước 2: Backpropagation
- Sai số đầu ra: \(\delta_2 = \hat{y} - y = 0.5215 - 1.0 = -0.4785\).
- Gradient tầng 2:
- \(\frac{\partial \mathcal{L}}{\partial W_{2,0}} = a_{1,0} \cdot \delta_2 = 0.06 \cdot (-0.4785) \approx -0.0287\).
- \(\frac{\partial \mathcal{L}}{\partial W_{2,1}} = a_{1,1} \cdot \delta_2 = 0.00 \cdot (-0.4785) = 0.0000\).
- Lan truyền ngược về tầng ẩn:
- Tín hiệu lan truyền: \(\delta_2 \cdot \mathbf{W}_2^T = [-0.4785 \times 0.6, -0.4785 \times (-0.5)] = [-0.2871, 0.2393]\).
- Nhân đạo hàm ReLU \(\odot (z_1 \gt 0)\):
- \(\delta_{1,0} = -0.2871 \times 1 = -0.2871\).
- \(\delta_{1,1} = 0.2393 \times 0 = 0.0000\) (Gradient không truyền qua nơ-ron đã tắt).
Chỉ với các phép toán ma trận cơ bản, sai số đã được lan truyền ngược hoàn hảo để sẵn sàng cho bước cập nhật trọng số!
Chủ đề này nằm trong Lecture 14 - Neural Networks của Khóa AI. Xem đề cương
5. Cài đặt mạng MLP bằng Python và C++
Code dưới đây cài đúng các công thức ở mục 2 và 3 bằng NumPy, cho cả \(N\) mẫu một lúc: forward() tính lan truyền xuôi, backward() tính gradient theo quy tắc chuỗi, train() lặp bước cập nhật Gradient Descent. Hàm mất mát là trung bình BCE trên \(N\) mẫu nên mỗi gradient chia thêm cho \(N\); với \(N = 1\) thì đúng bằng các công thức ở mục 3.
Chạy python solution.py, mạng 2 đầu vào, 4 nơ-ron ẩn, 1 đầu ra học hàm XOR, thứ mà một nơ-ron đơn lẻ không học được. Loss giảm từ 0.7742 lúc chưa học xuống 0.0118 sau 500 vòng và 0.0013 sau 3000 vòng. Xác suất dự đoán cho 4 mẫu (0, 0), (0, 1), (1, 0), (1, 1) lần lượt là 0.004, 0.999, 0.999 và dưới 0.001, tức dự đoán [0, 1, 1, 0], đúng bảng XOR. Bản C++17 làm cùng các bước, đọc dữ liệu từ bàn phím theo định dạng ghi ở đầu tệp.
Khi tự viết lại code này, bạn có thể kiểm theo bốn bước như chúng tôi đã kiểm: so số với ví dụ tính tay ở mục 4; so gradient của backward() với gradient tính bằng sai phân hữu hạn (kỹ thuật ở mục 10) trên nhiều mạng khởi tạo ngẫu nhiên, sai số tương đối phải dưới \(10^{-7}\); kiểm mạng học được XOR với vài bộ khởi tạo khác nhau; và so kết quả của hai bản Python, C++ với nhau.
# Mang no-ron MLP 2 tang viet tu dau bang NumPy: lan truyen xuoi, lan truyen nguoc, Gradient Descent.
# Chay: python solution.py  (vi du hoc ham XOR o cuoi tep)
import numpy as np


def relu(z):
    return np.maximum(0.0, z)


def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))


def forward(X, W1, b1, W2, b2):
    # X: (N, D), W1: (D, H), b1: (H,), W2: (H,), b2: so thuc
    z1 = X @ W1 + b1          # (N, H)
    a1 = relu(z1)             # (N, H)
    z2 = a1 @ W2 + b2         # (N,)
    y_hat = sigmoid(z2)       # (N,)
    return z1, a1, y_hat


def bce(y, y_hat, eps=1e-12):
    # Binary Cross-Entropy, lay trung binh tren N mau
    p = np.clip(y_hat, eps, 1.0 - eps)
    return float(-np.mean(y * np.log(p) + (1.0 - y) * np.log(1.0 - p)))


def backward(X, y, z1, a1, y_hat, W2):
    # Cac cong thuc o muc 3. Mat mat la trung binh tren N mau nen moi gradient chia them cho N.
    n = X.shape[0]
    delta2 = (y_hat - y) / n                   # dL/dz2, (N,)
    dW2 = a1.T @ delta2                        # (H,)
    db2 = float(delta2.sum())
    delta1 = np.outer(delta2, W2) * (z1 > 0)   # (N, H): (delta2 . W2^T) nhan ReLU'(z1)
    dW1 = X.T @ delta1                         # (D, H)
    db1 = delta1.sum(axis=0)                   # (H,)
    return dW1, db1, dW2, db2


def train(X, y, W1, b1, W2, b2, lr=0.5, epochs=1000):
    W1, b1, W2 = W1.copy(), b1.copy(), W2.copy()
    for _ in range(epochs):
        z1, a1, y_hat = forward(X, W1, b1, W2, b2)
        dW1, db1, dW2, db2 = backward(X, y, z1, a1, y_hat, W2)
        W1 -= lr * dW1
        b1 -= lr * db1
        W2 -= lr * dW2
        b2 -= lr * db2
    return W1, b1, W2, b2


def solve(case):
    # case = (X, y, W1, b1, W2, b2, lr, epochs): tra ve gradient ban dau, BCE va du doan sau khi huan luyen
    X, y, W1, b1, W2, b2, lr, epochs = case
    X, y = np.array(X, float), np.array(y, float)
    W1, b1, W2 = np.array(W1, float), np.array(b1, float), np.array(W2, float)
    z1, a1, y_hat = forward(X, W1, b1, W2, b2)
    dW1, db1, dW2, db2 = backward(X, y, z1, a1, y_hat, W2)
    grads = [round(float(v), 6) for v in list(dW1.ravel()) + list(db1) + list(dW2) + [db2]]
    W1t, b1t, W2t, b2t = train(X, y, W1, b1, W2, b2, lr, epochs)
    _, _, y_end = forward(X, W1t, b1t, W2t, b2t)
    return grads, round(bce(y, y_end), 6), [int(p >= 0.5) for p in y_end]


if __name__ == "__main__":
    # Hoc ham XOR: 4 mau, tang an 4 no-ron ReLU, khoi tao He (phuong sai 2 / so dau vao cua tang)
    X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
    y = np.array([0, 1, 1, 0], dtype=float)
    rng = np.random.default_rng(0)
    W1, b1 = rng.normal(size=(2, 4)) * np.sqrt(2 / 2), np.zeros(4)
    W2, b2 = rng.normal(size=4) * np.sqrt(2 / 4), 0.0
    print(f"vong 0: loss = {bce(y, forward(X, W1, b1, W2, b2)[2]):.4f}")
    for vong in range(500, 3001, 500):
        W1, b1, W2, b2 = train(X, y, W1, b1, W2, b2, lr=0.5, epochs=500)
        print(f"vong {vong}: loss = {bce(y, forward(X, W1, b1, W2, b2)[2]):.4f}")
    y_hat = forward(X, W1, b1, W2, b2)[2]
    print("xac suat:", [round(float(p), 3) for p in y_hat])
    print("du doan:", [int(p >= 0.5) for p in y_hat])
// Mang no-ron MLP 2 tang: lan truyen xuoi, lan truyen nguoc, Gradient Descent (cung cac buoc voi solution.py).
// Doc tu ban phim: n d h; n dong X (moi dong d so); n nhan y; d dong W1 (moi dong h so); b1 (h so); W2 (h so); b2;
// lr epochs. In ra: dong 1 la gradient ban dau (dW1, db1, dW2, db2); dong 2 la BCE va du doan sau khi huan luyen.
#include <algorithm>
#include <cmath>
#include <iomanip>
#include <iostream>
#include <vector>

using Mat = std::vector<std::vector<double>>;
using Vec = std::vector<double>;

struct Net {
    Mat W1; Vec b1; Vec W2; double b2;
};

// Lan truyen xuoi cho N mau: tra ve z1 (N x H), a1 (N x H), y_hat (N)
void forward(const Mat& X, const Net& net, Mat& z1, Mat& a1, Vec& y_hat) {
    int n = X.size(), d = X[0].size(), h = net.b1.size();
    z1.assign(n, Vec(h)); a1.assign(n, Vec(h)); y_hat.assign(n, 0.0);
    for (int i = 0; i < n; ++i) {
        double z2 = net.b2;
        for (int k = 0; k < h; ++k) {
            double z = net.b1[k];
            for (int j = 0; j < d; ++j) z += X[i][j] * net.W1[j][k];
            z1[i][k] = z;
            a1[i][k] = z > 0.0 ? z : 0.0;
            z2 += a1[i][k] * net.W2[k];
        }
        y_hat[i] = 1.0 / (1.0 + std::exp(-z2));
    }
}

double bce(const Vec& y, const Vec& y_hat) {
    const double eps = 1e-12;
    double s = 0.0;
    for (size_t i = 0; i < y.size(); ++i) {
        double p = std::min(1.0 - eps, std::max(eps, y_hat[i]));
        s -= y[i] * std::log(p) + (1.0 - y[i]) * std::log(1.0 - p);
    }
    return s / y.size();
}

// Lan truyen nguoc theo cac cong thuc o muc 3 (trung binh tren N mau)
void backward(const Mat& X, const Vec& y, const Mat& z1, const Mat& a1, const Vec& y_hat,
              const Net& net, Mat& dW1, Vec& db1, Vec& dW2, double& db2) {
    int n = X.size(), d = X[0].size(), h = net.b1.size();
    dW1.assign(d, Vec(h, 0.0)); db1.assign(h, 0.0); dW2.assign(h, 0.0); db2 = 0.0;
    for (int i = 0; i < n; ++i) {
        double delta2 = (y_hat[i] - y[i]) / n;
        db2 += delta2;
        for (int k = 0; k < h; ++k) {
            dW2[k] += a1[i][k] * delta2;
            double delta1 = z1[i][k] > 0.0 ? delta2 * net.W2[k] : 0.0;
            db1[k] += delta1;
            for (int j = 0; j < d; ++j) dW1[j][k] += X[i][j] * delta1;
        }
    }
}

int main() {
    int n, d, h;
    if (!(std::cin >> n >> d >> h)) return 0;
    Mat X(n, Vec(d)); Vec y(n);
    for (auto& row : X) for (auto& v : row) std::cin >> v;
    for (auto& v : y) std::cin >> v;
    Net net{Mat(d, Vec(h)), Vec(h), Vec(h), 0.0};
    for (auto& row : net.W1) for (auto& v : row) std::cin >> v;
    for (auto& v : net.b1) std::cin >> v;
    for (auto& v : net.W2) std::cin >> v;
    std::cin >> net.b2;
    double lr; int epochs;
    std::cin >> lr >> epochs;

    Mat z1, a1, dW1; Vec y_hat, db1, dW2; double db2;
    forward(X, net, z1, a1, y_hat);
    backward(X, y, z1, a1, y_hat, net, dW1, db1, dW2, db2);
    std::cout << std::fixed << std::setprecision(6);
    for (auto& row : dW1) for (double v : row) std::cout << v << " ";
    for (double v : db1) std::cout << v << " ";
    for (double v : dW2) std::cout << v << " ";
    std::cout << db2 << "\n";

    for (int e = 0; e < epochs; ++e) {
        forward(X, net, z1, a1, y_hat);
        backward(X, y, z1, a1, y_hat, net, dW1, db1, dW2, db2);
        for (int j = 0; j < d; ++j) for (int k = 0; k < h; ++k) net.W1[j][k] -= lr * dW1[j][k];
        for (int k = 0; k < h; ++k) { net.b1[k] -= lr * db1[k]; net.W2[k] -= lr * dW2[k]; }
        net.b2 -= lr * db2;
    }
    forward(X, net, z1, a1, y_hat);
    std::cout << bce(y, y_hat);
    for (double p : y_hat) std::cout << " " << (p >= 0.5 ? 1 : 0);
    std::cout << "\n";
    return 0;
}
6. Các vấn đề sống còn khi huấn luyện mạng nơ-ron
- Khởi tạo trọng số (Weight Initialization): Tuyệt đối không bao giờ khởi tạo toàn bộ ma trận trọng số bằng 0. Nếu mọi trọng số bằng 0, tất cả nơ-ron trong cùng một tầng sẽ nhận tín hiệu giống nhau và có gradient hệt nhau (Symmetry Problem), khiến mạng không thể học được các tính chất đa dạng. Bắt buộc dùng khởi tạo ngẫu nhiên như He Initialization (cho tầng dùng ReLU) hoặc Xavier / Glorot (cho Sigmoid/Tanh).
- Hiện tượng chết nơ-ron (Dying ReLU): Khi tốc độ học quá lớn, một bước cập nhật có thể đẩy trọng số làm cho giá trị \(z_1\) luôn âm với mọi mẫu dữ liệu. Khi đó nơ-ron sẽ vĩnh viễn cho ra \(a_1 = 0\) và gradient bằng \(0\), không bao giờ phục hồi được. Khắc phục bằng cách dùng Leaky ReLU hoặc hạ nhỏ learning rate.
- Hiện tượng bùng nổ / triệt tiêu gradient (Exploding / Vanishing Gradient): Khi mạng có hàng chục tầng, gradient nhân dồn qua nhiều ma trận có thể tiến về 0 hoặc vô cực. Khởi tạo trọng số chuẩn hóa (như He, Xavier) và Batch Normalization giúp giảm phần lớn hiện tượng này; Residual Connections (ResNet) được đưa ra để giải bài toán độ chính xác giảm khi mạng sâu thêm (degradation), cho phép huấn luyện mạng 152 tầng.
7. Bảng so sánh MLP với Mạng Tích chập (CNN) và Transformer
| Kiến trúc mạng | Dạng kết nối | Đặc trưng không gian / thứ tự | Ứng dụng chủ đạo |
|---|---|---|---|
| MLP (Fully Connected) | Kết nối toàn phần giữa mọi nơ-ron | Không bảo toàn cấu trúc không gian | Dữ liệu dạng bảng (Tabular Data), phân loại đơn giản |
| CNN (Convolutional) | Kết nối cục bộ, chia sẻ trọng số | Khai thác tương quan không gian 2D/3D | Thị giác máy tính (Computer Vision), xử lý ảnh số |
| Transformer (Attention) | Cơ chế tự chú ý (Self-Attention) | Khai thác mối tương quan toàn cục đa chiều | Xử lý ngôn ngữ tự nhiên (LLM), âm thanh, chuỗi thời gian |
8. Câu hỏi thường gặp
Định lý xấp xỉ phổ quát (Universal Approximation Theorem) nói gì về MLP?
Định lý phát biểu rằng: Một mạng nơ-ron truyền thẳng chỉ cần duy nhất 1 tầng ẩn với số lượng nơ-ron đủ lớn và một hàm kích hoạt liên tục không phải đa thức (như ReLU, Sigmoid, Tanh) có thể xấp xỉ bất kỳ hàm số liên tục nào trên một miền đóng và bị chặn của không gian Euclid với độ chính xác tùy ý. Tuy nhiên trên thực tế, một mạng nông với hàng triệu nơ-ron rất khó huấn luyện; việc xếp chồng nhiều tầng ẩn sâu hơn (Deep Architecture) giúp mạng học các biểu diễn phân cấp theo từng tầng hiệu quả hơn gấp bội.
Tại sao PyTorch lại gọi quá trình này là Autograd?
Trong PyTorch, hệ thống tính toán tự động Autograd xây dựng một đồ thị tính toán động (Dynamic Computation Graph). Mỗi phép toán trên Tensor được lưu vết lại, và khi gọi phương thức .backward(), PyTorch tự động duyệt ngược đồ thị để tính gradient chính xác theo đúng các bước toán học mà chúng ta vừa thực hiện thủ công trong bài viết này.
9. Khởi tạo Trọng số Sống còn: Vì sao Không Thể Khởi tạo Bằng Không?
Một trong những sai lầm kinh điển nhất của những người mới bắt đầu học Deep Learning là khởi tạo toàn bộ ma trận trọng số ban đầu bằng các số 0 tuyệt đối, tương tự như cách chúng ta vẫn thường làm trong các thuật toán hồi quy tuyến tính thông thường.
Trong mạng nơ-ron sâu, nếu tất cả trọng số được khởi tạo bằng 0: Thứ nhất, ở pha lan truyền xuôi, tất cả các nơ-ron trong cùng một tầng ẩn sẽ nhận được tín hiệu đầu vào hoàn toàn giống nhau, tạo ra các giá trị kích hoạt đầu ra đồng nhất tuyệt đối. Thứ hai, ở pha lan truyền ngược, gradient truyền về cho tất cả các nơ-ron trong tầng đó cũng sẽ giống hệt nhau từng chữ số thập phân! Hệ quả là sau mỗi bước cập nhật trọng số bằng Gradient Descent, toàn bộ các nơ-ron vẫn giữ các giá trị bằng nhau. Mạng nơ-ron bị rơi vào tình trạng đối xứng hoàn toàn (Symmetry Problem); việc bạn thiết kế tầng ẩn có 100 nơ-ron cũng không khác gì việc bạn chỉ có một nơ-ron duy nhất hoạt động. Toàn bộ năng lực biểu diễn phong phú của mạng học sâu bị vô hiệu hóa hoàn toàn.
Để phá vỡ tính đối xứng này, trọng số bắt buộc phải được khởi tạo ngẫu nhiên từ một phân phối xác suất phù hợp. Tuy nhiên, nếu khởi tạo với phương sai quá lớn, tín hiệu sẽ bùng nổ qua từng tầng; nếu khởi tạo quá nhỏ, tín hiệu sẽ nhanh chóng suy giảm về 0. Hai giải pháp chuẩn mực đã được phát minh:
- Khởi tạo Xavier / Glorot: Thiết kế cho các hàm kích hoạt như Tanh (đối xứng qua gốc tọa độ) và Sigmoid, điều chỉnh phương sai tỷ lệ nghịch với tổng số nơ-ron đầu vào và đầu ra của tầng.
- Khởi tạo He / Kaiming: Do Kaiming He và cộng sự đề xuất năm 2015 cho hàm kích hoạt ReLU: vì ReLU cho ra 0 ở nửa âm, phương sai khởi tạo được nhân đôi thành \(2 / n_{\text{vào}}\) để tín hiệu giữ được độ lớn qua nhiều tầng. Ví dụ XOR ở mục 5 dùng đúng cách khởi tạo này.
10. Kỹ thuật Kiểm thử Gradient bằng Sai phân Hữu hạn (Gradient Checking)
Khi bạn tự tay lập trình thuật toán lan truyền ngược Backpropagation bằng thư viện NumPy, làm thế nào để bạn có thể khẳng định chắc chắn 100% rằng các biểu thức giải tích và ma trận đạo hàm mà bạn tự tính toán là hoàn toàn chính xác và không chứa bất kỳ lỗi logic tiềm ẩn nào? Câu trả lời chính là Kỹ thuật Kiểm thử Gradient (Numerical Gradient Checking).
Phương pháp này dựa trên định nghĩa nguyên bản của đạo hàm trong giải tích vi tích phân cổ điển thông qua sai phân đối xứng hai phía. Với một bước nhảy cực nhỏ epsilon (thường chọn khoảng 10 mũ trừ 5), đạo hàm số học của hàm mất mát đối với một tham số đơn lẻ được tính bằng hiệu giữa hàm mất mát khi tham số tăng nhẹ và khi tham số giảm nhẹ, chia cho hai lần bước nhảy epsilon.
Sau khi tính toán vector đạo hàm số học cho từng trọng số, chúng ta so sánh nó với vector đạo hàm giải tích thu được từ thuật toán lan truyền ngược. Sai số tương đối giữa hai vector được đo lường bằng khoảng cách chuẩn Euclid chia cho tổng độ dài của hai vector. Nếu sai số tương đối này nhỏ hơn 10 mũ trừ 7, gần như chắc chắn phần lan truyền ngược đã viết đúng; phần kiểm của code ở mục 5 dùng đúng ngưỡng này. Kỹ thuật kiểm thử này là tiêu chuẩn bắt buộc trong quá trình nghiên cứu và phát triển các kiến trúc mạng nơ-ron mới trước khi triển khai huấn luyện diện rộng.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.