- Khi sinh chữ, khóa và giá trị của các token cũ không đổi. KV cache giữ chúng lại, nên mỗi bước chỉ tính cho token mới; kết quả y hệt khi tính lại cả chuỗi.
- Dung lượng = 2 × số lớp × số đầu khóa × số chiều mỗi đầu × số byte, nhân với số token và số chuỗi trong lô. OPT-13B tốn 800 KB mỗi token.
- MQA và GQA cho nhiều đầu truy vấn dùng chung một đầu khóa, giá trị, giảm KV cache nhiều lần mà gần giữ chất lượng.
- vLLM cấp bộ nhớ KV theo khối 16 token như trang nhớ của hệ điều hành, gần như không lãng phí, và chia sẻ được phần đầu chung.
Code trong bài là Python 3 với numpy. Bài giả định bạn đã biết truy vấn, khóa, giá trị trong lớp chú ý; nếu chưa, đọc bài kiến trúc transformer. Số liệu lấy từ bản PDF của các bài báo và trang tài liệu vLLM, đọc ngày 12/11/2026.
Sinh từng token thì lặp lại phép tính nào
Mô hình ngôn ngữ sinh chữ tuần tự: đọc đoạn đầu vào, sinh một token, nối token đó vào chuỗi, rồi sinh token tiếp theo. Pope và cộng sự chia việc này thành hai giai đoạn: đọc đầu vào (prefill), xử lý mọi token của đoạn đầu cùng lúc; và sinh (decode), mỗi lượt chạy mô hình chỉ ra một token.
Ở lớp chú ý nhân quả, token ở vị trí t chỉ nhìn các token từ 1 tới t. Khóa và giá trị của token 1 tới t − 1 phụ thuộc đúng những token đó, nên không đổi khi có thêm token mới. Nếu không lưu lại, bước thứ t phải nhân lại t token với ma trận khóa và ma trận giá trị. Sinh 1000 token như vậy cần 1 + 2 + ... + 1000 = 500.500 lần chiếu; có cache thì chỉ 1000 lần, mỗi token đúng một lần. Ở bước mới, mô hình chỉ tính truy vấn, khóa, giá trị của token mới, nối khóa và giá trị vào cache, rồi cho truy vấn chấm với mọi khóa đã lưu.
KV cache tốn bao nhiêu bộ nhớ
Mỗi lớp lưu một vectơ khóa và một vectơ giá trị cho mỗi đầu khóa của mỗi token. Số byte cho một token là:
\[\text{KV} = 2 \times n_{\text{layers}} \times n_{\text{kv}} \times d_{\text{head}} \times b\]
với b là số byte mỗi số (2 với dạng 16 bit). Nhân thêm số token trong ngữ cảnh và số chuỗi chạy cùng lúc là ra tổng. Bài báo vLLM tính cho OPT-13B: 2 × 5120 (chiều ẩn, tức 40 đầu × 128 chiều) × 40 lớp × 2 byte = 800 KB mỗi token. Một yêu cầu dài 2048 token cần tới khoảng 1,6 GB. Trên GPU A100 40 GB chạy mô hình 13 tỉ tham số, trọng số chiếm khoảng 65% bộ nhớ và KV cache chiếm gần 30%.
Ở quy mô lớn hơn, KV cache còn vượt cả trọng số. Pope và cộng sự ghi rằng với mô hình trên 500 tỉ tham số dùng chú ý nhiều đầu, 512 chuỗi chạy cùng lúc, mỗi chuỗi dài 2048 token, cần 3 TB KV cache, gấp 3 lần kích thước tham số. Mỗi token sinh ra, toàn bộ cache phải được đọc lên từ bộ nhớ một lần, trong lúc phần tính toán gần như ngồi chờ. Vì thế, ở giai đoạn sinh, tốc độ bị giới hạn bởi băng thông bộ nhớ nhiều hơn số phép nhân.
Bạn có thể tính cho mô hình mình dùng từ bảng kiến trúc. Mixtral 8x7B có 32 lớp, 8 đầu khóa, mỗi đầu 128 chiều, nên mỗi token tốn 2 × 32 × 8 × 128 × 2 = 131.072 byte, tức 128 KiB; ngữ cảnh 32.768 token cần 4 GiB cho một chuỗi. Bộ nhớ cho trọng số thì tính riêng, như trong bài chạy AI trên máy cá nhân.
MQA và GQA: cho nhiều đầu dùng chung khóa
Cách giảm KV cache trực tiếp nhất là giảm \(n_{\text{kv}}\). Chú ý đa truy vấn (multi-query attention, MQA) giữ nhiều đầu truy vấn nhưng chỉ một đầu khóa và một đầu giá trị dùng chung, nên KV cache nhỏ đi đúng bằng số đầu. Bảng 1 của Pope và cộng sự, với PaLM 540B trên 64 chip và 30% bộ nhớ dành cho KV cache, cho độ dài ngữ cảnh tối đa: chú ý nhiều đầu được 1320 token khi chạy 128 chuỗi cùng lúc; MQA với cách chia dữ liệu tối ưu của bài báo được 43.000 token, tức dài hơn tới 32 lần.
MQA có thể làm giảm chất lượng. Ainslie và cộng sự đề xuất chú ý truy vấn theo nhóm (grouped-query attention, GQA): chia đầu truy vấn thành nhóm, mỗi nhóm dùng chung một đầu khóa, giá trị. Họ còn chuyển mô hình nhiều đầu có sẵn sang GQA bằng cách lấy trung bình các ma trận khóa, giá trị rồi huấn luyện thêm chỉ 5% lượng tính toán ban đầu. Với T5-XXL, bản nhiều đầu mất 1,51 giây mỗi mẫu, điểm trung bình 47,2; MQA mất 0,24 giây, điểm 46,6; GQA với 8 nhóm mất 0,28 giây, điểm 47,1. Mixtral là một ví dụ GQA: 32 đầu truy vấn, 8 đầu khóa, nên KV cache nhỏ hơn 4 lần so với khi mỗi đầu có khóa riêng.
vLLM và PagedAttention: cấp bộ nhớ theo khối
vLLM là hệ thống phục vụ mô hình ngôn ngữ do nhóm Kwon và cộng sự xây dựng, dựa trên một thuật toán chú ý mới là PagedAttention. Vấn đề họ nhắm tới: KV cache của mỗi yêu cầu lớn, lớn dần rồi biến mất, và không biết trước sẽ dài bao nhiêu. Các hệ thống cũ cấp sẵn một vùng liền nhau đủ cho độ dài tối đa, nên phần lớn bị bỏ trống hoặc vụn ra. Đo trong bài báo cho thấy chỉ 20,4% tới 38,2% bộ nhớ KV cache của các hệ thống đó thật sự chứa trạng thái của token.
PagedAttention mượn ý tưởng trang nhớ của hệ điều hành. KV cache được chia thành khối cố định, mỗi khối chứa khóa, giá trị của một số token, mặc định 16 token theo bài báo. Mỗi chuỗi có một bảng khối ánh xạ khối logic sang khối vật lý nằm rải rác trong bộ nhớ, và chỉ xin thêm khối khi khối cuối đã đầy. Một chuỗi dài 70 token cần 5 khối, thừa 10 chỗ, thay vì giữ sẵn 2048 chỗ.
Bảng khối còn cho phép chia sẻ. Khi một yêu cầu sinh nhiều câu trả lời từ cùng một đoạn đầu vào, các câu trả lời trỏ tới cùng khối của đoạn đầu; chỉ khi một câu cần ghi vào khối dùng chung thì khối đó mới được chép ra (sao chép khi ghi, copy-on-write). Với tìm kiếm chùm (beam search), bài báo ghi tiết kiệm được tới 55% bộ nhớ. Tổng hợp lại, vLLM tăng thông lượng 2-4 lần so với các hệ thống trước ở cùng độ trễ.
Lượng tử hóa KV cache
Cách thứ ba là giảm b, số byte mỗi số. Tài liệu vLLM (đọc 12/11/2026) cho lưu KV cache ở dạng FP8, một byte mỗi số, để chứa được nhiều token hơn, tăng thông lượng và cho ngữ cảnh dài hơn. Thang đo có thể đặt cho cả tensor hoặc cho từng đầu chú ý. Không hiệu chỉnh thì mọi thang bằng 1,0; tài liệu khuyên hiệu chỉnh bằng một bộ dữ liệu để chính xác nhất, và cho phép giữ nguyên độ chính xác ở vài lớp nhạy cảm. Thang đo, điểm không và sai số làm tròn được giải thích trong bài lượng tử hóa mô hình.
Thử bằng numpy
Đoạn code dưới đây dựng một lớp chú ý nhân quả có thể chạy như MHA, GQA hay MQA, sinh 20 bước theo hai cách: có cache và tính lại cả chuỗi mỗi bước. Nó cũng tính dung lượng KV cache và số khối nhớ.
"""Sinh từng token có KV cache và không có cache, bằng numpy; dung lượng KV cache; chia sẻ đầu khóa (GQA);
số khối nhớ kiểu PagedAttention của vLLM."""
import math

import numpy as np


def softmax(z):
    e = np.exp(z - z.max())
    return e / e.sum()


class LopChuY:
    """Một lớp chú ý nhân quả: n_dau đầu truy vấn, n_kv đầu khóa và giá trị.
    n_kv = n_dau là chú ý nhiều đầu (MHA), n_kv = 1 là MQA, ở giữa là GQA."""

    def __init__(self, d, n_dau, n_kv, rng):
        assert n_dau % n_kv == 0
        self.h, self.hkv, self.dh = n_dau, n_kv, d // n_dau
        self.Wq = rng.normal(size=(d, n_dau * self.dh)) / math.sqrt(d)
        self.Wk = rng.normal(size=(d, n_kv * self.dh)) / math.sqrt(d)
        self.Wv = rng.normal(size=(d, n_kv * self.dh)) / math.sqrt(d)
        self.Wo = rng.normal(size=(n_dau * self.dh, d)) / math.sqrt(d)
        self.so_lan_chieu = 0          # đếm số token được nhân với Wk, Wv

    def _chu_y(self, q, K, V):
        """q: (h, dh) của vị trí đang xét; K, V: (t, hkv, dh). Mỗi nhóm h/hkv đầu truy vấn dùng chung một đầu K, V."""
        nhom = self.h // self.hkv
        ra = np.empty((self.h, self.dh))
        for a in range(self.h):
            g = a // nhom
            ra[a] = softmax(K[:, g] @ q[a] / math.sqrt(self.dh)) @ V[:, g]
        return ra.reshape(-1) @ self.Wo

    def _kv(self, X):
        self.so_lan_chieu += len(X)
        return ((X @ self.Wk).reshape(len(X), self.hkv, self.dh), (X @ self.Wv).reshape(len(X), self.hkv, self.dh))

    def tinh_lai(self, X):
        """Không cache: chiếu lại K, V cho mọi token của X rồi tính đầu ra ở vị trí cuối."""
        K, V = self._kv(X)
        return self._chu_y((X[-1] @ self.Wq).reshape(self.h, self.dh), K, V)

    def buoc_co_cache(self, x, cache):
        """Có cache: chỉ chiếu token mới x, nối k, v của nó vào cache rồi tính chú ý."""
        k, v = self._kv(x[None, :])
        cache["K"] = k if cache["K"] is None else np.concatenate([cache["K"], k])
        cache["V"] = v if cache["V"] is None else np.concatenate([cache["V"], v])
        return self._chu_y((x @ self.Wq).reshape(self.h, self.dh), cache["K"], cache["V"])


def sinh(lop, X0, so_buoc, co_cache):
    """Đọc đoạn mở đầu X0 rồi sinh thêm so_buoc vectơ; đầu vào bước sau là tanh của đầu ra bước trước."""
    X, ra = list(X0), []
    cache = {"K": None, "V": None}
    if co_cache:
        for x in X0[:-1]:
            lop.buoc_co_cache(x, cache)          # giai đoạn đọc đầu vào (prefill)
    for _ in range(so_buoc):
        y = lop.buoc_co_cache(X[-1], cache) if co_cache else lop.tinh_lai(np.array(X))
        ra.append(y)
        X.append(np.tanh(y))
    return np.array(ra)


def kv_byte_moi_token(so_lop, so_dau_kv, chieu_dau, so_byte=2):
    """2 (khóa và giá trị) x số lớp x số đầu khóa x số chiều mỗi đầu x số byte mỗi số."""
    return 2 * so_lop * so_dau_kv * chieu_dau * so_byte


def so_khoi(so_token, co_khoi=16):
    """Số khối KV cần cho một chuỗi khi cấp phát theo khối (vLLM mặc định 16 token mỗi khối)."""
    return -(-so_token // co_khoi)


if __name__ == "__main__":
    rng = np.random.default_rng(0)
    X0 = rng.normal(size=(5, 32))
    for ten, h, hkv in (("MHA", 8, 8), ("GQA", 8, 2), ("MQA", 8, 1)):
        a, b = LopChuY(32, h, hkv, np.random.default_rng(1)), LopChuY(32, h, hkv, np.random.default_rng(1))
        y_cache, y_lai = sinh(a, X0, 20, True), sinh(b, X0, 20, False)
        print("%s: sai khác lớn nhất %.1e | số token được chiếu K, V: có cache %d, không cache %d"
              % (ten, np.abs(y_cache - y_lai).max(), a.so_lan_chieu, b.so_lan_chieu))

    opt = kv_byte_moi_token(40, 40, 128)
    print("OPT-13B: %d byte = %d KiB mỗi token; 2048 token = %d KiB" % (opt, opt // 1024, opt * 2048 // 1024))
    mix = kv_byte_moi_token(32, 8, 128)
    print("Mixtral 8x7B (8 đầu KV): %d KiB mỗi token, 32768 token = %d GiB; nếu 32 đầu KV: %d GiB"
          % (mix // 1024, mix * 32768 // 2**30, kv_byte_moi_token(32, 32, 128) * 32768 // 2**30))
    print("Chuỗi 70 token: %d khối, thừa %d chỗ; đặt trước 2048 chỗ thì thừa %d" % (so_khoi(70), so_khoi(70) * 16 - 70, 2048 - 70))
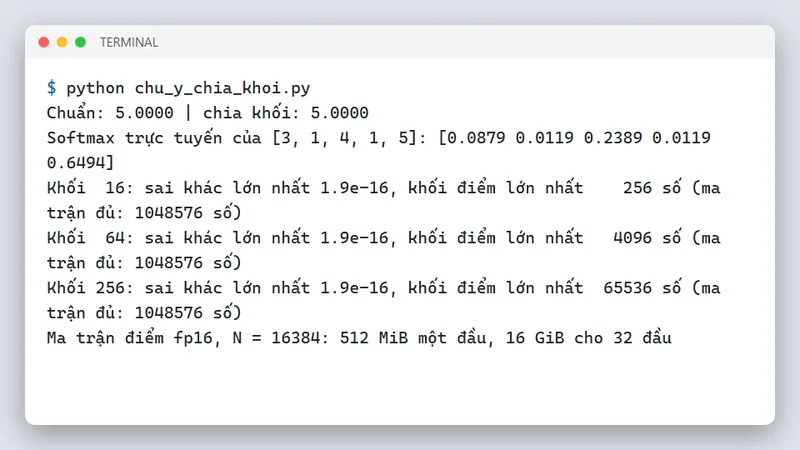
Ở cả ba kiểu chú ý, hai cách lệch nhau cỡ \(10^{-16}\), tức chỉ sai số làm tròn. Với đoạn đầu 5 token và 20 bước sinh, cách có cache chiếu khóa, giá trị 24 lần (4 token đầu vào cộng 20 bước), cách tính lại chiếu 5 + 6 + ... + 24 = 290 lần. Các dòng sau in 819.200 byte (800 KiB) mỗi token cho OPT-13B, 128 KiB mỗi token và 4 GiB cho 32.768 token với Mixtral, và 16 GiB nếu Mixtral có 32 đầu khóa riêng.
Muốn chắc code cache của mình đúng, hãy so đầu ra từng bước với chú ý nhân quả tính một lần trên cả chuỗi cuối cùng bằng ma trận có mặt nạ tam giác. Hai kết quả phải trùng ở mọi vị trí.
KV cache khác prompt caching thế nào
KV cache cơ bản chỉ phục vụ một lần sinh và được giải phóng khi yêu cầu kết thúc. Tính năng prompt caching của các API giữ KV cache lâu hơn, ở tầng dịch vụ: phần xử lý của đoạn đầu prompt giống hệt nhau được dùng lại giữa nhiều lần gọi để giảm phí và thời gian. Bài báo vLLM mô tả cơ chế gần với nó: dành sẵn các khối vật lý cho một đoạn đầu dùng chung, và yêu cầu nào bắt đầu bằng đoạn đó chỉ cần trỏ tới các khối ấy.
- Ước bộ nhớ chỉ theo trọng số mà quên KV cache: với ngữ cảnh dài và nhiều người dùng cùng lúc, phần này có thể lớn hơn cả trọng số.
- Tính KV cache theo số đầu truy vấn thay vì số đầu khóa: mô hình dùng GQA nhỏ hơn nhiều lần so với con số đó.
- Quên rằng KV cache nhân theo số chuỗi trong lô: 10 người dùng cùng lúc là 10 bộ cache.
- Nghĩ rằng KV cache làm thay đổi câu trả lời: nó chỉ tránh tính lại, kết quả giống hệt.
Câu hỏi thường gặp
KV cache là gì?
Là bộ nhớ giữ khóa và giá trị của mọi token đã đọc trong lớp chú ý, để khi sinh token mới mô hình chỉ tính cho token đó thay vì tính lại cả chuỗi.
Vì sao KV cache tăng theo độ dài ngữ cảnh?
Vì mỗi token đã đọc để lại một vectơ khóa và một vectơ giá trị ở mỗi lớp. Ngữ cảnh dài gấp đôi thì cache lớn gấp đôi.
vLLM là gì?
Là hệ thống phục vụ mô hình ngôn ngữ dùng PagedAttention: cấp bộ nhớ KV theo khối nhỏ như trang nhớ, gần như không lãng phí, nên chạy được lô lớn hơn và tăng thông lượng 2-4 lần theo bài báo gốc.
Lượng tử hóa KV cache có làm câu trả lời kém đi không?
Có thể, vì khóa và giá trị bị làm tròn. Tài liệu vLLM khuyên hiệu chỉnh thang đo bằng dữ liệu và cho phép giữ nguyên độ chính xác ở các lớp nhạy cảm.
Học tiếp
KV cache làm mỗi bước sinh rẻ hơn nhưng vẫn phải chạy mô hình lớn từng token một. Bài speculative decoding giải thích cách để mô hình nhỏ đoán trước nhiều token cho mô hình lớn duyệt một lượt, còn bài FlashAttention nói cách tính chú ý trên cả chuỗi mà không giữ ma trận điểm. Nếu muốn học AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Pope và cộng sự (2022), Efficiently Scaling Transformer Inference, arXiv 2211.05102v1 (PDF, đọc 12/11/2026)
- Ainslie và cộng sự (2023), GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, arXiv 2305.13245v3 (PDF, đọc 12/11/2026)
- Kwon và cộng sự (2023), Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv 2309.06180v1 (PDF, đọc 12/11/2026)
- Jiang và cộng sự (2024), Mixtral of Experts, bảng kiến trúc, arXiv 2401.04088v1 (PDF, đọc 12/11/2026)
- vLLM docs: Quantized KV Cache (đọc 12/11/2026)