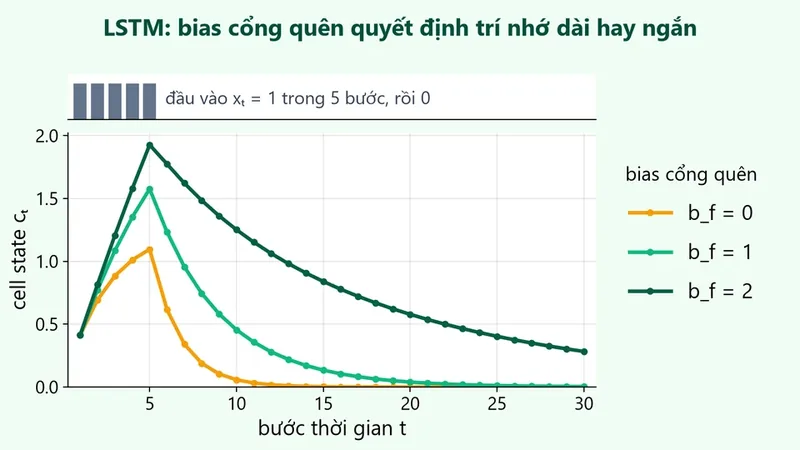
- Loại bỏ đệ quy, xử lý song song: Transformer loại bỏ hoàn toàn các liên kết hồi quy tuần tự của RNN, xử lý đồng thời tất cả các từ trong chuỗi đầu vào theo cơ chế song song hóa hoàn toàn, khai phóng tối đa sức mạnh của phần cứng GPU hiện đại.
- Cơ chế Chú ý Tự thân (Self-Attention): Cho phép mỗi từ trong câu tính toán độ tương quan và liên kết trực tiếp với mọi từ khác trong cùng văn bản mà không phụ thuộc vào khoảng cách vị trí địa lý, giải quyết triệt để vấn đề mất mát ngữ cảnh xa.
- Multi-Head Attention đa góc nhìn: Chia không gian vector nhúng thành nhiều đầu độc lập (heads), cho phép mô hình đồng thời quan sát và kết hợp các khía cạnh ngữ pháp, ngữ nghĩa và cú pháp khác nhau tại cùng một bước suy luận.
1. Cuộc khủng hoảng của các mô hình tuần tự và sự ra đời của Transformer
Trước năm 2017, các kiến trúc tuần tự như LSTM và GRU là tiêu chuẩn thống trị trong mọi bài toán xử lý chuỗi (Sequence-to-Sequence). Mặc dù cơ chế Attention bổ sung đã giúp cải thiện đáng kể mô hình dịch máy, bản thân lõi tính toán của mạng vẫn bị kìm kẹp bởi nguyên lý đệ quy:
\[\mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t)\]
Tính chất đệ quy này dẫn đến hai nhược điểm cốt tử không thể khắc phục:
- Không thể tính toán song song (Sequential Bottleneck): Để tính trạng thái \(\mathbf{h}_{100}\), phần cứng buộc phải đợi lần lượt từ \(\mathbf{h}_1\) đến \(\mathbf{h}_{99}\). Hàng ngàn nhân tính toán mạnh mẽ của GPU rơi vào tình trạng nhàn rỗi chờ đợi, khiến việc mở rộng quy mô huấn luyện trên các tập dữ liệu khổng lồ (hàng trăm tỷ từ) trở nên bất khả thi.
- Khoảng cách truyền tin dài (Path Length \(O(N)\)): Để thông tin từ từ thứ nhất kết nối được với từ thứ 100, tín hiệu phải di chuyển qua 100 mắt xích trung gian. Dù có cơ chế cổng của LSTM, thông tin vẫn chịu sự suy thoái nhất định.
Đột phá xuất hiện khi nhóm nghiên cứu tại Google Brain đặt câu hỏi: "Liệu chúng ta có thể loại bỏ hoàn toàn mạng hồi quy và chỉ giữ lại duy nhất cơ chế Attention?" Câu trả lời là bài báo kinh điển "Attention Is All You Need" cùng kiến trúc Transformer thuần chú ý.
2. Trụ cột toán học: Cơ chế Scaled Dot-Product Attention
Hãy hình dung cơ chế Attention tương tự như một hệ thống tra cứu cơ sở dữ liệu:
- Khi người dùng gõ một từ khóa tìm kiếm, đó là truy vấn Query (\(\mathbf{Q}\)).
- Hệ thống so sánh Query với các tiêu đề mục lục trong cơ sở dữ liệu, đó là các khóa Key (\(\mathbf{K}\)).
- Khi tìm thấy các Key tương đồng nhất, hệ thống trả về nội dung chi tiết tương ứng, đó là các giá trị Value (\(\mathbf{V}\)).
Trong Transformer, cả ba ma trận \(\mathbf{Q}, \mathbf{K}, \mathbf{V}\) đều được tạo ra bằng cách nhân vector nhúng đầu vào \(\mathbf{X}\) với các ma trận trọng số có thể học:
\[\mathbf{Q} = \mathbf{X} \mathbf{W}_Q, \quad \mathbf{K} = \mathbf{X} \mathbf{W}_K, \quad \mathbf{V} = \mathbf{X} \mathbf{W}_V\]
Công thức tính toán Scaled Dot-Product Attention được định nghĩa như sau:
\[\text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q} \mathbf{K}^T}{\sqrt{d_k}}\right) \mathbf{V}\]
Giải phẫu từng thành phần toán học:
- Tích vô hướng \(\mathbf{Q} \mathbf{K}^T\) (Dot-Product Similarity): Nếu hai vector \(\mathbf{q}_i\) và \(\mathbf{k}_j\) chỉ cùng hướng trong không gian ngữ nghĩa nhiều chiều, tích vô hướng của chúng sẽ mang giá trị rất lớn, thể hiện mức độ tương quan ngữ cảnh sâu sắc giữa từ thứ \(i\) và từ thứ \(j\).
- Hệ số co giãn thang đo \(\frac{1}{\sqrt{d_k}}\) (Scaling Factor): Đây là chi tiết cực kỳ tinh tế trong thiết kế của bài báo gốc. Giả sử các thành phần của \(\mathbf{q}\) và \(\mathbf{k}\) là các biến ngẫu nhiên độc lập có trung bình bằng \(0\) và phương sai bằng \(1\). Tích vô hướng \(\mathbf{q} \cdot \mathbf{k} = \sum_{m=1}^{d_k} q_m k_m\) sẽ có giá trị kỳ vọng bằng \(0\) nhưng phương sai bằng chính \(d_k\). Khi số chiều vector \(d_k\) lớn (ví dụ \(d_k = 64\) hoặc \(128\)), giá trị tích vô hướng sẽ dao động rất lớn. Nếu đưa trực tiếp giá trị cực lớn này vào hàm Softmax, hàm số sẽ rơi vào vùng bão hòa có đạo hàm cực kỳ tiệm cận \(0\), gây tê liệt quá trình huấn luyện bằng Gradient Descent. Phép chia cho \(\sqrt{d_k}\) đưa phương sai trở lại mức \(1\), giúp dòng gradient ổn định.
- Chuẩn hóa xác suất Softmax: Hàm Softmax được áp dụng độc lập trên từng hàng của ma trận điểm số, biến các độ đo tương quan thành một phân phối xác suất hợp lệ có tổng bằng \(1.0\). Mỗi phần tử \(A_{ij}\) đại diện cho tỷ lệ phần trăm sự chú ý mà từ \(i\) dành cho từ \(j\).
- Nhân với ma trận Value \(\mathbf{V}\): Vector biểu diễn mới của từ \(i\) chính là tổ hợp tuyến tính có trọng số của toàn bộ các vector giá trị \(\mathbf{v}_j\), phản ánh ngữ cảnh tổng hợp từ các từ liên quan xung quanh.
3. Cơ chế Multi-Head Attention: Mở rộng đa chiều quan sát
Nếu chỉ sử dụng một ma trận Attention duy nhất, khả năng chú ý của mô hình dễ bị áp đảo bởi từ liên kết mạnh nhất, bỏ qua các mối liên hệ tinh tế khác. Ví dụ trong câu "Con mèo bắt con chuột vì nó đói", từ "nó" vừa cần liên kết với "con mèo" (chủ ngữ), vừa cần liên kết với "đói" (trạng thái).
Cơ chế Multi-Head Attention giải quyết việc này bằng cách chiếu \(\mathbf{Q}, \mathbf{K}, \mathbf{V}\) thành \(h\) không gian vector con độc lập:
\[\text{MultiHead}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{Concat}(\text{head}_1, \text{head}_2, \dots, \text{head}_h) \mathbf{W}_O\]
Trong đó mỗi đầu chú ý được tính bằng:
\[\text{head}_i = \text{Attention}(\mathbf{Q} \mathbf{W}_Q^{(i)}, \mathbf{K} \mathbf{W}_K^{(i)}, \mathbf{V} \mathbf{W}_V^{(i)})\]
Mỗi đầu chú ý có thể tự do chuyên môn hóa một chức năng riêng biệt: một đầu chuyên chú ý đến mối quan hệ cú pháp chủ-vị, một đầu chuyên bắt cặp đại từ thay thế, một đầu tập trung vào quan hệ từ vựng lân cận.
4. Mã hóa vị trí (Positional Encoding)
Vì Transformer loại bỏ hoàn toàn vòng lặp tuần tự và xử lý tất cả các từ cùng lúc, mô hình hoàn toàn bình đẳng về mặt vị trí (permutation invariant). Câu "Mèo đuổi chuột" và "Chuột đuổi mèo" sẽ tạo ra tập hợp vector giống hệt nhau nếu không có cơ chế bổ sung thông tin vị trí.
Để cung cấp thứ tự từ cho mô hình mà không làm mất tính tổng quát, các tác giả đề xuất phép cộng vector nhúng vị trí (Positional Encoding) vào vector nhúng từ ban đầu:
\[\mathbf{x}_{\text{input}} = \mathbf{x}_{\text{embedding}} + \mathbf{PE}_{(pos)}\]
Hàm mã hóa vị trí sin-cos hình sin tuần hoàn:
\[\mathbf{PE}_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)\]
\[\mathbf{PE}_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)\]
Trong đó \(pos\) là chỉ số vị trí của từ trong câu (\(0, 1, 2, \dots\)) và \(i\) là chỉ số chiều vector (\(0 \le i \lt d_{\text{model}}/2\)). Đặc tính toán học kỳ diệu của hàm lượng giác này là cho phép mô hình dễ dàng học được vị trí tương đối: với bất kỳ khoảng dịch chuyển cố định \(k\), tồn tại một ma trận biến đổi tuyến tính chiếu từ \(\mathbf{PE}_{(pos)}\) sang \(\mathbf{PE}_{(pos+k)}\).
5. Cấu trúc toàn diện của Transformer Layer
Mỗi tầng Transformer trong Encoder bao gồm hai khối chức năng chính:
- Khối Multi-Head Attention: Kèm theo kết nối tắt (Residual Connection) và Chuẩn hóa tầng (Layer Normalization): \[\mathbf{x}^{(1)} = \text{LayerNorm}(\mathbf{x} + \text{MultiHead}(\mathbf{x}, \mathbf{x}, \mathbf{x}))\] Kết nối phần dư \(\mathbf{x} + f(\mathbf{x})\) đóng vai trò then chốt giúp gradient truyền trực tiếp qua hàng chục tầng sâu mà không bị suy hao.
- Khối mạng truyền thẳng từng vị trí (Position-wise Feed-Forward Network - FFN): Bao gồm hai phép biến đổi tuyến tính xen kẽ một hàm kích hoạt phi tuyến (thường là ReLU hoặc GELU): \[\text{FFN}(\mathbf{x}) = \max(0, \mathbf{x} \mathbf{W}_1 + \mathbf{b}_1) \mathbf{W}_2 + \mathbf{b}_2\] \[\mathbf{x}_{\text{output}} = \text{LayerNorm}(\mathbf{x}^{(1)} + \text{FFN}(\mathbf{x}^{(1)}))\] Khối FFN mở rộng chiều ẩn lên gấp 4 lần (\(d_{ff} = 4 \times d_{\text{model}}\)) trước khi nén lại, hoạt động như một kho lưu trữ tri thức bộ nhớ kết hợp (associative memory) của mô hình.
Chủ đề này nằm trong Lecture 14 - Neural Networks của Khóa AI. Xem đề cương
6. Cài đặt thuật toán kiểm thử: Scaled Dot-Product Attention
Dưới đây là mã nguồn cài đặt chính xác cơ chế Scaled Dot-Product Attention cho ma trận \(2 \times 2\) trong Python và C++17, tính toán chi tiết từ nhân ma trận, co giãn thang đo, softmax theo hàng đến tích hợp ma trận Value:
import math

def softmax_row(row):
    max_val = max(row)
    exp_vals = [math.exp(x - max_val) for x in row]
    sum_exp = sum(exp_vals)
    return [x / sum_exp for x in exp_vals]

def scaled_dot_product_attention(Q, K, V):
    d_k = 2.0
    scale = math.sqrt(d_k)

    scores = [[0.0, 0.0], [0.0, 0.0]]
    for i in range(2):
        for j in range(2):
            dot = Q[i][0] * K[j][0] + Q[i][1] * K[j][1]
            scores[i][j] = dot / scale

    attn_weights = [softmax_row(scores[0]), softmax_row(scores[1])]

    output = [[0.0, 0.0], [0.0, 0.0]]
    for i in range(2):
        for j in range(2):
            val = attn_weights[i][0] * V[0][j] + attn_weights[i][1] * V[1][j]
            output[i][j] = round(val, 4)

    return output
#include <iostream>
#include <vector>
#include <cmath>
#include <algorithm>
#include <iomanip>

std::vector<double> softmax_row(const std::vector<double>& row) {
    double max_val = *std::max_element(row.begin(), row.end());
    std::vector<double> exp_vals(row.size());
    double sum_exp = 0.0;
    for (size_t i = 0; i < row.size(); ++i) {
        exp_vals[i] = std::exp(row[i] - max_val);
        sum_exp += exp_vals[i];
    }
    std::vector<double> res(row.size());
    for (size_t i = 0; i < row.size(); ++i) {
        res[i] = exp_vals[i] / sum_exp;
    }
    return res;
}

std::vector<std::vector<double>> scaled_dot_product_attention(
    const std::vector<std::vector<double>>& Q,
    const std::vector<std::vector<double>>& K,
    const std::vector<std::vector<double>>& V
) {
    double scale = std::sqrt(2.0);
    std::vector<std::vector<double>> scores(2, std::vector<double>(2, 0.0));

    for (int i = 0; i < 2; ++i) {
        for (int j = 0; j < 2; ++j) {
            double dot = Q[i][0] * K[j][0] + Q[i][1] * K[j][1];
            scores[i][j] = dot / scale;
        }
    }

    std::vector<std::vector<double>> weights(2);
    weights[0] = softmax_row(scores[0]);
    weights[1] = softmax_row(scores[1]);

    std::vector<std::vector<double>> output(2, std::vector<double>(2, 0.0));
    for (int i = 0; i < 2; ++i) {
        for (int j = 0; j < 2; ++j) {
            double val = weights[i][0] * V[0][j] + weights[i][1] * V[1][j];
            output[i][j] = std::round(val * 10000.0) / 10000.0;
        }
    }
    return output;
}
Phân tích độ phức tạp thuật toán
- Độ phức tạp thời gian: Nhân ma trận \(\mathbf{Q} \mathbf{K}^T\) giữa hai chuỗi có độ dài \(N\) và chiều vector \(d\) tiêu tốn \(\mathcal{O}(N^2 \cdot d)\) phép toán. Khi chuỗi văn bản \(N\) tăng dài (ví dụ \(N = 32.000\) tokens), chi phí tính toán tỷ lệ với bình phương độ dài chuỗi \(\mathcal{O}(N^2)\). Đây là nút thắt cổ chai lớn nhất của Attention chuẩn.
- Độ phức tạp không gian: Lưu trữ ma trận chú ý \(N \times N\) đòi hỏi bộ nhớ \(\mathcal{O}(N^2)\), thúc đẩy các nghiên cứu về FlashAttention tối ưu bộ nhớ đệm SRAM của GPU.
7. Các biến thể kiến trúc Transformer hiện đại
Tùy thuộc vào mục tiêu bài toán, cộng đồng AI đã chia Transformer thành 3 nhánh chính:
- Encoder-only (ví dụ BERT, RoBERTa): Chỉ sử dụng khối Encoder, cho phép chú ý hai chiều (Bidirectional Attention). Phù hợp nhất cho các bài toán hiểu ngôn ngữ như phân loại văn bản, trích xuất thực thể, tìm kiếm ngữ nghĩa.
- Decoder-only (ví dụ GPT-3, GPT-4, LLaMA, Mistral): Chỉ sử dụng khối Decoder với cơ chế Masked Attention (ngăn từ hiện tại nhìn thấy các từ trong tương lai). Đây là kiến trúc thống trị tuyệt đối trong kỷ nguyên Generative AI và Large Language Models hiện nay.
- Encoder-Decoder (ví dụ T5, BART): Giữ nguyên cấu trúc nguyên bản, cực kỳ mạnh mẽ cho các bài toán chuyển đổi văn bản sang văn bản như dịch thuật và tóm tắt nội dung.
8. Bài tập vận dụng và câu hỏi phỏng vấn
- Câu hỏi: Tại sao Layer Normalization lại được ưu tiên sử dụng trong Transformer thay vì Batch Normalization?
- Gợi ý trả lời: Batch Normalization tính toán trung bình và phương sai trên toàn bộ mini-batch. Trong xử lý ngôn ngữ, các câu có độ dài rất khác nhau và batch size thực tế có thể thay đổi liên tục, khiến thống kê của BatchNorm bị nhiễu. Layer Normalization chuẩn hóa độc lập trên từng mẫu dữ liệu đơn lẻ dựa trên tất cả các đặc trưng ẩn của chính từ đó, hoàn toàn độc lập với batch size và chiều dài chuỗi.
- Câu hỏi: FlashAttention giúp tăng tốc độ huấn luyện mô hình Transformer như thế nào dù không làm thay đổi kết quả toán học?
- Gợi ý trả lời: FlashAttention tối ưu hóa phân cấp bộ nhớ GPU (Memory Hierarchy). Thay vì ghi ma trận chú ý \(N \times N\) khổng lồ ra bộ nhớ chính HBM rồi đọc lại (bị giới hạn băng thông bộ nhớ), FlashAttention chia nhỏ ma trận thành các khối nhỏ (tiling) và tính toán hợp nhất Softmax trực tiếp ngay trong bộ nhớ đệm nhanh SRAM của GPU.
9. Đào sâu cơ chế Mã hóa Vị trí Hiện đại: RoPE và ALiBi
Mặc dù mã hóa vị trí hình sin (Sinusoidal Positional Encoding) trong bài báo gốc năm 2017 rất đẹp đẽ về mặt toán học, các kiến trúc LLM hiện đại (như LLaMA 3, Mistral, Gemma) đã chuyển dịch sang các kỹ thuật tiên tiến hơn để hỗ trợ mở rộng chiều dài ngữ cảnh (Context Window Extension).
9.1. Nhúng vị trí quay Rotary Position Embedding (RoPE)
Do Jianlin Su et al. (2021) phát minh, RoPE là kỹ thuật mã hóa vị trí thống trị tuyệt đối trong các mô hình mã nguồn mở hiện nay. Thay vì cộng thêm một vector vị trí vào đầu vào, RoPE nhân vector Query và Key với một ma trận quay trực giao trong không gian 2 chiều:
Đối với mỗi cặp tọa độ \((q_{2i}, q_{2i+1})\) của vector Query tại vị trí \(m\):
\[\begin{pmatrix} q_{2i}' \\ q_{2i+1}' \end{pmatrix} = \begin{pmatrix} \cos(m \theta_i) & -\sin(m \theta_i) \\ \sin(m \theta_i) & \cos(m \theta_i) \end{pmatrix} \begin{pmatrix} q_{2i} \\ q_{2i+1} \end{pmatrix}\]
Trong đó tần số góc được định nghĩa:
\[\theta_i = 10000^{-2i / d}\]
Đặc tính đột phá của RoPE là tích vô hướng giữa Query tại vị trí \(m\) và Key tại vị trí \(n\) sau khi biến đổi chỉ phụ thuộc thuần túy vào khoảng cách vị trí tương đối \(m - n\):
\[\langle \mathbf{R}_{\Theta, m} \mathbf{q}, \, \mathbf{R}_{\Theta, n} \mathbf{k} \rangle = \mathbf{q}^T \mathbf{R}_{\Theta, n-m} \mathbf{k}\]
Điều này cho phép mô hình dễ dàng tổng quát hóa từ câu văn ngắn sang văn bản dài hàng chục nghìn tokens thông qua các kỹ thuật co giãn tần số như RoPE Scaling (NTK-aware Interpolation hay YaRN).
9.2. ALiBi (Attention with Linear Biases)
Được đề xuất bởi Press et al. (2022), ALiBi loại bỏ hoàn toàn vector nhúng vị trí ở tầng đầu vào. Thay vào đó, nó cộng trực tiếp một ma trận phạt tuyến tính vào điểm số chú ý trước khi đưa qua Softmax:
\[\text{Attention Scores} = \frac{\mathbf{Q} \mathbf{K}^T}{\sqrt{d_k}} - m \cdot |i - j|\]
Trong đó hệ số dốc \(m\) là một hằng số cố định theo từng đầu chú ý (ví dụ \(2^{-8/h}\)). ALiBi ép buộc mô hình ưu tiên chú ý đến các từ ngữ lân cận và cho phép mở rộng chiều dài suy luận vượt xa độ dài dữ liệu huấn luyện mà không cần tinh chỉnh lại.
10. Sự khác biệt giữa Pre-LN và Post-LN: Bài toán Ổn định Huấn luyện
Trong bài báo Transformer gốc (2017), khối chuẩn hóa LayerNorm được đặt phía sau kết nối tắt phần dư, gọi là kiến trúc Post-LN:
\[\mathbf{x}_{l} = \text{LayerNorm}(\mathbf{x}_{l-1} + \text{SubLayer}(\mathbf{x}_{l-1}))\]
Vấn đề nghiêm trọng của Post-LN là khi mạng nơ-ron trở nên rất sâu (trên 30 tầng), gradient tại các tầng gần đầu ra có xu hướng bùng nổ biên độ lớn, đòi hỏi quá trình huấn luyện phải có giai đoạn "khởi động mềm" (warmup phase) cực kỳ mong manh với tốc độ học nhỏ để tránh sụp đổ mô hình.
Các mô hình Transformer hiện đại đã chuyển hoàn toàn sang kiến trúc Pre-LN:
\[\mathbf{x}_{l} = \mathbf{x}_{l-1} + \text{SubLayer}(\text{LayerNorm}(\mathbf{x}_{l-1}))\]
Ở kiến trúc Pre-LN, đường truyền chính của kết nối tắt (residual stream) là một đường cao tốc tuyến tính thuần túy: \(\mathbf{x}_L = \mathbf{x}_0 + \sum_{l=1}^L \text{SubLayer}(\text{LayerNorm}(\mathbf{x}_{l-1}))\). Gradient có thể chảy thẳng tắp từ tầng cuối cùng về tầng đầu tiên mà không bị ma trận chuẩn hóa làm biến dạng, giúp việc huấn luyện mô hình hàng trăm tầng trở nên cực kỳ ổn định ngay từ bước lặp đầu tiên.
Ngoài ra, biến thể RMSNorm (Root Mean Square Normalization) của Zhang & Sennrich (2019) đã lược bỏ thao tác tính giá trị trung bình \(\mu\), chỉ chuẩn hóa theo căn bậc hai của bình phương trung bình:
\[\text{RMS}(\mathbf{x}) = \sqrt{\frac{1}{d} \sum_{i=1}^d x_i^2 + \epsilon}, \quad \bar{x}_i = \frac{x_i}{\text{RMS}(\mathbf{x})} \cdot \gamma_i\]
Bài báo gốc (Zhang và Sennrich, 2019) đo được thời gian chạy giảm 7% đến 64% tùy mô hình, với chất lượng tương đương LayerNorm chuẩn.
11. Khối Giải mã Masked Multi-Head Attention trong LLM
Trong kiến trúc Decoder-only (như GPT và LLaMA), mô hình không được phép nhìn thấy các từ trong tương lai khi dự đoán từ tiếp theo trong quá trình huấn luyện song song. Để thực hiện điều này, một ma trận mặt nạ nhân quả (Causal Mask) được cộng vào ma trận điểm số trước khi tính Softmax:
\[\mathbf{M}_{ij} = \begin{cases} 0 & \text{nếu } i \ge j \\ -\infty & \text{nếu } i \lt j \end{cases}\]
\[\text{Masked Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q} \mathbf{K}^T}{\sqrt{d_k}} + \mathbf{M}\right) \mathbf{V}\]
Khi phần tử mang giá trị \(-\infty\), hàm Softmax sẽ cho ra chính xác \(\exp(-\infty) = 0\). Nhờ đó, từ ở vị trí thứ \(i\) chỉ có thể phân bổ trọng số chú ý cho các vị trí từ \(1\) đến \(i\), ngăn chặn hoàn toàn việc rò rỉ thông tin tương lai trong khi vẫn cho phép huấn luyện song song toàn bộ câu văn trên GPU: số bước phải chạy tuần tự chỉ là \(\mathcal{O}(1)\), còn tổng khối lượng tính toán vẫn là \(\mathcal{O}(N^2 \cdot d)\).
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.