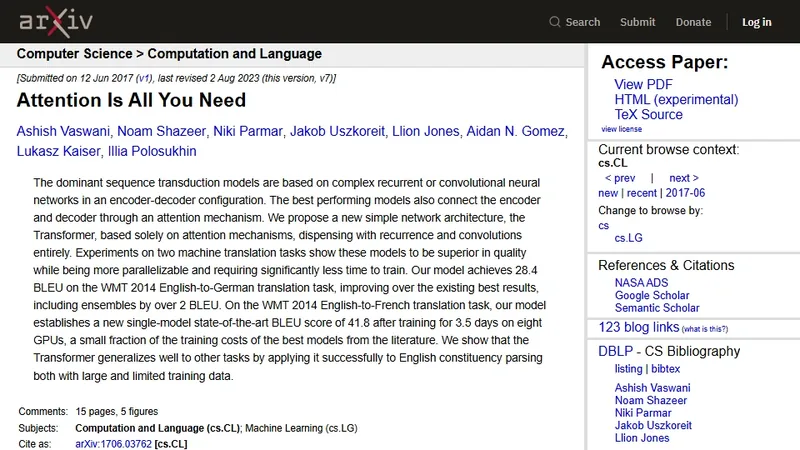
- Bản chất dự đoán token tự hồi quy: LLM hoạt động theo cơ chế Decoder-only Autoregressive: tại mỗi bước, mô hình tính toán phân phối xác suất trên toàn bộ từ điển để chọn ra token tiếp theo, nối token này vào văn bản rồi lặp lại quy trình.
- Chiến lược lấy mẫu điều khiển tư duy: Tham số Temperature điều chỉnh độ phẳng của phân phối xác suất, trong khi kỹ thuật Top-K và Top-P (Nucleus Sampling) kiểm soát sự cân bằng giữa tính chính xác logic và độ sáng tạo bất ngờ của câu trả lời.
- Tam giác huấn luyện hiện đại: Một LLM thông minh trải qua 3 giai đoạn chặt chẽ: Tiền huấn luyện tự giám sát (Pre-training) học tri thức thế giới, Tinh chỉnh có giám sát (Supervised Fine-Tuning - SFT) học định dạng hội thoại, và Căn chỉnh theo phản hồi con người (RLHF / DPO) định hướng tính an toàn và hữu ích.
1. Bản chất cốt lõi: Bộ dự đoán từ tiếp theo (Next-Token Prediction)
Khi người dùng gửi một câu lệnh (prompt) phức tạp vào ChatGPT hoặc Claude, ví dụ: "Hãy viết giải thuật sắp xếp nhanh bằng C++", mô hình không hề "suy nghĩ" theo cách con người cảm nhận. Thay vào đó, toàn bộ kiến trúc khổng lồ hàng trăm tỷ tham số thực hiện một bài toán xác suất thống kê có điều kiện:
\[P(w_1, w_2, \dots, w_T) = \prod_{t=1}^T P(w_t \mid w_1, w_2, \dots, w_{t-1})\]
Tại mỗi bước thời gian \(t\):
- Mô hình tiếp nhận toàn bộ chuỗi token đã có từ trước: \(w_1, w_2, \dots, w_{t-1}\).
- Dữ liệu đi qua hàng chục tầng Transformer Decoder với cơ chế Masked Self-Attention để đảm bảo các token chỉ có thể chú ý tới những token xuất hiện trước nó.
- Tầng cuối cùng ánh xạ trạng thái ẩn thành một vector số thực gọi là Logits \(\mathbf{z} \in \mathbb{R}^V\), với \(V\) là kích thước từ điển (thường từ \(32.000\) đến \(128.000\) tokens).
- Vector Logits được đưa qua hàm Softmax để chuyển đổi thành phân phối xác suất của từng token trong từ điển.
- Thuật toán lấy mẫu (Sampling Strategy) chọn ra một token \(w_t\).
- Token \(w_t\) vừa được chọn lập tức được ghép vào cuối chuỗi ngữ cảnh, và chu trình lặp lại từ đầu để dự đoán token \(w_{t+1}\) cho đến khi mô hình sinh ra ký hiệu kết thúc đặc biệt
[EOS](End-Of-Sequence).
2. Các chiến lược lấy mẫu (Generation Strategies & Sampling)
Một vector xác suất Softmax không tự động tạo ra văn bản; hệ thống cần một chiến lược chọn token từ phân phối đó. Sự khác biệt giữa câu trả lời chặt chẽ như lập trình viên và câu văn thơ bay bổng nằm ở các siêu tham số lấy mẫu này.
2.1. Greedy Search (Tìm kiếm tham lam)
Chiến lược đơn giản nhất là luôn luôn chọn token có xác suất cao nhất:
\[w_t = \arg\max_{w \in V} P(w \mid w_{1:t-1})\]
- Ưu điểm: Tính toán nhanh, tính xác định tuyệt đối (cùng prompt luôn cho ra cùng câu trả lời). Rất thích hợp cho các bài toán giải toán học, viết code hoặc trích xuất dữ liệu có cấu trúc JSON.
- Nhược điểm: Dễ rơi vào bẫy lặp từ vô tận (ví dụ: "hệ thống này là hệ thống rất là rất là...") và bỏ qua các đường dẫn câu văn có xác suất tổng thể cao hơn nhưng bước đầu tiên có xác suất hơi thấp.
2.2. Nhiệt độ lấy mẫu (Temperature T)
Kỹ thuật Temperature mượn khái niệm từ nhiệt động lực học thống kê Boltzmann để định hình lại độ phẳng của phân phối xác suất trước khi đưa qua hàm Softmax:
\[P(w_i) = \frac{\exp(z_i / T)}{\sum_{j=1}^V \exp(z_j / T)}\]
- Khi \(T \to 0\): Phép chia cho số cực nhỏ khiến phần tử lớn nhất áp đảo hoàn toàn các phần tử còn lại, phân phối xác suất trở thành hàm Dirac Delta. Mô hình hành xử hệt như Greedy Search.
- Khi \(T = 1.0\): Giữ nguyên phân phối xác suất tự nhiên được mô hình học từ tập dữ liệu huấn luyện.
- Khi \(T \gt 1.0\) (ví dụ \(T = 1.5\)): Các điểm số logit bị co hẹp lại, khoảng cách chênh lệch giữa các token bị thu nhỏ. Phân phối xác suất trở nên phẳng hơn (gần với phân phối đều), tạo cơ hội cho các token hiếm được chọn, giúp văn bản sinh ra giàu tính ẩn dụ, bất ngờ và sáng tạo nghệ thuật. Tuy nhiên nếu đặt \(T\) quá cao (\(T \gt 2.0\)), văn bản sẽ biến thành chuỗi từ ngữ vô nghĩa.
2.3. Lấy mẫu Top-K
Kỹ thuật Top-K giới hạn không gian lựa chọn chỉ trong tập hợp \(K\) token có xác suất cao nhất, toàn bộ các token đứng sau hạng \(K\) sẽ bị gán xác suất bằng \(0\):
\[V^{(K)} = \{w \in V \mid \text{rank}(P(w)) \le K\}\]
Sau đó chuẩn hóa lại xác suất của \(K\) token này để tổng bằng \(1\). Top-K (thường chọn \(K = 40\) hoặc \(K = 50\)) ngăn chặn triệt để nguy cơ mô hình chọn phải các từ ngớ ngẩn thuộc phần đuôi xác suất dài (long tail).
2.4. Lấy mẫu Top-P (Nucleus Sampling)
Nhược điểm của Top-K là con số \(K\) bị cố định cứng nhắc:
- Trong ngữ cảnh câu đã rõ nghĩa (ví dụ "Mặt trời mọc ở hướng..."), chỉ có duy nhất 1 từ đúng là "Đông", \(K=40\) sẽ nạp thêm 39 từ thừa.
- Trong ngữ cảnh mở, có hàng trăm từ đều hợp lý, \(K=40\) lại quá gò bó.
Top-P giải quyết bài toán này bằng cách chọn tập hợp nhỏ nhất các token có tổng xác suất tích lũy vượt qua ngưỡng \(P\) (thường chọn \(P = 0.9\) hoặc \(0.95\)):
\[\sum_{w \in V^{(P)}} P(w) \ge P\]
Số lượng token trong \(V^{(P)}\) sẽ tự động mở rộng khi ngữ cảnh phức tạp và tự động co lại thành một vài từ khi ngữ cảnh đơn nhất.
3. Ba giai đoạn kiến tạo nên một Mô hình Ngôn ngữ Lớn
Nhiều người lầm tưởng rằng chỉ cần nạp dữ liệu vào máy tính là có ngay một trợ lý AI thông minh. Thực tế, quy trình đào tạo một LLM cấp độ công nghiệp (Foundation Model) bắt buộc phải trải qua ba chặng đường nghiêm ngặt:
[Hàng chục nghìn tỷ Token]
            ↓
┌───────────────────────────────────────┐
│ 1. TIỀN HUẤN LUYỆN (PRE-TRAINING)     │ → Chiếm 95% chi phí (Hàng nghìn GPU)
│    Học quy luật ngôn ngữ & tri thức   │   Mô hình nền tảng (Base Model)
└───────────────────────────────────────┘
            ↓
┌───────────────────────────────────────┐
│ 2. TINH CHỈNH CÓ GIÁM SÁT (SFT)       │ → Dạy cách trả lời đúng câu hỏi
│    Cặp Prompt - Response chuẩn mực    │   Mô hình lệnh (Instruction Model)
└───────────────────────────────────────┘
            ↓
┌───────────────────────────────────────┐
│ 3. CĂN CHỈNH AN TOÀN (RLHF / DPO)     │ → Loại bỏ độc hại, căn chỉnh đạo đức
│    Tối ưu theo đánh giá của con người │   Mô hình sẵn sàng triển khai
└───────────────────────────────────────┘
3.1. Chặng 1: Tiền huấn luyện (Pre-training)
Đây là giai đoạn tốn kém hàng triệu đến hàng chục triệu USD tiền điện toán GPU. Mô hình được đọc hàng chục nghìn tỷ token văn bản từ sách báo, Wikipedia, mã nguồn GitHub và toàn bộ dữ liệu web Common Crawl. Mô hình học theo phương thức tự giám sát (Self-Supervised Learning) với mục tiêu duy nhất: đoán từ tiếp theo. Qua hàng tỷ tỷ lần đoán và sửa sai, mô hình âm thầm hình thành trong các ma trận trọng số của mình cấu trúc ngữ pháp ngôn ngữ, kiến thức lịch sử, khoa học, logic toán học và khả năng viết code. Kết quả của giai đoạn này là Base Model (chưa thể trò chuyện, chỉ giỏi viết tiếp văn bản).
3.2. Chặng 2: Tinh chỉnh có giám sát (Supervised Fine-Tuning - SFT)
Base model nếu nhận câu hỏi: "Thủ đô của nước Pháp là gì?", rất có thể nó sẽ viết tiếp thành: "Thủ đô của nước Đức là gì? Thủ đô của nước Ý là gì?" vì nó tưởng đây là một bài kiểm tra trắc nghiệm.
Giai đoạn SFT huấn luyện mô hình trên hàng trăm nghìn mẫu hội thoại chất lượng cao do chuyên gia biên soạn theo định dạng:
User: [Câu hỏi] \(\to\) Assistant: [Câu trả lời chính xác, mạch lạc].
Nhờ đó, mô hình học được vai trò của một trợ lý AI biết lắng nghe và giải đáp yêu cầu.
3.3. Chặng 3: Căn chỉnh giá trị con người (RLHF / DPO)
Một mô hình dù thông minh nhưng có thể đưa ra hướng dẫn chế tạo vũ khí nguy hiểm, phân biệt chủng tộc hoặc sinh ra thông tin sai sự thật (ảo giác - hallucination). Kỹ thuật RLHF (Reinforcement Learning from Human Feedback) huấn luyện một mô hình chấm điểm phần thưởng (Reward Model) từ đánh giá của con người rồi dùng nó để tối ưu mô hình; còn DPO (Direct Preference Optimization) học thẳng từ các cặp câu trả lời được con người chọn, không cần Reward Model riêng (xem mục 8). Cả hai cùng hướng mô hình tới 3 tiêu chí vàng HHH:
- Helpful (Hữu ích): Giải quyết đúng trọng tâm yêu cầu.
- Honest (Trung thực): Thừa nhận khi không biết, không bịa đặt nguồn tin.
- Harmless (Vô hại): Từ chối các yêu cầu vi phạm đạo đức và pháp luật.
Chủ đề này nằm trong Lecture 14 - Neural Networks của Khóa AI. Xem đề cương
4. Cài đặt thuật toán kiểm thử: Softmax có Nhiệt độ (Temperature Softmax)
Dưới đây là mã nguồn cài đặt bước chuẩn hóa vector Logits với tham số Temperature trong cả Python và C++17. Thuật toán bao gồm kỹ thuật trừ giá trị cực đại \(\max(z)\) để đảm bảo an toàn tuyệt đối tránh tràn số dấu phẩy động (Numerical Stability):
import math

def temperature_softmax(logits, temperature):
    scaled = [x / temperature for x in logits]
    max_val = max(scaled)
    exp_vals = [math.exp(x - max_val) for x in scaled]
    sum_exp = sum(exp_vals)
    return [round(x / sum_exp, 4) for x in exp_vals]
#include <iostream>
#include <vector>
#include <cmath>
#include <algorithm>
#include <iomanip>

std::vector<double> temperature_softmax(const std::vector<double>& logits, double temperature) {
    std::vector<double> scaled(logits.size());
    for (size_t i = 0; i < logits.size(); ++i) {
        scaled[i] = logits[i] / temperature;
    }
    double max_val = *std::max_element(scaled.begin(), scaled.end());
    std::vector<double> exp_vals(scaled.size());
    double sum_exp = 0.0;
    for (size_t i = 0; i < scaled.size(); ++i) {
        exp_vals[i] = std::exp(scaled[i] - max_val);
        sum_exp += exp_vals[i];
    }
    std::vector<double> res(scaled.size());
    for (size_t i = 0; i < scaled.size(); ++i) {
        res[i] = std::round((exp_vals[i] / sum_exp) * 10000.0) / 10000.0;
    }
    return res;
}
Phân tích độ ổn định số học
- Nếu không trừ \(\max(z_i / T)\), khi logits \(z_i = 1000\) và \(T = 0.5\), máy tính sẽ cố tính \(\exp(2000)\) dẫn đến tràn số vô cực (
inf) và sinh ra kết quảNaN. - Bằng cách biến đổi toán học: \[\frac{\exp((z_i - m)/T)}{\sum \exp((z_j - m)/T)} = \frac{\exp(z_i/T) \exp(-m/T)}{\sum \exp(z_j/T) \exp(-m/T)} = \frac{\exp(z_i/T)}{\sum \exp(z_j/T)}\] Giá trị lớn nhất trong số mũ luôn bằng \(\exp(0) = 1\), phép tính hoàn toàn an toàn và ổn định trên mọi phần cứng.
5. Hiện tượng Ảo giác (Hallucination) và Giới hạn của LLM
Dù cực kỳ ấn tượng, LLM vẫn tồn tại những điểm yếu bản chất mà người làm kỹ thuật phải thấu suốt:
- Ảo giác thông tin (Hallucination): Vì LLM là một mô hình sinh xác suất chứ không phải là một công cụ truy vấn cơ sở dữ liệu quan hệ, khi gặp những thông tin mà nó không chắc chắn, mô hình vẫn tự tin ghép nối các từ ngữ có vẻ hợp lý để trả lời, tạo ra các sự kiện, trích dẫn học thuật hoàn toàn không có thật.
- Cửa sổ ngữ cảnh giới hạn (Context Window Limit): Dù các mô hình hiện đại đã nâng cửa sổ ngữ cảnh lên \(128K\) hoặc \(1M\) tokens, chi phí tính toán và hiện tượng "Lost in the Middle" (bỏ quên thông tin quan trọng nằm ở giữa văn bản dài) vẫn là bài toán thách thức.
- Cắt đứt tri thức theo thời gian (Knowledge Cutoff): Mô hình bị đóng băng kiến thức tại thời điểm kết thúc giai đoạn Pre-training, không thể tự cập nhật tin tức hay dữ liệu mới phát sinh nếu không có các giải pháp mở rộng như RAG (Retrieval-Augmented Generation).
6. Bài tập vận dụng và câu hỏi phỏng vấn
- Câu hỏi: Trong một hệ thống RAG phục vụ tra cứu chính sách bảo hiểm y tế nội bộ, bạn sẽ cấu hình tham số
temperaturevàtop_pnhư thế nào? Tại sao?- Gợi ý trả lời: Nên giữ độ ngẫu nhiên thấp:
temperature = 0.0đến0.1(hoặc dùng thẳng Greedy Search), và chỉ chỉnh một trong hai tham sốtemperature,top_p, không chỉnh cả hai cùng lúc. Lưu ý một số mô hình mới (ví dụ vài mô hình Claude đời mới) không cho chỉnh các tham số này và trả lỗi nếu đặttemperature,top_phaytop_kkhác mặc định, nên hãy đọc tài liệu API của mô hình bạn dùng trước; khi đó độ ổn định đến từ câu lệnh chặt chẽ và ngữ cảnh RAG tốt. Trong bài toán tra cứu văn bản quy định và chính sách y tế, độ chính xác tuyệt đối và tính nhất quán được ưu tiên hàng đầu, hoàn toàn không chấp nhận sự sáng tạo ngẫu hứng hay suy đoán sai lệch.
- Gợi ý trả lời: Nên giữ độ ngẫu nhiên thấp:
- Câu hỏi: Giải thích tại sao một mô hình LLM có thể dễ dàng giải các bài toán đại số phức tạp nhưng lại thường xuyên đếm sai số lượng chữ cái 'r' trong từ "strawberry"?
- Gợi ý trả lời: Do cơ chế Tokenization. Mô hình không nhìn thấy từng chữ cái riêng lẻ ('s', 't', 'r', 'a', 'w', 'b', 'e', 'r', 'r', 'y') mà nhìn thấy từ này dưới dạng vài token nguyên khối (ví dụ bộ tách từ
cl100k_basecủa GPT-4 cắt "strawberry" thành 3 token: "str" (ID496), "aw" (ID675) và "berry" (ID15717)). Vì không trực tiếp thao tác ở cấp độ ký tự thô, mô hình chỉ suy luận dựa trên xác suất liên kết từ chứ không "đếm" chữ cái như mắt người.
- Gợi ý trả lời: Do cơ chế Tokenization. Mô hình không nhìn thấy từng chữ cái riêng lẻ ('s', 't', 'r', 'a', 'w', 'b', 'e', 'r', 'r', 'y') mà nhìn thấy từ này dưới dạng vài token nguyên khối (ví dụ bộ tách từ
7. Tối ưu hóa Tốc độ Suy luận: Cơ chế KV Cache
Khi triển khai mô hình ngôn ngữ lớn vào thực tế sản xuất, một thách thức khổng lồ xuất hiện: Độ trễ sinh từ (Inference Latency).
Trong quá trình sinh tự hồi quy, giả sử người dùng gửi vào một prompt dài 1.000 tokens và mô hình đang sinh token thứ 1.001. Nếu thực hiện tính toán ngây thơ (naive forward pass), mô hình sẽ phải tính lại toàn bộ ma trận Query, Key, Value của 1.000 token cũ. Đến khi sinh token thứ 1.002, mô hình lại tính lại từ token 1 đến 1.001. Tổng số phép tính toán ma trận Attention sẽ tăng vọt theo cấp số cộng \(\sum_{t=1}^N t = \mathcal{O}(N^2)\), gây lãng phí năng lượng tính toán khủng khiếp của GPU.
Giải pháp kinh điển cho vấn đề này là kỹ thuật KV Cache:
- Quan sát thấy rằng tại mỗi bước sinh mới, ta chỉ cần tạo vector Query duy nhất cho token hiện tại: \(\mathbf{q}_t = \mathbf{x}_t \mathbf{W}_Q\).
- Các vector Key và Value của các token trong quá khứ (\(\mathbf{k}_1, \dots, \mathbf{k}_{t-1}\) và \(\mathbf{v}_1, \dots, \mathbf{v}_{t-1}\)) hoàn toàn không bao giờ thay đổi.
- Do đó, hệ thống lưu trữ toàn bộ các vector Key và Value đã tính toán trước đó vào bộ nhớ VRAM của GPU dưới dạng bộ đệm KV Cache.
Tại mỗi bước giải mã, mô hình chỉ tính toán một vector \(\mathbf{q}_t\), ghép thêm \(\mathbf{k}_t, \mathbf{v}_t\) mới vào bộ đệm cache, và thực hiện phép nhân ma trận có độ phức tạp chỉ còn \(\mathcal{O}(N)\) thay vì \(\mathcal{O}(N^2)\).
Đánh đổi bộ nhớ VRAM của KV Cache:
Dung lượng bộ nhớ VRAM cần thiết để lưu trữ KV Cache cho một phiên suy luận được tính bằng công thức:
\[\text{Memory}_{\text{KV}} = 2 \times 2 \times n_{\text{layers}} \times n_{\text{kv}} \times d_{\text{head}} \times s \times b \quad (\text{bytes})\]
Trong đó:
- Hệ số 2 đầu tiên đại diện cho hai ma trận (Key và Value).
- Hệ số 2 thứ hai đại diện cho kiểu dữ liệu dấu phẩy động 16-bit (FP16 hoặc BF16 chiếm 2 bytes mỗi phần tử).
- \(n_{\text{layers}}\): số tầng Transformer.
- \(n_{\text{kv}}\): số đầu Key-Value (bằng số đầu chú ý nếu không dùng GQA); \(d_{\text{head}}\): số chiều của mỗi đầu.
- \(s\): chiều dài ngữ cảnh (context length).
- \(b\): kích thước batch size phục vụ đồng thời.
Ví dụ với mô hình LLaMA-2 70B (\(80\) tầng, \(64\) đầu chú ý, \(d_{\text{head}} = 128\), chiều dài ngữ cảnh \(4.096\) tokens): nếu mỗi đầu giữ Key-Value riêng như Multi-Head Attention gốc thì mỗi người dùng tiêu tốn khoảng \(10.7\text{GB}\) VRAM chỉ để lưu bộ đệm KV Cache. Vì vậy LLaMA-2 70B dùng Grouped-Query Attention (GQA) với \(8\) nhóm Key-Value dùng chung giữa các đầu chú ý, đưa con số này xuống khoảng \(1.34\text{GB}\); còn kỹ thuật quản lý bộ nhớ phân trang PagedAttention (trong thư viện vLLM) giúp chống phân mảnh bộ nhớ VRAM.
8. Giải mã Kỹ thuật Căn chỉnh DPO (Direct Preference Optimization)
Trong nhiều năm, thuật toán PPO (Proximal Policy Optimization) kết hợp mô hình phần thưởng (Reward Model) là phương pháp chuẩn mực của quy trình RLHF (được OpenAI áp dụng trên InstructGPT và ChatGPT). Tuy nhiên, PPO khét tiếng là phức tạp, đòi hỏi phải chạy đồng thời 4 mô hình lớn trong bộ nhớ GPU: Actor (chính sách sinh câu), Critic (ước lượng giá trị), Reference Model (mô hình gốc để phạt độ lệch KL) và Reward Model. Quá trình huấn luyện rất dễ bị mất ổn định số học.
Năm 2023, Rafael Rafailov et al. tại Đại học Stanford công bố bước đột phá mang tên Direct Preference Optimization (DPO).
DPO chứng minh bằng toán học chặt chẽ rằng bài toán tối ưu chính sách có ràng buộc phân kỳ KL dưới mô hình phần thưởng Bradley-Terry:
\[\max_{\pi_\theta} \mathbb{E}_{x \sim \mathcal{D}, y \sim \pi_\theta} [r(x, y)] - \beta \mathbb{D}_{KL}(\pi_\theta(y \mid x) \parallel \pi_{\text{ref}}(y \mid x))\]
có thể được giải dạng đóng chính xác để biểu diễn hàm phần thưởng ngầm thông qua tỷ lệ xác suất log giữa chính sách mới và chính sách tham chiếu:
\[r(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)\]
Khi thay thế biểu thức này vào hàm mất mát phân loại sở thích nhị phân (câu trả lời được con người ưa thích \(y_w\) so với câu trả lời bị từ chối \(y_l\)), ta thu được hàm mất mát DPO tuyệt đẹp:
\[\mathcal{L}_{\text{DPO}}(\pi_\theta; \pi_{\text{ref}}) = -\mathbb{E}_{(x, y_w, y_l)} \left[ \log \sigma \left( \beta \log \frac{\pi_\theta(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} - \beta \log \frac{\pi_\theta(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)} \right) \right]\]
DPO loại bỏ hoàn toàn việc huấn luyện Reward Model riêng biệt, không cần lấy mẫu câu trả lời từ mô hình trong lúc huấn luyện, chuyển bài toán học tăng cường phức tạp thành bài toán tối ưu hồi quy logistic đơn giản và ổn định vượt bậc. Hiện nay, hầu hết các mô hình LLM mã nguồn mở hàng đầu đều áp dụng DPO làm bước căn chỉnh an toàn cuối cùng.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.