- Bắt đầu từ câu hỏi bạn cần trả lời bằng số liệu, rồi mới soạn câu hỏi khảo sát; câu nào không phục vụ mục tiêu thì bỏ.
- Pew Research Center khuyên mỗi câu chỉ hỏi một ý; câu hai ý khó trả lời và khó hiểu kết quả.
- Dạng đồng ý hay không đồng ý dễ bị trả lời xuôi theo câu; nên hỏi trực tiếp. Thang đo nên cân đối số mức tích cực và tiêu cực.
- Thử bảng hỏi với vài người trước khi gửi cả lớp; Pew coi thử trước là bước thiết yếu.
Code trong bài là Python, chỉ dùng thư viện chuẩn. Khảo sát câu lạc bộ trong ví dụ là giả lập.
Một câu hỏi lệch làm hỏng cả bộ số liệu
Trang hướng dẫn viết câu hỏi khảo sát của Pew Research Center, một trung tâm nghiên cứu dư luận lớn của Mỹ, nêu nhiều điều mà người làm khảo sát lần đầu hay bỏ qua. Nên hỏi mỗi lần một ý: câu yêu cầu đánh giá hơn một khái niệm, gọi là câu hai ý, khó trả lời và thường cho kết quả khó diễn giải. Thứ tự các lựa chọn có thể ảnh hưởng tới câu trả lời, nên với danh sách không có thứ tự tự nhiên, Pew xáo thứ tự cho từng người; còn thang đo như rất tốt, tốt, tạm, kém thì giữ đúng thứ tự vì thứ tự đó mang thông tin. Dạng đồng ý hay không đồng ý là một trong những dạng phổ biến nhất, nhưng nghiên cứu cho thấy một số nhóm người trả lời có xu hướng đồng ý với câu được đưa ra nhiều hơn, gọi là thiên lệch xuôi theo. Và Pew coi việc thử trước bảng hỏi là bước thiết yếu.
Những lỗi này không lộ ra khi đọc bảng hỏi; chúng lộ ra khi bạn nhìn số liệu và không biết con số nghĩa là gì. AI viết bảng hỏi trơn tru nên càng khó thấy. Các prompt dưới đây đưa thẳng những nguyên tắc đó vào yêu cầu.
Prompt 1: từ mục tiêu tới danh sách câu hỏi cần trả lời
Mình làm khảo sát cho [mục đích, ví dụ: ban điều hành câu lạc bộ tin học quyết định kế hoạch học kỳ sau].
Người trả lời: [ai, khoảng bao nhiêu người]. Thời gian làm khảo sát tối đa: 5 phút.
Trước khi soạn câu hỏi khảo sát, liệt kê 3 đến 5 câu hỏi mà BAN ĐIỀU HÀNH cần trả lời bằng số liệu
(ví dụ: "nên tổ chức workshop bao lâu một lần"), mỗi câu kèm quyết định nó giúp đưa ra.
Chưa soạn bảng hỏi.
Bước này giúp bảng hỏi ngắn: câu khảo sát nào không phục vụ một quyết định cụ thể thì không cần hỏi. Người trả lời tình nguyện thường bỏ dở khảo sát dài.
Prompt 2: soạn bảng hỏi theo nguyên tắc
Dựa trên các câu hỏi cần trả lời đã chốt, soạn bảng hỏi khảo sát tối đa 10 câu.
Nguyên tắc bắt buộc:
- Mỗi câu chỉ hỏi một ý; không nối hai thứ bằng "và" trong một câu đánh giá.
- Không dùng từ khen chê sẵn trong câu (như "tuyệt vời", "tệ") và không gợi ý câu trả lời mong muốn.
- Không dùng dạng "Bạn có đồng ý rằng..."; hỏi trực tiếp điều cần biết.
- Câu dạng thang: dùng thang 5 mức cân đối, có mức giữa (ví dụ: Rất hài lòng, Hài lòng, Bình thường, Không hài lòng, Rất không hài lòng).
- Câu chọn một: các lựa chọn không chồng lên nhau, có thêm "Khác" nếu danh sách có thể chưa đủ.
- Câu hỏi riêng tư (điểm số, hoàn cảnh) chỉ hỏi nếu thật cần, và cho phép bỏ qua.
Trả về một mảng JSON, mỗi câu: {"cau_hoi": "...", "loai": "chon_mot" | "chon_nhieu" | "thang" | "mo", "lua_chon": [...]}
Khuôn JSON vừa để đoạn code soát đọc được, vừa dễ chuyển sang biểu mẫu trực tuyến bạn định dùng.
Prompt 3: soát bảng hỏi như người làm nghiên cứu
Đóng vai người làm nghiên cứu khảo sát khó tính. Đọc bảng hỏi dưới đây và chỉ ra, trích đúng câu:
1. Câu hỏi hai ý trong một.
2. Câu dẫn dắt hoặc giả định sẵn điều chưa chắc đúng.
3. Lựa chọn chồng lên nhau, thiếu, hoặc thang đo lệch.
4. Từ ngữ người trả lời có thể hiểu theo nhiều cách (như "thường xuyên").
5. Thứ tự câu hỏi có thể làm câu trước ảnh hưởng câu sau.
Không viết lại bảng hỏi, chỉ liệt kê và đề xuất cách sửa ngắn.
Prompt 4: viết lời mở đầu khảo sát
Viết lời mở đầu cho khảo sát, tối đa 60 chữ: ai làm khảo sát, để làm gì, mất bao lâu,
câu trả lời được dùng thế nào, có ẩn danh hay không (theo đúng cách mình làm: [ẩn danh / có ghi email]).
Không hứa điều mình không làm được, như "dữ liệu được bảo mật tuyệt đối".
Lời mở đầu trung thực về việc ẩn danh là điều tối thiểu; người trả lời có quyền biết câu trả lời của họ đi đâu.
Soát bảng hỏi bằng code
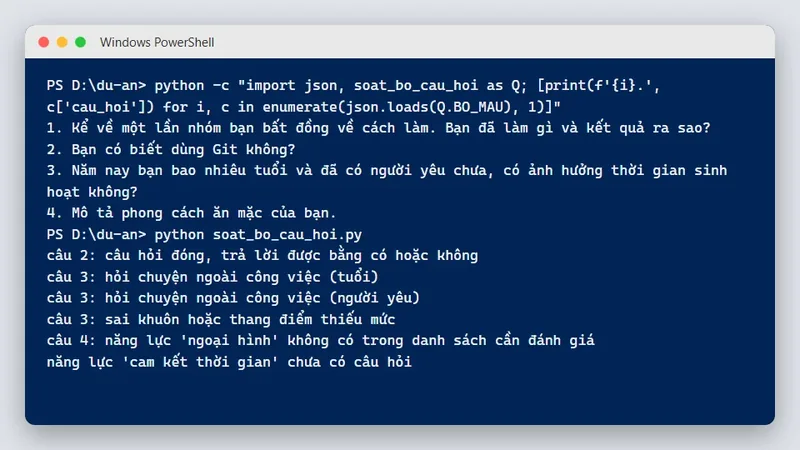
Đoạn Python dưới đây đọc bảng hỏi JSON theo khuôn của prompt 2 và kiểm các điểm ở trên: câu đánh giá hay chọn một có chữ "và" nối hai thứ, có thể là câu hai ý; câu có từ khen chê sẵn; câu dạng đồng ý hay không đồng ý; thang đo có số mức tích cực khác số mức tiêu cực; lựa chọn trùng nhau; câu chọn một thiếu "Khác". Đây là các quy tắc gợi ý; một câu bị báo vẫn cần người đọc lại.
"""Soát bộ câu hỏi khảo sát do AI soạn, theo các điểm trong hướng dẫn viết câu hỏi của Pew Research Center.

Khuôn mỗi câu: {"cau_hoi": chuỗi, "loai": "chon_mot" | "chon_nhieu" | "thang" | "mo", "lua_chon": [chuỗi, ...]}
Kiểm:
1. Câu hỏi hai ý trong một (Pew gọi là double-barreled): câu loại thang hay chọn một mà có chữ " và " nối hai thứ được hỏi.
2. Câu dẫn dắt: có từ khen chê sẵn trong câu hỏi như "tuyệt vời", "tệ".
3. Dạng đồng ý / không đồng ý: Pew ghi dạng này dễ bị thiên lệch xuôi theo câu hỏi; gợi ý hỏi trực tiếp.
4. Thang đo cân đối: số mức tích cực bằng số mức tiêu cực. Mức giữa là các mức trong MUC_GIUA (Bình thường, Trung
   bình, Không ý kiến...); mức tiêu cực là mức có một chữ trong CHU_TIEU_CUC (không, chưa, kém, tệ, ít, hiếm, yếu);
   các mức còn lại tính là tích cực.
5. Lựa chọn trùng nhau; câu chọn một thiếu lựa chọn "Khác" khi danh sách có thể chưa đủ.
Chỉ dùng thư viện chuẩn. Các quy tắc là gợi ý, cần người đọc lại.
"""
import json

TU_DAN = ["tuyệt vời", "tệ hại", "rất tốt", "kém cỏi", "tuyệt đối"]
MUC_GIUA = ("bình thường", "trung lập", "trung bình", "không ý kiến", "phân vân", "thỉnh thoảng")
CHU_TIEU_CUC = {"không", "chưa", "kém", "tệ", "ít", "hiếm", "yếu"}


def soat(van_ban_json):
    bo = json.loads(van_ban_json)
    bao = []
    for i, c in enumerate(bo, 1):
        cau, loai, lc = c["cau_hoi"], c["loai"], c.get("lua_chon", [])
        thuong = cau.lower()
        if loai in ("thang", "chon_mot") and " và " in thuong:
            bao.append(f"câu {i}: có thể hỏi hai ý trong một câu")
        bao += [f"câu {i}: câu dẫn dắt ({t})" for t in TU_DAN if t in thuong]
        if any("đồng ý" in x.lower() for x in lc):
            bao.append(f"câu {i}: dạng đồng ý / không đồng ý, nên hỏi trực tiếp")
        elif loai == "thang":
            trung_lap = sum(1 for x in lc if x.strip().lower() in MUC_GIUA)
            am = sum(1 for x in lc if x.strip().lower() not in MUC_GIUA and CHU_TIEU_CUC & set(x.lower().split()))
            duong = len(lc) - am - trung_lap
            if am != duong:
                bao.append(f"câu {i}: thang lệch, {duong} mức tích cực và {am} mức tiêu cực")
        if len({x.strip().lower() for x in lc}) < len(lc):
            bao.append(f"câu {i}: có lựa chọn trùng nhau")
        if loai == "chon_mot" and lc and not any(x.lower().startswith("khác") for x in lc):
            bao.append(f"câu {i}: thiếu lựa chọn 'Khác'")
    return bao


BO_MAU = json.dumps([
    {"cau_hoi": "Bạn đánh giá thế nào về nội dung và thời gian các buổi workshop?", "loai": "thang",
     "lua_chon": ["Rất hài lòng", "Hài lòng", "Bình thường", "Không hài lòng"]},
    {"cau_hoi": "Buổi workshop Python tuyệt vời vừa rồi giúp bạn thế nào?", "loai": "mo", "lua_chon": []},
    {"cau_hoi": "Câu lạc bộ nên tổ chức workshop thường xuyên hơn.", "loai": "thang",
     "lua_chon": ["Rất đồng ý", "Đồng ý", "Không đồng ý", "Rất không đồng ý"]},
    {"cau_hoi": "Bạn biết tới câu lạc bộ qua kênh nào?", "loai": "chon_mot",
     "lua_chon": ["Facebook", "Bạn bè", "Facebook", "Thông báo của khoa"]},
], ensure_ascii=False)

if __name__ == "__main__":
    for d in soat(BO_MAU):
        print(d)
Với bảng hỏi mẫu, chương trình báo sáu điều: câu 1 hỏi cả nội dung và thời gian, lại có thang bốn mức với hai mức tích cực nhưng chỉ một mức tiêu cực; câu 2 có chữ "tuyệt vời"; câu 3 dạng đồng ý hay không đồng ý; câu 4 có hai lựa chọn Facebook và thiếu "Khác". Phần kiểm đi kèm đối chiếu từng trường hợp với điểm tương ứng trong hướng dẫn của Pew bằng kết quả làm tay, và kiểm bảng hỏi đã sửa, trong đó câu 1 được tách thành hai câu và câu 3 được hỏi trực tiếp, không còn bị báo gì.
Khi kết quả chưa đúng thì sửa prompt thế nào
- Bảng hỏi quá dài. Giới hạn số câu và thời gian làm; yêu cầu mô hình ghi câu nào phục vụ quyết định nào, câu không ghi được thì bỏ.
- Vẫn có câu hai ý. Đưa ví dụ một câu hai ý và hai câu đã tách vào prompt.
- Lựa chọn chồng nhau, như "1 đến 3 lần" và "3 đến 5 lần". Yêu cầu các khoảng không giao nhau và phủ hết mọi trường hợp.
- Từ mơ hồ như "thường xuyên", "gần đây". Yêu cầu thay bằng mốc cụ thể: "trong 4 tuần qua", "bao nhiêu lần".
- Hỏi thông tin riêng không cần thiết. Nhắc nguyên tắc chỉ hỏi điều phục vụ mục tiêu; số điện thoại, địa chỉ hiếm khi cần cho khảo sát ý kiến.
- Câu mở quá nhiều. Câu mở khó tổng hợp; giữ một hai câu mở ở cuối cho ý kiến thêm.
Chọn loại câu hỏi cho đúng
Mỗi loại câu hợp với một kiểu thông tin. Câu chọn một hợp với câu hỏi có một đáp án, như năm học hay kênh biết tới câu lạc bộ chính. Câu chọn nhiều hợp khi người trả lời có thể có nhiều đáp án, nhưng Pew dẫn một nghiên cứu năm 2019 của trung tâm cho thấy câu buộc chọn thường cho câu trả lời chính xác hơn danh sách "chọn tất cả những gì phù hợp", nên với danh sách quan trọng có thể hỏi có hoặc không cho từng mục. Thang đo hợp với mức độ hài lòng hay mức độ quan tâm. Câu mở hợp với ý kiến chưa đoán trước được, nhưng tốn công đọc và tổng hợp, nên chỉ giữ một hai câu. Khi nhờ AI soạn, ghi rõ loại câu mong muốn cho từng câu hỏi cần trả lời ở prompt 1, thay vì để mô hình tự chọn.
Thử trước và tổng hợp
Trước khi gửi cả lớp, nhờ ba bốn người làm thử và hỏi họ câu nào khó hiểu, câu nào không biết chọn gì. Pew mô tả việc thử trước, cùng phỏng vấn nhận thức và nhóm thảo luận, là cách để hiểu người trả lời nghĩ gì khi đọc câu hỏi; với khảo sát nhỏ của sinh viên, vài người làm thử đã bắt được phần lớn lỗi. Khi có kết quả, dữ liệu khảo sát thường chứa tên hay email; nếu nhờ AI tổng hợp, làm theo cách trong bài dùng AI phân tích bảng dữ liệu an toàn: gửi mô tả hoặc dữ liệu đã che, không gửi danh sách thô. Nếu bạn soạn câu hỏi để phỏng vấn trực tiếp chứ không phải phát phiếu, bài prompt soạn câu hỏi phỏng vấn phù hợp hơn.
Ví dụ: khảo sát kế hoạch học kỳ của câu lạc bộ
Ban điều hành câu lạc bộ tin học muốn biết nên tổ chức workshop bao lâu một lần và về chủ đề gì. Prompt 1 chốt ba câu hỏi cần trả lời. Bản nháp đầu từ AI có một câu hỏi cả nội dung lẫn thời gian, một câu "buổi workshop tuyệt vời vừa rồi" và một câu dạng đồng ý. Đoạn code soát bắt được cả ba, cùng một thang đo bốn mức bị lệch. Ban sửa theo prompt 2, nhờ bốn bạn làm thử, và phát hiện thêm chữ "thường xuyên" làm mọi người hiểu khác nhau; ban đổi thành "trong 4 tuần qua". Khảo sát gửi đi có tám câu, mất khoảng ba phút, và số liệu thu về trả lời đúng ba câu hỏi ban đầu.
- Hỏi hai ý trong một câu.
- Đưa lời khen chê sẵn vào câu hỏi.
- Dùng dạng "Bạn có đồng ý rằng..." cho mọi câu.
- Dùng thang đo có nhiều mức tích cực hơn tiêu cực.
- Gửi khảo sát cho cả lớp mà không nhờ vài người làm thử.
- Hứa ẩn danh trong khi vẫn thu email người trả lời.
Câu hỏi thường gặp
Câu hỏi hai ý trong khảo sát là gì?
Là câu hỏi đánh giá hai thứ cùng lúc, như nội dung và thời gian; nên tách thành hai câu.
Vì sao không nên dùng dạng đồng ý hay không đồng ý?
Nghiên cứu cho thấy một số người có xu hướng đồng ý xuôi theo câu được đưa ra; hỏi trực tiếp thì rõ hơn.
Thang đo khảo sát nên có mấy mức?
Thang cân đối, số mức tích cực bằng số mức tiêu cực; thang 5 mức có mức giữa là cách hay dùng.
Có cần thử khảo sát trước khi gửi?
Có; Pew coi thử trước là bước thiết yếu, vài người làm thử đã bắt được nhiều lỗi.
Học tiếp
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.