- Học không giám sát (Unsupervised): Dữ liệu đầu vào chỉ có các đặc trưng \(X\), hoàn toàn không có nhãn giám sát \(y\). Mục tiêu là tự khám phá cấu trúc cụm tiềm ẩn.
- Quy trình lặp 2 bước: Bước 1 (Assignment) gán mỗi điểm vào tâm cụm gần nhất; Bước 2 (Update) tính lại tâm cụm bằng trung bình cộng tọa độ các điểm thành viên.
- Hàm mục tiêu Inertia: Tối thiểu hóa tổng bình phương khoảng cách từ các điểm tới tâm cụm tương ứng (Within-Cluster Sum of Squares - WCSS).
- Phương pháp Elbow & Silhouette: Công cụ khoa học giúp xác định số lượng cụm \(K\) tối ưu cho bài toán.
Phân cụm dữ liệu là gì?
Trong thực tế doanh nghiệp, phần lớn dữ liệu thu thập được đều không có nhãn: hàng triệu người dùng ứng dụng thương mại điện tử, hàng ngàn giao dịch mua sắm mỗi ngày. Làm thế nào để phân khúc khách hàng thành các nhóm đối tượng riêng biệt (như nhóm khách hàng chi tiêu cao, nhóm săn mã giảm giá, nhóm khách hàng mới) để triển khai các chiến dịch marketing mục tiêu?
Đó chính là bài toán của Phân cụm dữ liệu (Clustering). Mục tiêu là gom các điểm dữ liệu có đặc tính tương đồng vào cùng một cụm (Cluster), đồng thời đảm bảo các cụm khác nhau có khoảng cách tách biệt tối đa. Trong các thuật toán phân cụm, K-Means là phương pháp phổ biến, trực quan và có tốc độ tính toán nhanh nhất.
Các ứng dụng thực tiễn của K-Means bao gồm: phân khúc thị trường khách hàng, nén ảnh bằng cách lượng tử hóa màu sắc (Color Quantization), phân cụm văn bản theo chủ đề, phát hiện các giao dịch gian lận bất thường nằm cách xa mọi tâm cụm thông thường, và tiền xử lý giảm chiều dữ liệu trước khi nạp vào các mô hình học máy có giám sát.
Nguyên lý hoạt động và Thuật toán Lloyd
Giả sử ta cần phân chia tập dữ liệu gồm \(N\) điểm \(\{x_1, \dots, x_N\}\) thành \(K\) cụm riêng biệt \(S = \{S_1, S_2, \dots, S_K\}\). Mỗi cụm \(S_k\) được đại diện bởi một vector trọng tâm (Centroid) \(\mu_k \in \mathbb{R}^D\).
Hàm mất mát của K-Means, thường được gọi là Inertia hoặc WCSS (Within-Cluster Sum of Squares), đo lường tổng mức độ phân tán nội cụm:
\[J = \sum_{k=1}^K \sum_{i \in S_k} \|x_i - \mu_k\|_2^2\]
Mục tiêu là tìm các tập cụm \(S_k\) và các tâm cụm \(\mu_k\) sao cho hàm mục tiêu \(J\) đạt giá trị nhỏ nhất. Thuật toán tiêu chuẩn (thuật toán Lloyd) giải bài toán này thông qua quy trình lặp hai bước (Expectation-Maximization):
Bước 1: Khởi tạo (Initialization)
Chọn ngẫu nhiên \(K\) điểm trong không gian dữ liệu làm tọa độ ban đầu của \(K\) tâm cụm: \(\mu_1, \mu_2, \dots, \mu_K\).
Bước 2: Gán cụm (Cluster Assignment - E-step)
Với mỗi điểm dữ liệu \(x_i\), tính khoảng cách Euclidean từ \(x_i\) tới toàn bộ \(K\) tâm cụm. Gán \(x_i\) vào cụm có tâm gần nó nhất:
\[c_i = \arg\min_{k \in \{1, \dots, K\}} \|x_i - \mu_k\|_2^2\]
Về mặt hình học, bước này tạo ra một phân hoạch Voronoi chia không gian thành \(K\) vùng đa giác lồi.
Bước 3: Cập nhật tâm cụm (Centroid Update - M-step)
Sau khi tất cả các điểm đã được gán cụm, ta tính toán lại tọa độ tâm cụm \(\mu_k\) bằng giá trị trung bình cộng (mean) của tất cả các điểm thuộc về cụm \(S_k\):
\[\mu_k = \frac{1}{|S_k|} \sum_{i \in S_k} x_i\]
Bước 4: Kiểm tra điều kiện hội tụ (Convergence Check)
Lặp lại Bước 2 và Bước 3 cho đến khi thỏa mãn một trong các điều kiện dừng:
- Vị trí các tâm cụm \(\mu_k\) không còn thay đổi (hoặc độ dịch chuyển nhỏ hơn ngưỡng \(\epsilon\)).
- Phân bổ các điểm vào cụm không còn điểm nào đổi cụm.
- Đạt số vòng lặp tối đa
max_iterđịnh trước.
Vì ở mỗi bước lặp hàm mục tiêu \(J\) luôn giảm hoặc giữ nguyên và số lượng cách phân chia tập hữu hạn là có hạn, thuật toán chắc chắn sẽ hội tụ.
Cải tiến khởi tạo K-Means++
Thuật toán K-Means chuẩn rất nhạy cảm với cách chọn vị trí tâm cụm ban đầu. Nếu chẳng may chọn các tâm ban đầu nằm quá sát nhau trong cùng một cụm tự nhiên, thuật toán sẽ bị mắc kẹt tại cực tiểu địa phương tồi tệ.
Năm 2007, Arthur và Vassilvitskii đề xuất thuật toán khởi tạo K-Means++ với nguyên tắc đơn giản: các tâm cụm ban đầu nên nằm càng cách xa nhau càng tốt:
- Chọn ngẫu nhiên tâm cụm đầu tiên \(\mu_1\) từ tập dữ liệu.
- Với mỗi điểm dữ liệu \(x_i\), tính khoảng cách \(D(x_i)\) từ nó đến tâm cụm gần nó nhất trong số các tâm đã chọn.
- Chọn tâm cụm tiếp theo với xác suất tỷ lệ thuận với bình phương khoảng cách:
\[P(x) = \frac{D(x)^2}{\sum_{i=1}^N D(x_i)^2}\]
Điểm nào nằm càng xa các tâm cụm hiện có thì xác suất được chọn làm tâm mới càng cao. 4. Lặp lại bước 2 và 3 cho đến khi chọn đủ \(K\) tâm cụm.
K-Means++ giúp thuật toán hội tụ nhanh hơn gấp nhiều lần và giảm đáng kể sai số cuối cùng, hiện là phương pháp khởi tạo mặc định trong scikit-learn.
Cách lựa chọn số lượng cụm K
Vì là học không giám sát, ta không có nhãn để biết chính xác nên chia thành bao nhiêu cụm. Hai công cụ định lượng phổ biến nhất:
1. Phương pháp đường khuỷu tay (Elbow Method)
- Chạy K-Means với các giá trị \(K\) tăng dần từ \(1, 2, \dots, 10\).
- Vẽ đồ thị hàm mục tiêu Inertia \(J\) theo số lượng cụm \(K\).
- Khi \(K\) tăng, \(J\) luôn giảm. Tuy nhiên, đồ thị sẽ có một điểm uốn gập đột ngột (giống như khuỷu tay). Trước điểm đó, \(J\) giảm rất dốc; sau điểm đó, \(J\) giảm rất chậm. Điểm khuỷu tay đó chính là giá trị \(K\) tối ưu cân bằng giữa độ chính xác và độ phức tạp.
2. Hệ số Silhouette (Silhouette Score)
Đo lường mức độ phù hợp của mỗi điểm với cụm của nó so với các cụm xung quanh:
\[s(i) = \frac{b(i) - a(i)}{\max(a(i), b(i))}\]
Trong đó \(a(i)\) là khoảng cách trung bình từ điểm \(i\) đến các điểm khác trong cùng cụm; \(b(i)\) là khoảng cách trung bình từ điểm \(i\) đến các điểm trong cụm gần nó nhất.
- \(s(i) \approx +1\): Điểm nằm sâu trong lòng cụm của mình, tách biệt rõ ràng với cụm khác.
- \(s(i) \approx 0\): Điểm nằm ngay trên ranh giới phân cách giữa hai cụm.
- \(s(i) \approx -1\): Điểm bị gán sai cụm.
Chọn \(K\) sao cho giá trị Silhouette Score trung bình toàn bộ tập dữ liệu đạt cực đại.
Chủ đề này nằm trong Lecture 11 - Clustering (Phân cụm dữ liệu) của Khóa AI. Xem đề cương
Cài đặt thuật toán hoàn chỉnh
Dưới đây là mã nguồn cài đặt thuật toán K-Means 2 chiều từ đầu bằng Python và C++17. Chương trình nạp tọa độ các điểm dữ liệu và tâm ban đầu, thực hiện các bước lặp cập nhật và xuất ra tọa độ trọng tâm cuối cùng.
# Thuat toan K-Means Clustering tren mat phang 2D
import sys
import math

def dist_sq(x1, y1, x2, y2):
    return (x1 - x2) ** 2 + (y1 - y2) ** 2

def main():
    data = sys.stdin.read().split()
    if not data: return
    it = iter(data)
    n = int(next(it))
    k = int(next(it))
    pts = []
    for _ in range(n):
        x = float(next(it))
        y = float(next(it))
        pts.append((x, y))

    cents = []
    for _ in range(k):
        cx = float(next(it))
        cy = float(next(it))
        cents.append([cx, cy])

    max_iter = int(next(it))

    for _ in range(max_iter):
        clusters = [[] for _ in range(k)]
        for i, (px, py) in enumerate(pts):
            best_d = 1e18
            best_c = 0
            for c_idx, (cx, cy) in enumerate(cents):
                d = dist_sq(px, py, cx, cy)
                if d < best_d:
                    best_d = d
                    best_c = c_idx
            clusters[best_c].append((px, py))

        # Cap nhat centroid
        for c_idx in range(k):
            if clusters[c_idx]:
                cents[c_idx][0] = sum(p[0] for p in clusters[c_idx]) / len(clusters[c_idx])
                cents[c_idx][1] = sum(p[1] for p in clusters[c_idx]) / len(clusters[c_idx])

    print(f"k={k}")
    for cx, cy in cents:
        print(f"c={cx:.4f} {cy:.4f}")

if __name__ == "__main__":
    main()
#include <iostream>
#include <vector>
#include <iomanip>

using namespace std;

double dist_sq(double x1, double y1, double x2, double y2) {
    return (x1 - x2)*(x1 - x2) + (y1 - y2)*(y1 - y2);
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, k;
    if (!(cin >> n >> k)) return 0;
    vector<pair<double, double>> pts(n);
    for (int i = 0; i < n; ++i) cin >> pts[i].first >> pts[i].second;

    vector<pair<double, double>> cents(k);
    for (int i = 0; i < k; ++i) cin >> cents[i].first >> cents[i].second;

    int max_iter;
    cin >> max_iter;

    for (int it = 0; it < max_iter; ++it) {
        vector<vector<pair<double, double>>> clusters(k);
        for (int i = 0; i < n; ++i) {
            double px = pts[i].first;
            double py = pts[i].second;
            double best_d = 1e18;
            int best_c = 0;
            for (int c = 0; c < k; ++c) {
                double d = dist_sq(px, py, cents[c].first, cents[c].second);
                if (d < best_d) {
                    best_d = d;
                    best_c = c;
                }
            }
            clusters[best_c].push_back({px, py});
        }
        for (int c = 0; c < k; ++c) {
            if (!clusters[c].empty()) {
                double sum_x = 0, sum_y = 0;
                for (auto& p : clusters[c]) {
                    sum_x += p.first;
                    sum_y += p.second;
                }
                cents[c].first = sum_x / clusters[c].size();
                cents[c].second = sum_y / clusters[c].size();
            }
        }
    }

    cout << fixed << setprecision(4);
    cout << "k=" << k << "\n";
    for (int c = 0; c < k; ++c) {
        cout << "c=" << cents[c].first << " " << cents[c].second << "\n";
    }
    return 0;
}
Giới hạn và Nhược điểm cần lưu ý
Mặc dù rất mạnh mẽ, K-Means có những giả định hình học ngầm định mà người làm dữ liệu phải luôn ghi nhớ:
- Giả định cụm hình cầu lồi (Spherical Clusters): Do sử dụng khoảng cách Euclidean, K-Means chỉ hoạt động tốt khi các cụm lồi, gần hình cầu (đẳng hướng) và có kích thước tương đương nhau; với cụm hình elip bị kéo dài, K-Means thường chia sai. Nó hoàn toàn bất lực trước các cụm có hình dạng phức tạp như hai hình trăng khuyết lồng nhau hoặc các cụm hình vành khăn (trường hợp này nên dùng DBSCAN hoặc Spectral Clustering).
- Nhạy cảm với điểm ngoại lai (Outliers): Phép tính trung bình cộng để cập nhật tâm cụm rất dễ bị kéo lệch bởi các điểm ngoại lai có tọa độ cực đoan. Để khắc phục, biến thể K-Medoids chọn tâm là medoid, tức một điểm dữ liệu thật trong cụm có tổng khoảng cách tới các điểm còn lại nhỏ nhất, thay vì điểm trung bình.
- Phải chuẩn hóa dữ liệu: Giống như KNN, mọi thuật toán dựa trên khoảng cách Euclid đều bắt buộc phải chuẩn hóa đặc trưng (StandardScaler) trước khi chạy.
- Cụm bị rỗng (Empty Cluster): Trong quá trình lặp, có thể xảy ra trường hợp một tâm cụm không được bất kỳ điểm dữ liệu nào chọn làm tâm gần nhất. Cần xử lý ngoại lệ bằng cách gán lại tâm cụm rỗng đó vào điểm dữ liệu có khoảng cách xa nhất tới tâm hiện tại của nó.
- Mắc kẹt tại cực tiểu cục bộ: Luôn luôn chạy K-Means với tham số
n_init=10(chạy lặp lại 10 lần với các điểm khởi tạo ngẫu nhiên khác nhau và chọn kết quả có Inertia thấp nhất).
Câu hỏi thường gặp
K-Means khác gì so với KNN?
- K-Means: Thuật toán học không giám sát (Unsupervised), dữ liệu không có nhãn, mục tiêu là tự động gom nhóm dữ liệu thành \(K\) cụm.
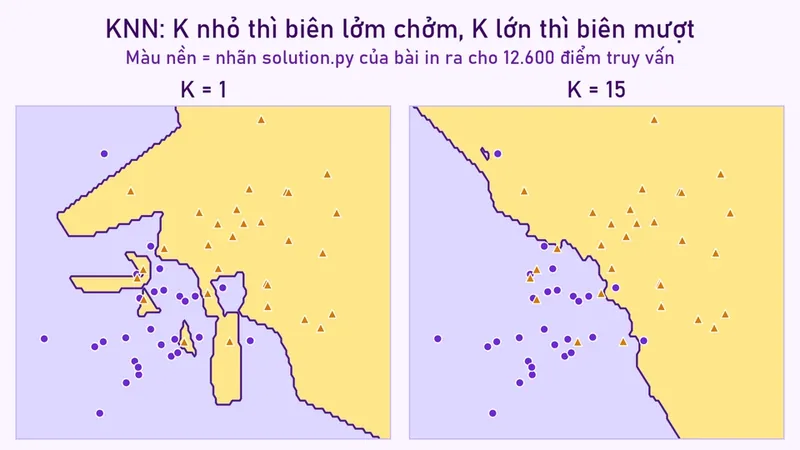
- KNN: Thuật toán học có giám sát (Supervised), dữ liệu đã có sẵn nhãn, mục tiêu là tìm \(K\) láng giềng gần nhất để phân loại cho điểm mới.
Thuật toán Mini-Batch K-Means là gì?
Khi tập dữ liệu quá khổng lồ hàng triệu điểm không thể chứa hết trong bộ nhớ RAM, Mini-Batch K-Means chỉ lấy ngẫu nhiên một lô nhỏ mẫu (ví dụ 1.000 điểm) ở mỗi bước lặp để cập nhật vị trí tâm cụm. Bài báo gốc (D. Sculley, WWW 2010) cho biết cách này giảm chi phí tính toán hàng bậc độ lớn so với K-Means theo lô truyền thống; tài liệu scikit-learn ghi kết quả thường chỉ kém thuật toán chuẩn một chút.
Có thể dùng K-Means cho dữ liệu văn bản hoặc dữ liệu phân loại không?
Có thể, nhưng cần cẩn trọng:
- Với văn bản: chuyển đổi thành vector TF-IDF hoặc dense embeddings, sau đó chuẩn hóa vector về chuẩn \(L_2 = 1\). Khi chuẩn vector bằng 1, bình phương khoảng cách Euclidean bằng đúng 2 lần khoảng cách Cosine (\(\|a - b\|^2 = 2(1 - \cos\theta)\)), cho phép K-Means phân cụm chủ đề tài liệu rất tốt.
- Với dữ liệu hạng mục (categorical data): K-Means không phù hợp vì phép tính trung bình cộng không có ý nghĩa; nên sử dụng thuật toán K-Modes hoặc K-Prototypes.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.