- ViT cắt ảnh thành
N = HW / P²mảnh (ảnh 224×224 với mảnh 16×16 cho 196 mảnh), chiếu mỗi mảnh thành một vector, thêm token [class] và nhúng vị trí, rồi đưa cả chuỗi vào một bộ mã hóa Transformer chuẩn. - Phép nhúng mảnh chính là một lớp tích chập có bộ lọc P×P và bước nhảy P.
- ViT có ít giả định sẵn về ảnh hơn CNN, nên cần nhiều dữ liệu: chỉ huấn luyện trên ImageNet thì kém ResNet cùng cỡ, huấn luyện trước trên 14 triệu đến 303 triệu ảnh thì vượt.
- Mảnh nhỏ hơn thì chuỗi dài hơn: giảm cỡ mảnh một nửa, số token tăng 4 lần và ma trận chú ý tăng khoảng 16 lần.
Mọi con số trong bài lấy từ bản PDF của bài báo "An Image is Worth 16x16 Words" (Dosovitskiy và cộng sự, Google Research, arXiv 2010.11929v2), đọc ngày 12/11/2026. Bài không giảng lại cơ chế tự chú ý (self-attention); nếu bạn chưa quen, đọc trước bài kiến trúc Transformer.
Vision Transformer là gì
Trước năm 2020, nhận dạng ảnh gần như là lãnh địa của mạng nơ-ron tích chập (CNN); cơ chế chú ý chỉ được ghép thêm vào CNN hoặc thay một vài thành phần của nó. Nhóm tác giả ViT làm ngược lại: lấy bộ mã hóa Transformer gần như nguyên trạng từ xử lý ngôn ngữ, sửa ít nhất có thể, rồi đưa ảnh vào dưới dạng một chuỗi.
Nếu mỗi điểm ảnh là một token thì ảnh 224×224 có hơn 50 nghìn token, và vì tự chú ý so từng cặp token nên chi phí tăng theo bình phương độ dài chuỗi: không chạy nổi. Lời giải nằm ngay trong tên bài báo: cắt ảnh thành các ô vuông 16×16 điểm ảnh, coi mỗi ô là một "từ". Mô hình được huấn luyện có giám sát để phân loại ảnh, như một CNN.
Từ ảnh thành chuỗi token
Gọi ảnh có chiều cao H, chiều rộng W, C kênh màu, và cỡ mảnh là P. Số mảnh là
\[N = \frac{HW}{P^2}\]
Mỗi mảnh được duỗi thành một vector \(P^2 C\) số, rồi nhân với một ma trận học được \(E\) để thành vector D chiều, gọi là nhúng mảnh (patch embedding). Bài báo viết chuỗi đầu vào của Transformer như sau (phương trình 1):
\[\begin{aligned} z_0 &= [\,x_{\mathrm{class}};\ x_p^1 E;\ \dots;\ x_p^N E\,] \\ &\quad + E_{\mathrm{pos}} \end{aligned}\]
trong đó \(E \in \mathbb{R}^{(P^2 C) \times D}\) và \(E_{\mathrm{pos}} \in \mathbb{R}^{(N+1) \times D}\). Với ViT-B/16 và ảnh 224×224 màu, các đại lượng cụ thể là:
| Đại lượng | Cách tính | ViT-B/16, ảnh 224×224×3 |
|---|---|---|
Số mảnh N |
HW / P² |
224 × 224 / 256 = 196 |
| Số trong một mảnh | P² × C |
16 × 16 × 3 = 768 |
| Độ dài chuỗi | N + 1 (thêm [class]) |
197 |
Chiều của token D |
theo cỡ mô hình | 768 |
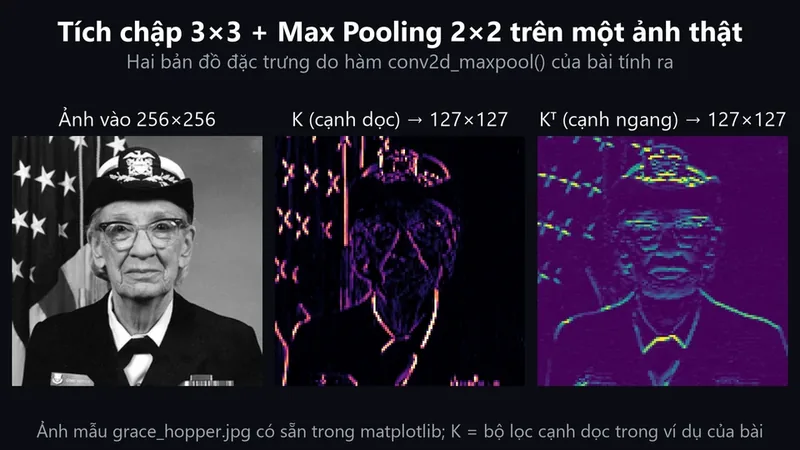
Có một điểm thú vị khi cài đặt: nhân từng mảnh với E cũng chính là chạy một lớp tích chập có D bộ lọc kích thước P×P, bước nhảy P. Các bộ lọc không chồng lên nhau nên mỗi vị trí của tích chập ứng đúng một mảnh. Đoạn code ở phần sau kiểm chứng hai cách cho cùng kết quả.
Token [class] và nhúng vị trí
Giống token [class] của BERT, ViT thêm một vector học được vào đầu chuỗi. Sau khi qua mọi lớp, trạng thái ở vị trí này (qua thêm một LayerNorm) là biểu diễn của cả ảnh. Đầu phân loại gắn vào đó: lúc huấn luyện trước là một MLP có một lớp ẩn, lúc tinh chỉnh là một lớp tuyến tính.
Tự chú ý không biết thứ tự, nên mô hình cần được báo mảnh nào nằm ở đâu. ViT dùng nhúng vị trí một chiều học được: mỗi vị trí 0, 1, ..., 196 có một vector riêng, cộng vào token tương ứng. Bài báo thử cả các kiểu nhúng biết hai chiều (theo hàng và cột) nhưng không thấy cải thiện đáng kể (phụ lục D.4). Lý do: nhúng vị trí đã học tự mang cấu trúc lưới, các mảnh gần nhau hoặc cùng hàng, cùng cột có nhúng giống nhau hơn.
Hệ quả thực tế: khi tinh chỉnh ở độ phân giải cao hơn, ViT giữ nguyên cỡ mảnh nên số mảnh tăng, và nhúng vị trí cũ không còn khớp. Bài báo nội suy hai chiều các nhúng vị trí theo vị trí của chúng trên ảnh gốc. Kết quả ImageNet tốt nhất được tinh chỉnh ở 512×512 cho ViT-L/16 và 518×518 cho ViT-H/14. Theo nhóm tác giả, cắt mảnh và nội suy này là hai chỗ duy nhất mô hình được "báo" rằng ảnh có cấu trúc hai chiều.
Bên trong là một Transformer bình thường
Sau bước nhúng, ViT không có gì riêng cho ảnh. Mỗi khối gồm tự chú ý nhiều đầu (MSA) và một MLP hai lớp với hàm kích hoạt GELU; LayerNorm đặt trước mỗi khối, kết nối tắt đặt sau (phương trình 2 đến 4):
\[\begin{aligned} z'_\ell &= \mathrm{MSA}(\mathrm{LN}(z_{\ell-1})) + z_{\ell-1} \\ z_\ell &= \mathrm{MLP}(\mathrm{LN}(z'_\ell)) + z'_\ell \\ y &= \mathrm{LN}(z_L^0) \end{aligned}\]
Bảng 1 của bài báo cho ba cỡ, lấy theo cấu hình của BERT (Base, Large) và thêm cỡ Huge:
| Mô hình | Số lớp | Chiều D |
Chiều MLP | Số đầu | Tham số |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86 triệu |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307 triệu |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632 triệu |
Tên đầy đủ ghép cỡ và cỡ mảnh: ViT-L/16 là bản Large với mảnh 16×16, ViT-H/14 là bản Huge với mảnh 14×14. Số sau dấu gạch chéo là cỡ mảnh, không phải số lớp.
Code numpy: cắt mảnh, nhúng mảnh, đếm tham số
Đoạn code dưới đây làm ba việc với một ảnh ngẫu nhiên 224×224×3: cắt mảnh bằng reshape và transpose, nhúng mảnh theo hai cách (nhân ma trận và tích chập bước 16), và đếm tham số của ViT-B/16 từ cấu hình ở Bảng 1.
"""Vision Transformer bằng numpy: chia ảnh thành mảnh, nhúng mảnh, đếm tham số ViT-B/16.

Chạy: python vit_chia_manh.py  (cần numpy)
"""
import numpy as np


def chia_manh(anh, p):
    """anh có dạng (H, W, C). Trả về mảng (N, p*p*C): mỗi dòng là một mảnh p×p đã duỗi phẳng,
    các mảnh xếp theo hàng, từ trái sang phải, từ trên xuống dưới."""
    h, w, c = anh.shape
    assert h % p == 0 and w % p == 0, "cạnh ảnh phải chia hết cho kích thước mảnh"
    x = anh.reshape(h // p, p, w // p, p, c)   # (hàng mảnh, p, cột mảnh, p, C)
    x = x.transpose(0, 2, 1, 3, 4)            # (hàng mảnh, cột mảnh, p, p, C)
    return x.reshape(-1, p * p * c)


def nhung_manh(anh, p, E, b):
    """Phép chiếu tuyến tính của ViT: (N, p*p*C) @ E + b, với E có dạng (p*p*C, D)."""
    return chia_manh(anh, p) @ E + b


def tich_chap_buoc_p(anh, p, E, b):
    """Cùng phép tính, viết như một lớp tích chập có bộ lọc p×p và bước nhảy p (cách các thư viện cài ViT)."""
    h, w, c = anh.shape
    bo_loc = E.reshape(p, p, c, -1)           # D bộ lọc, mỗi bộ lọc p×p×C
    ra = []
    for i in range(0, h, p):
        for j in range(0, w, p):
            o = anh[i:i + p, j:j + p, :]
            ra.append(np.einsum('xyc,xycd->d', o, bo_loc) + b)
    return np.array(ra)


def tham_so_vit(so_lop, d, mlp, p, c, so_manh, so_lop_ra=0):
    """Số tham số của ViT: nhúng mảnh, token [class], vị trí, các khối Transformer, LayerNorm cuối, đầu phân loại."""
    nhung = p * p * c * d + d
    vi_tri = (so_manh + 1) * d
    moi_khoi = (4 * d * d + 4 * d) + (2 * d * mlp + mlp + d) + 2 * (2 * d)   # chú ý, MLP, hai LayerNorm
    dau_ra = d * so_lop_ra + so_lop_ra if so_lop_ra else 0
    return nhung + d + vi_tri + so_lop * moi_khoi + 2 * d + dau_ra


def so(n):
    """Viết số kiểu Việt Nam: 85798656 -> '85.798.656'."""
    return f"{n:,}".replace(",", ".")


def chay_thu():
    rng = np.random.default_rng(0)
    anh = rng.random((224, 224, 3))
    p, d = 16, 768
    manh = chia_manh(anh, p)
    print(f"Ảnh 224×224×3, mảnh {p}×{p}: {manh.shape[0]} mảnh, mỗi mảnh {manh.shape[1]} số")
    print(f"Chuỗi vào Transformer: {manh.shape[0] + 1} token (thêm [class]), mỗi token {d} chiều")

    E = rng.normal(0, 0.02, (p * p * 3, d))
    b = np.zeros(d)
    lech = np.abs(nhung_manh(anh, p, E, b) - tich_chap_buoc_p(anh, p, E, b)).max()
    print(f"Nhân ma trận và tích chập bước {p} cho cùng kết quả: {lech < 1e-9}")

    n = tham_so_vit(so_lop=12, d=768, mlp=3072, p=16, c=3, so_manh=196)
    trieu = f"{n / 1e6:.1f}".replace(".", ",")
    print(f"Tham số ViT-B/16 (chưa tính đầu phân loại): {so(n)} ≈ {trieu} triệu")

    print("Kích thước mảnh -> số token -> số ô của một ma trận chú ý (mỗi đầu):")
    for kich_thuoc in (32, 16, 8):
        n_token = (224 // kich_thuoc) ** 2 + 1
        print(f"  p={kich_thuoc:2d}: {n_token:4d} token, {so(n_token * n_token):>7} ô")


if __name__ == "__main__":
    chay_thu()
Kết quả in ra: 196 mảnh, mỗi mảnh 768 số, tổng cộng 197 token; hai cách nhúng cho cùng kết quả; ViT-B/16 có 85.798.656 tham số khi chưa tính đầu phân loại, làm tròn thành 86 triệu như Bảng 1. Mỗi khối Transformer chiếm 7.087.872 tham số, gần bằng \(12D^2\) (bốn ma trận của phần chú ý, hai ma trận của MLP); nhúng mảnh và nhúng vị trí chưa tới 1% tổng số.
Ba dòng cuối cho thấy cái giá của mảnh nhỏ. Với ảnh 224×224, mảnh 32 cho 50 token, mảnh 16 cho 197 token, mảnh 8 cho 785 token. Ma trận chú ý của mỗi đầu có số ô bằng bình phương số token: 2.500, 38.809 rồi 616.225. Bài báo ghi rõ độ dài chuỗi tỉ lệ nghịch với bình phương cỡ mảnh, nên mảnh nhỏ tốn tính toán hơn nhiều. Khi sửa code, hãy cắt tay vài mảnh bằng chỉ số anh[r*16:(r+1)*16, c*16:(c+1)*16] rồi so với dòng r * 14 + c của kết quả.
Vì sao ViT cần nhiều dữ liệu
CNN có sẵn nhiều giả định về ảnh, gọi là thiên kiến quy nạp (inductive bias): mỗi lớp chỉ nhìn một vùng nhỏ, hiểu quan hệ hàng xóm hai chiều, và một mẫu dịch đi vẫn được nhận ra. ViT gần như không có những giả định đó. Chỉ MLP xử lý từng token riêng lẻ, còn tự chú ý nhìn toàn ảnh ngay từ lớp đầu; mọi quan hệ không gian giữa các mảnh phải tự học từ dữ liệu.
Bài báo kiểm tra điều này với ba tập huấn luyện trước: ImageNet (1,3 triệu ảnh, 1 nghìn lớp), ImageNet-21k (14 triệu ảnh, 21 nghìn lớp) và JFT-300M (303 triệu ảnh, 18 nghìn lớp, tập nội bộ của Google). Chỉ huấn luyện trên ImageNet thì ViT-Large còn kém ViT-Base, và ResNet (BiT) vượt ViT; với ImageNet-21k hai cỡ ngang nhau; chỉ với JFT-300M mô hình lớn mới phát huy hết. Trên các tập con của JFT, ViT-B/32 (nhanh hơn ResNet50 một chút) kém hẳn khi có 9 triệu ảnh nhưng tốt hơn từ 90 triệu ảnh trở lên.
Khi đủ dữ liệu, ViT vừa tốt hơn vừa rẻ hơn (Bảng 2 của bài báo; "nghìn ngày lõi TPUv3" là số lõi TPU nhân số ngày huấn luyện trước):
| Mô hình, dữ liệu huấn luyện trước | ImageNet | CIFAR-100 | Nghìn ngày lõi TPUv3 |
|---|---|---|---|
| ViT-H/14, JFT-300M | 88,55% | 94,55% | 2,5 |
| ViT-L/16, JFT-300M | 87,76% | 93,90% | 0,68 |
| ViT-L/16, ImageNet-21k | 85,30% | 93,25% | 0,23 |
| BiT-L (ResNet152x4), JFT-300M | 87,54% | 93,51% | 9,9 |
| Noisy Student (EfficientNet-L2) | 88,4% / 88,5% | không có số | 12,3 |
Bản ViT-L/16 trên ImageNet-21k huấn luyện được trên một máy TPUv3 8 lõi trong khoảng 30 ngày. Theo mục 4.4, ViT cần ít hơn khoảng 2 đến 4 lần tính toán để đạt cùng độ chính xác như ResNet; bản lai (CNN đi trước, ViT đi sau) nhỉnh hơn khi ngân sách nhỏ, nhưng khoảng cách biến mất ở mô hình lớn.
Đọc kết luận này đúng phạm vi: đó là kết quả năm 2020, khi bài báo chỉ tinh chỉnh ba tham số điều chuẩn (suy giảm trọng số, dropout, làm mềm nhãn). Bài học thực tế: với vài nghìn ảnh của bạn, hãy tinh chỉnh một ViT đã huấn luyện trước.
ViT nhìn ảnh thế nào
Nhóm tác giả đo "khoảng cách chú ý": trung bình mỗi đầu gom thông tin từ vùng xa bao nhiêu điểm ảnh, tương tự vùng nhìn của CNN. Ngay ở lớp thấp đã có đầu nhìn gần như toàn ảnh, trong khi đầu khác chỉ nhìn rất gần, giống lớp tích chập đầu tiên; càng lên sâu, khoảng cách càng tăng. Ở bản lai (CNN đi trước), các đầu nhìn gần ít hẳn đi: chúng làm đúng việc của các lớp tích chập đầu.
ViT trong các mô hình khác
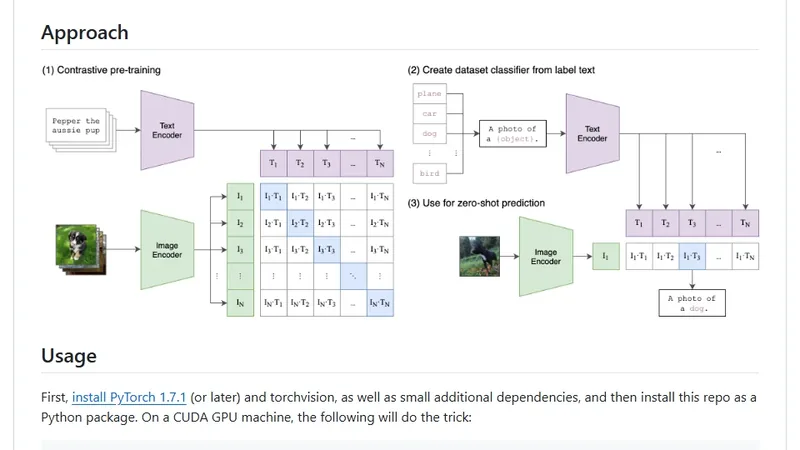
ViT nhanh chóng thành bộ mã hóa ảnh của nhiều hệ thống. Ví dụ rõ nhất là CLIP: bài báo CLIP huấn luyện ba bộ mã hóa ảnh kiểu ViT, và bản tốt nhất là ViT-L/14 tinh chỉnh ở 336 điểm ảnh. Khi bạn gửi ảnh cho một chatbot qua API, ảnh cũng được quy ra token và tính phí; bài AI đọc hình ảnh nói cách ước lượng số token đó.
- Ảnh có cạnh không chia hết cho cỡ mảnh: phải đổi kích thước hoặc cắt trước, nếu không phép cắt mảnh sai.
- Đọc nhầm ViT-B/16: số 16 là cỡ mảnh, không phải số lớp hay số đầu chú ý.
- Đổi độ phân giải khi tinh chỉnh mà không nội suy nhúng vị trí: số vị trí không còn khớp với mô hình đã huấn luyện trước.
- Huấn luyện ViT từ đầu trên vài nghìn ảnh rồi kết luận ViT kém hơn CNN: bài báo cho thấy ViT cần huấn luyện trước trên dữ liệu lớn.
- Giảm cỡ mảnh để tăng độ chính xác mà quên chi phí: mảnh nhỏ đi một nửa thì số token tăng 4 lần, ma trận chú ý tăng khoảng 16 lần.
Câu hỏi thường gặp
ViT khác CNN ở điểm nào?
CNN nhìn ảnh qua các bộ lọc cục bộ, xếp chồng nhiều lớp để vùng nhìn rộng dần. ViT cắt ảnh thành mảnh rồi để mọi mảnh chú ý tới mọi mảnh ngay từ lớp đầu. CNN có sẵn giả định về ảnh nên học tốt với ít dữ liệu; ViT cần nhiều dữ liệu hơn nhưng mở rộng tốt hơn khi dữ liệu lớn.
Vì sao bài báo tên là "16x16 words"?
Vì mỗi mảnh 16×16 điểm ảnh đóng vai trò một "từ" trong câu, và Transformer xử lý chuỗi mảnh giống hệt chuỗi từ trong văn bản.
Có cần GPU lớn để dùng ViT không?
Huấn luyện từ đầu như bài báo rất tốn kém (ViT-H/14 trên JFT-300M mất 2,5 nghìn ngày lõi TPUv3). Tinh chỉnh một mô hình đã huấn luyện trước cho bài toán nhỏ thì nhẹ hơn nhiều.
Cỡ mảnh có bắt buộc là 16 không?
Không. Bài báo dùng 32, 16 và 14. Mảnh nhỏ cho nhiều chi tiết hơn nhưng chuỗi dài hơn, nên tốn bộ nhớ và thời gian hơn.
Học tiếp
- Cơ chế tự chú ý mà ViT dùng lại: kiến trúc Transformer giải thích chi tiết.
- Huấn luyện ảnh và chữ cùng nhau với bộ mã hóa ViT: CLIP là gì.
- Đối thủ trực tiếp của ViT: mạng nơ-ron tích chập CNN.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.