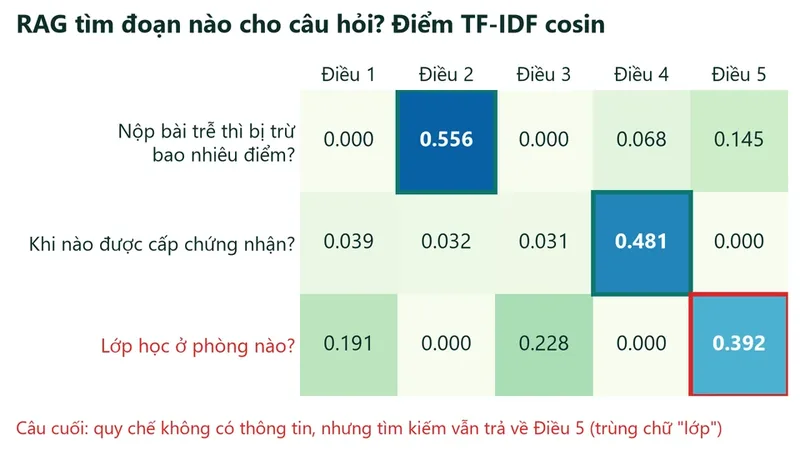
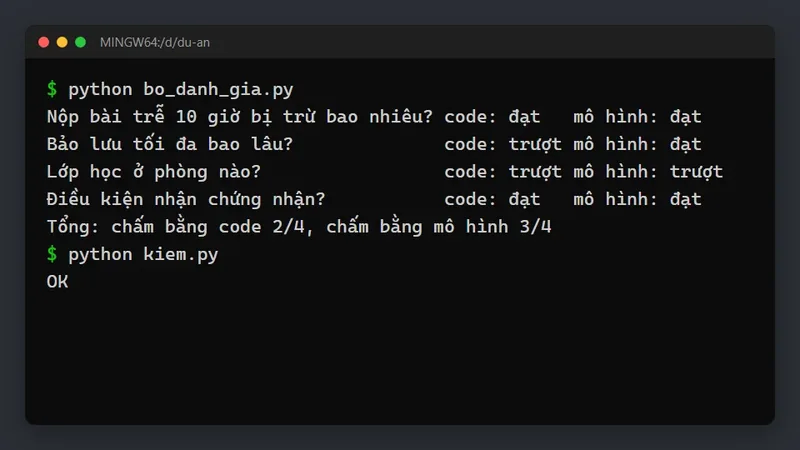
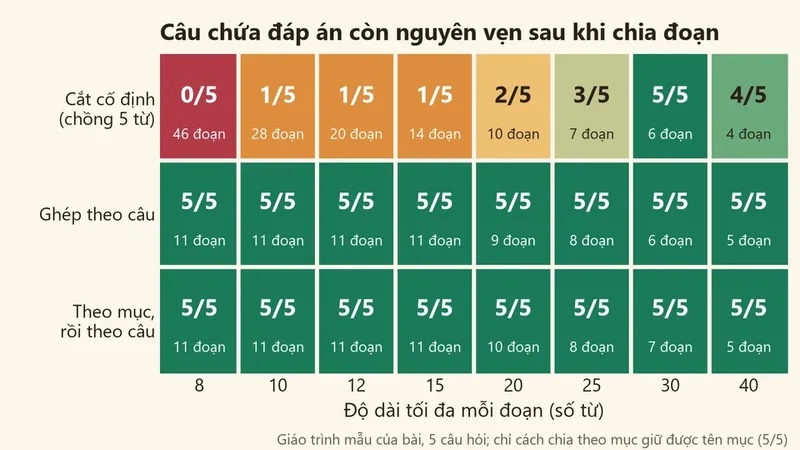
- Đo hai phần riêng: phần tìm (có lấy được đoạn chứa đáp án không) và phần trả lời (có dùng đúng đoạn đó, không thêm thông tin ngoài không).
- Phần tìm: recall@k là tỷ lệ đoạn đúng nằm trong k kết quả đầu; MRR cho biết đoạn đúng đầu tiên đứng thứ mấy.
- Phần trả lời: kiểm từng câu trong câu trả lời có được đoạn đã tìm hỗ trợ không, thường bằng mô hình làm giám khảo.
- Mọi số đo cần một bộ câu hỏi có đáp án lấy từ dữ liệu thật, có cả câu hỏi khó, diễn đạt khác chữ trong tài liệu.
Bài này dựa trên bài báo Ragas của Es và cộng sự (2023) về đánh giá RAG tự động, bài viết Contextual Retrieval của Anthropic (dùng tỷ lệ tìm hụt để so các cách tìm), và trang hướng dẫn dựng bộ đánh giá trong tài liệu của Anthropic, đọc ngày 11/11/2026. Nếu chưa rõ RAG, đọc trước bài RAG là gì.
Vì sao phải tách hai phần
Khi chatbot trả lời sai, câu hỏi đầu tiên là sai ở đâu. Nếu đoạn chứa đáp án không nằm trong những gì được tìm, mô hình tốt mấy cũng không trả lời đúng được; cần sửa cách chia đoạn, mô hình embedding, hoặc thêm bước xếp hạng lại. Nếu đoạn đúng đã có mà câu trả lời vẫn sai hoặc thêm thông tin không có trong đoạn, vấn đề nằm ở chỉ dẫn cho mô hình hoặc ở chính mô hình.
Bài báo Ragas mô tả đúng cách nhìn này: đánh giá RAG gồm xem bước tìm có lấy được ngữ cảnh liên quan và tập trung không, mô hình có dùng ngữ cảnh đó một cách trung thực không, và chất lượng câu trả lời cuối. Đo gộp một con số "đúng hay sai" cho cả hệ thống thì không biết sửa chỗ nào.
Dựng bộ câu hỏi
Mỗi mục trong bộ đo gồm câu hỏi, các đoạn tài liệu chứa đáp án (một hoặc nhiều), và nếu được thì một câu trả lời mẫu. Vài nguyên tắc:
- Lấy câu hỏi từ người dùng thật nếu có, hoặc nhờ người hiểu tài liệu viết. Câu hỏi do mô hình sinh tự động thường dùng lại đúng chữ trong tài liệu, nên dễ quá.
- Có câu hỏi diễn đạt khác hẳn chữ trong tài liệu, như hỏi "vắng mặt nhiều thì sao" trong khi tài liệu viết "nghỉ quá 3 buổi".
- Có câu cần hai đoạn mới trả lời đủ, và có câu không có đáp án trong tài liệu, để kiểm mô hình biết nói "không tìm thấy".
- Bắt đầu với vài chục câu; số này đủ để thấy khác biệt lớn giữa hai cấu hình. Thêm dần khi gặp lỗi thật.
Trang hướng dẫn của Anthropic về dựng bộ đánh giá nhấn mạnh: đặt tiêu chí thành công cụ thể, đo được, và ưu tiên nhiều câu hỏi chấm tự động hơn vài câu chấm tay kỹ. Xem thêm bài đánh giá câu trả lời AI.
Đo phần tìm
Recall@k. Với mỗi câu hỏi, lấy k đoạn đầu mà bộ tìm trả về, đếm bao nhiêu phần trong các đoạn đúng nằm trong đó. Nếu chỉ có một đoạn đúng, recall@k là 1 hoặc 0. Lấy trung bình trên cả bộ câu hỏi. Chọn k bằng đúng số đoạn bạn định đưa vào prompt: nếu đưa 5 đoạn thì quan tâm recall@5.
MRR. Lấy nghịch đảo thứ hạng của đoạn đúng đầu tiên: đứng đầu được 1, đứng thứ hai được 0,5, thứ ba được 0,33, không có được 0. Lấy trung bình. MRR cao nghĩa là đoạn đúng thường đứng gần đầu, quan trọng khi bạn chỉ đưa ít đoạn vào prompt.
Bài viết Contextual Retrieval của Anthropic dùng cách đo cùng tinh thần: tỷ lệ tìm hụt, tức một trừ recall, khi lấy 20 đoạn đầu, để so các cách tìm khác nhau.
Đo phần trả lời
Phần trả lời khó đo hơn vì là văn bản tự do. Câu hỏi quan trọng nhất: mỗi khẳng định trong câu trả lời có được đoạn đã tìm hỗ trợ không. Bài báo Ragas gọi đây là độ trung thực và đề xuất dùng mô hình ngôn ngữ để tách câu trả lời thành các khẳng định rồi kiểm từng cái. Ngoài ra còn đo câu trả lời có thật sự trả lời câu hỏi không, và có khớp câu trả lời mẫu không.
Cách đơn giản để bắt đầu, nhất là với thông tin có số: kiểm mọi con số trong câu trả lời đều xuất hiện trong các đoạn đã tìm. Một con số không có nguồn gần như chắc chắn là bịa. Cách này thô nhưng rẻ, chạy được trên toàn bộ câu trả lời mỗi ngày, và bắt được loại lỗi nguy hiểm nhất với tài liệu như học phí, lịch học, quy chế.
Ví dụ bằng Python
Đoạn code dưới đây có kho 6 đoạn thông tin khóa học, 7 câu hỏi kèm đoạn đúng, một bộ tìm đơn giản đếm số từ chung, các hàm tính recall@k và MRR, và hàm tìm câu có số không bám nguồn.
"""Đánh giá RAG tách hai phần: phần TÌM (recall@k, MRR) và phần TRẢ LỜI (có bám đoạn đã tìm không).

Kho đoạn, câu hỏi và hai câu trả lời mẫu là dữ liệu tự soạn để minh họa.
Bộ tìm ở đây so số từ chung (đơn giản để chạy không cần thư viện); thay bằng bộ tìm thật của bạn.
Kiểm bám nguồn ở đây là cách thô (số và từ quan trọng có xuất hiện trong đoạn không); hệ thống thật thường dùng
mô hình làm giám khảo, như cách trong bài đánh giá câu trả lời AI.
"""
import re

KHO = {
    "d1": "Học phí khóa Python cơ bản là 3 triệu đồng cho 12 buổi.",
    "d2": "Lớp Python cơ bản học tối thứ ba và thứ năm, mỗi buổi 2 giờ.",
    "d3": "Học viên nghỉ quá 3 buổi sẽ không được cấp chứng nhận hoàn thành.",
    "d4": "Khóa thuật toán nâng cao yêu cầu đã học xong cấu trúc dữ liệu.",
    "d5": "Học phí khóa thuật toán nâng cao là 5 triệu đồng cho 16 buổi.",
    "d6": "Có thể học bù buổi đã nghỉ ở lớp khác cùng khóa nếu còn chỗ.",
}
BO_HOI = [  # (câu hỏi, các đoạn đúng)
    ("Học phí khóa Python cơ bản bao nhiêu?", {"d1"}),
    ("Lớp Python học vào những tối nào?", {"d2"}),
    ("Nghỉ mấy buổi thì mất chứng nhận?", {"d3"}),
    ("Muốn học thuật toán nâng cao cần học gì trước?", {"d4"}),
    ("Nghỉ học thì có học bù được không?", {"d6", "d3"}),
    ("Một khóa thuật toán tốn bao nhiêu tiền?", {"d5"}),
    ("Vắng mặt nhiều thì sao?", {"d3"}),
]


def tu(s):
    return set(re.findall(r"\w+", s.lower()))


def tim(cau_hoi, kho, k=3):
    diem = {ma: len(tu(cau_hoi) & tu(doan)) for ma, doan in kho.items()}
    return sorted(diem, key=lambda m: (-diem[m], m))[:k]


def recall_at_k(ket_qua, dung, k):
    return len(set(ket_qua[:k]) & dung) / len(dung)


def mrr(ket_qua, dung):
    for i, ma in enumerate(ket_qua, 1):
        if ma in dung:
            return 1 / i
    return 0.0


def cau_khong_bam_nguon(tra_loi, cac_doan):
    """Câu trong câu trả lời có con số không xuất hiện trong các đoạn đã tìm -> nghi bịa."""
    nguon = " ".join(cac_doan)
    so_nguon = set(re.findall(r"\d+", nguon))
    return [c.strip() for c in re.split(r"(?<=[.!?])\s+", tra_loi)
            if c.strip() and not set(re.findall(r"\d+", c)) <= so_nguon]


def chay_thu():
    r1, r3, m = [], [], []
    for cau, dung in BO_HOI:
        kq = tim(cau, KHO)
        r1.append(recall_at_k(kq, dung, 1))
        r3.append(recall_at_k(kq, dung, 3))
        m.append(mrr(kq, dung))
    n = len(BO_HOI)
    dong = [f"Phần tìm trên {n} câu hỏi: recall@1 = {sum(r1) / n:.2f}, recall@3 = {sum(r3) / n:.2f}, MRR = {sum(m) / n:.2f}"]
    for (cau, dung), a, mm in zip(BO_HOI, r1, m):
        if mm < 1:  # đoạn đúng đầu tiên không ở hạng 1 (recall@1 < 1 còn có thể chỉ vì câu có hai đoạn đúng)
            dong.append(f"  đoạn đúng chưa đứng đầu: '{cau}' (recall@1 = {a:.2f}, MRR = {mm:.2f})")
    doan = [KHO[x] for x in tim("Học phí khóa Python cơ bản bao nhiêu?", KHO)]
    for ten, tl in [("Câu trả lời A", "Học phí là 3 triệu đồng cho 12 buổi."),
                    ("Câu trả lời B", "Học phí là 3 triệu đồng. Đóng trước ngày 15 được giảm 10%.")]:
        sai = cau_khong_bam_nguon(tl, doan)
        dong.append(f"{ten}: {'bám nguồn' if not sai else 'có câu không bám nguồn: ' + '; '.join(sai)}")
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Kết quả phần tìm: recall@3 bằng 1,00, tức đoạn đúng luôn nằm trong 3 kết quả đầu; nhưng recall@1 chỉ 0,64 và MRR 0,83. Chương trình in ra hai câu mà đoạn đúng chưa đứng đầu. Câu "Một khóa thuật toán tốn bao nhiêu tiền?" có đoạn đúng đứng thứ hai, vì bộ tìm đếm từ thấy đoạn về điều kiện học cũng có chữ "khóa thuật toán". Câu "Vắng mặt nhiều thì sao?" không chung chữ quan trọng nào với đoạn "nghỉ quá 3 buổi", nên đoạn đúng chỉ đứng thứ ba. Đây là loại câu mà tìm theo nghĩa bằng embedding, hoặc bước xếp hạng lại, sẽ giúp. Ngoài ra, câu "Nghỉ học thì có học bù được không?" có hai đoạn đúng và cả hai đứng ở hai hạng đầu, nên không bị in ra; nhưng một kết quả chỉ chứa được một trong hai đoạn, nên recall@1 của câu này tối đa là 0,50, kéo recall@1 chung xuống.
Kết quả phần trả lời: câu trả lời A ("học phí 3 triệu cho 12 buổi") bám nguồn. Câu trả lời B thêm câu "đóng trước ngày 15 được giảm 10%", có số không xuất hiện trong đoạn nào, nên bị đánh dấu.
Đọc số đo để sửa
Recall@k thấp: sửa phần tìm. Thử cách chia đoạn khác (xem bài chia đoạn văn bản cho RAG), mô hình embedding khác, kết hợp tìm theo từ và theo nghĩa, hoặc tăng k. Recall@k cao nhưng MRR thấp: đoạn đúng có trong kết quả nhưng xếp dưới; thêm bước xếp hạng lại, hoặc đưa nhiều đoạn hơn vào prompt nếu chi phí cho phép. Phần tìm tốt mà câu trả lời vẫn sai hoặc bịa: sửa chỉ dẫn (yêu cầu chỉ dùng tài liệu, trích nguồn, nói không biết khi không có), hoặc đổi mô hình.
Ngoài số đo tổng, hãy đọc từng câu sai. Một danh sách mười câu tìm hụt thường lộ ra một mẫu chung: cùng là câu hỏi dùng từ đồng nghĩa, cùng là thông tin nằm trong bảng, hay cùng là tài liệu mới thêm chưa được tạo embedding. Sửa theo mẫu đó hiệu quả hơn chỉnh tham số mò mẫm.
Mỗi lần thay đổi, chạy lại toàn bộ bộ đo và ghi kết quả. Một thay đổi giúp câu này có thể làm hỏng câu khác; chỉ số trên cả bộ mới cho biết tổng thể tốt lên hay xấu đi.
- Chỉ đo câu trả lời cuối, không biết lỗi do tìm hay do trả lời.
- Bộ câu hỏi toàn câu dùng lại chữ trong tài liệu, cho số đo đẹp mà không thật.
- Chọn k để đo khác với số đoạn thật sự đưa vào prompt.
- Không có câu hỏi ngoài tài liệu để kiểm mô hình biết từ chối.
- Thay đổi nhiều thứ cùng lúc rồi không biết thứ nào làm số đo đổi.
Câu hỏi thường gặp
Cần bao nhiêu câu hỏi?
Vài chục câu để bắt đầu so cấu hình. Muốn phát hiện khác biệt nhỏ thì cần nhiều hơn.
Có công cụ làm sẵn không?
Có các thư viện mã nguồn mở cho đánh giá RAG, như bộ công cụ đi kèm bài báo Ragas. Hiểu cách tính bằng tay trước giúp bạn đọc đúng số của các công cụ đó.
Dùng mô hình chấm có tin được không?
Cần kiểm lại: chấm tay một mẫu nhỏ và so với điểm của mô hình. Nếu lệch nhiều, sửa chỉ dẫn chấm.
Recall bao nhiêu là đủ?
Tùy ứng dụng. Với tài liệu như quy chế, học phí, nên đặt mục tiêu cao cho phần tìm, vì tìm hụt dẫn tới trả lời sai.
Học tiếp
- Toàn cảnh RAG: RAG là gì.
- Chấm câu trả lời bằng code và bằng mô hình: đánh giá câu trả lời AI.
- Sửa phần tìm từ gốc: chia đoạn văn bản cho RAG.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.