- Phần lớn dữ liệu tiền huấn luyện là trang web: trong bộ Dolma, Common Crawl chiếm 2.479 tỷ trên 3.059 tỷ token, khoảng 81%.
- Văn bản thô đi qua một chuỗi bước: tách chữ khỏi HTML, lọc ngôn ngữ, lọc an toàn và thông tin cá nhân, lọc chất lượng bằng quy tắc hoặc bằng mô hình, khử trùng lặp, chống lọt đề kiểm tra.
- FineWeb từ 96 đợt Common Crawl còn 36 nghìn tỷ token sau lọc cơ bản, 20 nghìn tỷ sau khử trùng, 15 nghìn tỷ ở bản cuối; bản giáo dục FineWeb-Edu chỉ còn 1,3 nghìn tỷ.
- Khử trùng gần đúng dùng MinHash: với 14 nhóm 8 giá trị băm, hai trang giống nhau 75% bị bắt với xác suất khoảng 77%.
Code trong bài là Python 3 dùng numpy (máy viết bài dùng numpy 2.5.4). Số liệu lấy từ bản PDF của các bài báo trên arXiv và từ trang của Common Crawl, đọc ngày 12/11/2026. Phần bản quyền của dữ liệu huấn luyện là chuyện luật, không nằm trong bài này.
Dữ liệu huấn luyện gồm những gì
Một mô hình ngôn ngữ lớn học qua hai giai đoạn. Giai đoạn tiền huấn luyện cho mô hình đọc một kho văn bản khổng lồ để đoán token kế tiếp; giai đoạn sau dùng ít dữ liệu hơn nhiều để dạy mô hình làm theo yêu cầu, như bài fine-tuning là gì mô tả. Bài này nói về kho văn bản của giai đoạn đầu. Nếu bạn cần bộ dữ liệu nhỏ để tự luyện mô hình, hãy xem bài bộ dữ liệu để luyện AI.
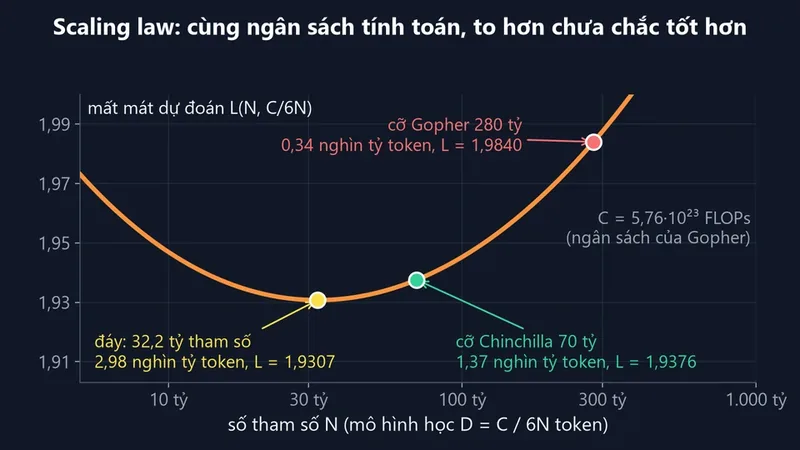
Quy mô rất lớn. Bài báo Llama 3 ghi Meta tiền huấn luyện trên khoảng 15 nghìn tỷ token nhiều ngôn ngữ, so với 1,8 nghìn tỷ của Llama 2, với kiến thức tới cuối năm 2023. Hỗn hợp cuối cùng có khoảng 50% kiến thức chung, 25% toán và suy luận, 17% mã nguồn và 8% văn bản nhiều ngôn ngữ. Con số này không đến ngẫu nhiên: bài scaling law giải thích vì sao mô hình càng lớn càng cần nhiều token.
Bộ Dolma của Viện Allen công bố đủ thành phần. Từ khoảng 200 TB văn bản thô, họ giữ lại 11 TB, tức 3.059 tỷ token: trang web từ Common Crawl 2.479 tỷ, mã nguồn GitHub 411 tỷ, Reddit 89 tỷ, bài báo khoa học 70 tỷ, sách Project Gutenberg 6 tỷ, Wikipedia 4,3 tỷ. Trang web chiếm khoảng 81%, nên chất lượng của mô hình phụ thuộc rất nhiều vào việc làm sạch web.
Common Crawl: kho trang web mở
Theo trang chủ của Common Crawl (đọc ngày 12/11/2026), đây là một tổ chức phi lợi nhuận thành lập năm 2007, giữ một kho dữ liệu web miễn phí cho mọi người, hơn 300 tỷ trang và thêm 3 đến 5 tỷ trang mới mỗi tháng. Mỗi đợt thu thập có một mã riêng; đợt mới nhất hôm đọc là CC-MAIN-2026-43.
Trang Get Started mô tả ba loại tệp. WARC chứa dữ liệu thô: nguyên HTML và cả tiêu đề HTTP. WAT chứa siêu dữ liệu tính từ WARC. WET chứa chữ đã tách sẵn. Nhiều bộ dữ liệu bắt đầu từ WET vì tiện, nhưng nhóm FineWeb thấy WET còn quá nhiều menu và chữ thừa; tách lại chữ từ WARC bằng thư viện trafilatura cho mô hình tốt hơn rõ. Meta còn viết bộ tách HTML riêng cho Llama 3: giữ thuộc tính alt của ảnh vì công thức toán hay nằm trong ảnh, và bỏ ký hiệu markdown vì thử nghiệm cho thấy nó làm mô hình kém đi.
Lọc ngôn ngữ, an toàn và chất lượng
Bước đầu là nhận diện ngôn ngữ bằng bộ phân loại fastText. FineWeb giữ trang tiếng Anh có điểm từ 0,65; Dolma dùng ngưỡng 0,5 và bỏ 61,7% dữ liệu tính theo dung lượng; Llama 3 phân trang vào 176 ngôn ngữ. Tiếp theo là lọc an toàn: danh sách chặn tên miền người lớn, bỏ các tên miền chứa nhiều thông tin cá nhân, và trong bản FineWeb công bố thì địa chỉ email, địa chỉ IP được thay bằng chuỗi ẩn danh.
Lọc chất lượng bằng quy tắc là phần thú vị nhất. Bộ C4 bỏ dòng không kết thúc bằng dấu câu, dòng nhắc javascript hay chính sách cookie, bỏ trang có "lorem ipsum" hoặc dấu ngoặc nhọn. FineWeb thử lại và thấy riêng quy tắc dấu câu đã xóa khoảng 30% token, quá nhiều, nên bỏ quy tắc này. Thay vào đó, họ so hơn 50 chỉ số giữa một bản dữ liệu tốt và một bản kém, chọn ra ba bộ lọc mới. Ba bộ lọc cùng xóa khoảng 22% token và nâng điểm trung bình khoảng 1%. Đoạn code dưới cài lại đúng ba ngưỡng trong bài báo:
"""Ba bộ lọc theo dòng mà FineWeb thêm vào (Penedo và cộng sự 2024, mục 3.6).

Một trang bị loại nếu:
  1. tỉ lệ dòng kết thúc bằng dấu câu <= 0,12;
  2. tỉ lệ ký tự nằm trong các dòng lặp lại >= 0,1 (tính từ lần xuất hiện thứ hai của mỗi dòng);
  3. tỉ lệ dòng ngắn hơn 30 ký tự >= 0,67.
Chạy: python bo_loc.py
"""
from collections import Counter

DAU_KET = (".", "!", "?", "…")


def chi_so(van_ban):
    dong = [d.strip() for d in van_ban.splitlines() if d.strip()]
    tong_ky_tu = sum(len(d) for d in dong)
    dem = Counter()
    ky_tu_lap = 0
    for d in dong:
        if dem[d]:  # dòng này đã xuất hiện trước đó
            ky_tu_lap += len(d)
        dem[d] += 1
    return {
        "dong_co_dau_cau": sum(d.endswith(DAU_KET) for d in dong) / len(dong),
        "ky_tu_dong_lap": ky_tu_lap / tong_ky_tu,
        "dong_ngan": sum(len(d) < 30 for d in dong) / len(dong),
    }


def ly_do_loai(van_ban):
    c = chi_so(van_ban)
    ly_do = []
    if c["dong_co_dau_cau"] <= 0.12:
        ly_do.append("ít dòng kết thúc bằng dấu câu")
    if c["ky_tu_dong_lap"] >= 0.1:
        ly_do.append("nhiều dòng lặp lại")
    if c["dong_ngan"] >= 0.67:
        ly_do.append("phần lớn là dòng ngắn")
    return ly_do


TRANG_TOT = """Thư viện thành phố mở cửa thêm buổi tối từ tháng sau để học sinh có chỗ ôn thi.
Phòng đọc tầng hai có thêm chỗ ngồi, ổ cắm điện và mạng không dây miễn phí.
Học sinh chưa có thẻ có thể làm thẻ tại quầy với ảnh chân dung và giấy xác nhận của trường."""

TRANG_MENU = """Trang chủ
Tin tức
Đăng nhập
Giỏ hàng (0)
Khuyến mãi hôm nay
Liên hệ"""

TRANG_LAP = """Giảm giá 50% cho mọi đơn hàng trong hôm nay, mua ngay kẻo hết!
Giảm giá 50% cho mọi đơn hàng trong hôm nay, mua ngay kẻo hết!
Giảm giá 50% cho mọi đơn hàng trong hôm nay, mua ngay kẻo hết!
Sản phẩm được giao tận nhà trong vòng hai ngày làm việc."""

if __name__ == "__main__":
    for ten, trang in [("trang tốt", TRANG_TOT), ("trang menu", TRANG_MENU), ("trang lặp", TRANG_LAP)]:
        c = chi_so(trang)
        so = ", ".join(f"{k} = {v:.2f}" for k, v in c.items())
        print(f"{ten}: {so} -> {ly_do_loai(trang) or 'giữ lại'}")
Trang thông báo được giữ lại. Trang chỉ có menu bị loại vì hai lý do: không dòng nào kết thúc bằng dấu câu và mọi dòng đều ngắn hơn 30 ký tự. Trang quảng cáo lặp ba lần một câu có 51% ký tự nằm trong dòng lặp, vượt xa ngưỡng 0,1.
Quy tắc chỉ bắt được rác dễ thấy, nên các nhóm lớn thêm bộ lọc bằng mô hình. Llama 3 dùng một bộ phân loại fastText học cách nhận ra văn bản có thể được Wikipedia trích dẫn, và các bộ phân loại DistilRoberta học từ nhận xét của Llama 2. FineWeb-Edu làm rõ hơn cả: Llama-3-70B-Instruct chấm 460.000 trang trên thang 0 đến 5 về giá trị giáo dục, rồi một bộ hồi quy nhỏ học lại cách chấm đó để chạy trên toàn bộ 15 nghìn tỷ token, tốn 6.000 giờ GPU H100. Giữ trang có điểm từ 3 còn 1,3 nghìn tỷ token. Mô hình 1,71 tỷ tham số học 350 tỷ token từ bản này tăng MMLU từ 33% lên 37% và ARC từ 46% lên 57%.
Khử trùng lặp: chính xác và gần đúng
Web đầy bản sao: trang tổng hợp tin, trang gương, trang dựng từ cùng một khuôn. FineWeb nhắc rằng khử trùng lặp (deduplication) gắn với mô hình tốt hơn và ít học thuộc dữ liệu hơn. Cách đơn giản nhất là so chính xác. Dolma khử trùng ba tầng bằng bộ lọc Bloom: trùng địa chỉ URL loại 53,2% số trang, trùng nguyên trang loại thêm 14,9% số trang còn lại, trùng đoạn văn loại 18,7% số đoạn. Llama 3 còn bỏ mọi dòng xuất hiện quá 6 lần trong mỗi nhóm 30 triệu trang; bước này xóa menu, cảnh báo cookie, và cả một số câu chất lượng tốt nhưng xuất hiện nhiều lần, vậy mà thử nghiệm vẫn cho kết quả tốt hơn rõ.
Bản chép có sửa vài chữ thì phép so chính xác bỏ sót. Khi đó người ta đo độ giống Jaccard giữa hai tập cụm năm từ liên tiếp (5-gram), và ước lượng nó bằng MinHash: với mỗi hàm băm, giữ giá trị băm nhỏ nhất trên mọi cụm của trang. Xác suất hai trang có cùng giá trị nhỏ nhất đúng bằng độ giống Jaccard, nên tỉ lệ vị trí trùng trong chữ ký là một ước lượng của nó. FineWeb dùng 112 hàm băm chia thành 14 nhóm, mỗi nhóm 8 giá trị; hai trang bị coi là trùng nếu khớp đủ 8 giá trị ở ít nhất một nhóm. Với độ giống \(s\), xác suất bị bắt là:
\[P(s) = 1 - \left(1 - s^{8}\right)^{14}\]
"""Tìm hai trang gần trùng nhau bằng MinHash, đặt tham số như FineWeb:
cụm 5 từ liên tiếp, 112 hàm băm chia thành 14 nhóm, mỗi nhóm 8 giá trị.
Hai trang bị coi là trùng nếu có ít nhất một nhóm khớp đủ cả 8 giá trị.
Chạy: python minhash.py
"""
import hashlib

import numpy as np

P = 2_147_483_647  # 2^31 - 1, một số nguyên tố
SO_HAM, SO_NHOM, MOI_NHOM = 112, 14, 8
rng = np.random.default_rng(2024)
HE_A = rng.integers(1, P, size=SO_HAM, dtype=np.uint64)
HE_B = rng.integers(0, P, size=SO_HAM, dtype=np.uint64)


def cum_5_tu(van_ban, n=5):
    tu = van_ban.lower().split()
    return {" ".join(tu[i:i + n]) for i in range(len(tu) - n + 1)}


def chu_ky(tap_cum):
    """Với mỗi hàm băm h(x) = (a*x + b) mod P, giữ giá trị nhỏ nhất trên mọi cụm."""
    x = np.array([int.from_bytes(hashlib.blake2b(c.encode("utf-8"), digest_size=8).digest(), "big") % P
                  for c in tap_cum], dtype=np.uint64)
    return ((HE_A[:, None] * x[None, :] + HE_B[:, None]) % P).min(axis=1)


def jaccard(t1, t2):
    return len(t1 & t2) / len(t1 | t2)


def uoc_luong_jaccard(c1, c2):
    return float(np.mean(c1 == c2))


def bi_coi_la_trung(c1, c2):
    khop = np.all(c1.reshape(SO_NHOM, MOI_NHOM) == c2.reshape(SO_NHOM, MOI_NHOM), axis=1)
    return bool(khop.any())


def xac_suat_bat(s):
    """Xác suất hai trang có độ giống s bị bắt: 1 - (1 - s^8)^14."""
    return 1 - (1 - s ** MOI_NHOM) ** SO_NHOM


GOC = ("Thư viện thành phố mở cửa thêm buổi tối từ tháng sau để học sinh có chỗ ôn thi. Phòng đọc tầng hai có "
       "thêm sáu mươi chỗ ngồi, ổ cắm điện và mạng không dây miễn phí. Bạn đọc cần mang thẻ thư viện còn hạn; học "
       "sinh chưa có thẻ có thể làm thẻ tại quầy với ảnh chân dung và giấy xác nhận của trường. Thư viện đề nghị "
       "bạn đọc giữ im lặng, không mang đồ ăn vào phòng và trả sách đúng hạn để người khác cùng dùng.")
CUOI = " Theo báo Ví Dụ. Hãy đăng ký nhận bản tin để không bỏ lỡ tin mới."
CHEP = "Tin mới: " + GOC + CUOI  # chép nguyên bài, chỉ thêm đầu và cuối trang
SUA = "Tin mới: " + GOC.replace("sáu mươi", "60").replace("đúng hạn", "đúng thời hạn") + CUOI  # sửa thêm hai chỗ
KHAC = ("Câu lạc bộ lập trình của trường tuyển thành viên mới cho học kỳ này. Buổi sinh hoạt đầu tiên giới thiệu "
        "Python, cách cài đặt môi trường và một bài tập nhỏ về vòng lặp. Thành viên mới không cần biết lập trình "
        "trước, chỉ cần mang máy tính xách tay và đăng ký qua biểu mẫu của câu lạc bộ trước thứ sáu.")

if __name__ == "__main__":
    tap = {ten: cum_5_tu(v) for ten, v in [("gốc", GOC), ("chép", CHEP), ("sửa", SUA), ("khác", KHAC)]}
    ck = {ten: chu_ky(t) for ten, t in tap.items()}
    for a, b in [("gốc", "chép"), ("gốc", "sửa"), ("gốc", "khác")]:
        print(f"{a} - {b}: Jaccard thật = {jaccard(tap[a], tap[b]):.2f}, "
              f"MinHash ước lượng = {uoc_luong_jaccard(ck[a], ck[b]):.2f}, "
              f"coi là trùng: {bi_coi_la_trung(ck[a], ck[b])}")
    for s in (0.7, 0.75, 0.8, 0.85):
        print(f"độ giống {s:.2f}: xác suất bị bắt = {xac_suat_bat(s):.1%}")
| Cặp trang | Jaccard thật | MinHash ước lượng | Coi là trùng |
|---|---|---|---|
| Gốc và bản chép thêm đầu, cuối trang | 0,83 | 0,82 | Có |
| Gốc và bản chép có sửa hai chỗ | 0,68 | 0,65 | Không |
| Gốc và một bài khác | 0,00 | 0,00 | Không |
Công thức cho đúng các số trong phụ lục của bài báo: độ giống 0,7; 0,75; 0,8 và 0,85 bị bắt với xác suất 56%, 77%, 92% và 98,8%. Dòng thứ hai của bảng đáng chú ý: trên một trang ngắn, chỉ sửa hai chỗ đã kéo Jaccard xuống 0,68, vì mỗi chữ bị sửa làm hỏng tới 5 cụm. Bộ tham số 14 nhóm 8 giá trị nhắm vào các trang giống nhau từ khoảng 75% trở lên, nên trang giống vừa phải thường lọt qua.
Bài học từ FineWeb: khử trùng quá tay
Lúc đầu nhóm FineWeb khử trùng gộp cả 96 đợt thu thập, từ đợt mới nhất về đợt cũ nhất. Kết quả còn 4 nghìn tỷ token, nhưng mô hình học từ đó gần như không tốt hơn bản chưa khử trùng. Họ xét kỹ đợt 2013-48: phần được giữ lại, chỉ 10% dữ liệu gốc, lại kém hơn phần bị xóa, vì chứa nhiều quảng cáo và danh sách từ khóa. Khi khử trùng riêng trong từng đợt, họ còn 20 nghìn tỷ token và mô hình tốt ngang RefinedWeb, một bộ dữ liệu web mạnh có trước. Giả thuyết của họ: lợi ích chính đến từ việc xóa những cụm bản sao rất lớn, còn xóa tiếp các cụm nhỏ có thể làm hại.
Bài học về phương pháp quan trọng hơn con số: mọi quyết định đều được đo bằng mô hình thử. FineWeb huấn luyện hơn 70 mô hình thử cỡ 1,71 tỷ tham số (mô hình thử bộ lọc học khoảng 28 tỷ token), tổng cộng khoảng 80.000 giờ GPU H100, thay vì tin vào trực giác "càng sạch càng tốt".
Chống lọt đề kiểm tra
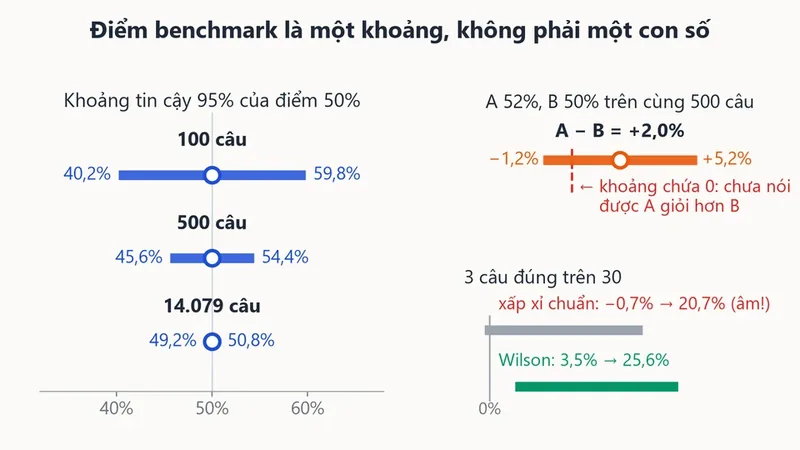
Nếu câu hỏi của một bài đo nằm sẵn trong dữ liệu huấn luyện, điểm đo sẽ đẹp giả. Dolma dùng chính bộ lọc Bloom để chống chuyện này: nạp trước các câu kiểm tra vào bộ lọc, rồi đánh dấu mọi đoạn trùng khi trộn dữ liệu. Llama 3 ghi rõ không đưa tập huấn luyện của các bài đo phổ biến vào dữ liệu ủ (annealing) ở giai đoạn cuối, để đo đúng khả năng học từ vài ví dụ. Chuyện nhiễm đề và cách đọc điểm cho đúng có trong bài benchmark AI là gì.
- Nghĩ dữ liệu càng nhiều càng tốt: FineWeb-Edu nhỏ hơn FineWeb hơn mười lần nhưng cho điểm MMLU và ARC cao hơn.
- Khử trùng thật gắt mà không đo: khử trùng gộp nhiều đợt có thể giữ lại đúng phần kém.
- Dùng lại một ngưỡng lọc cho ngôn ngữ khác: các ngưỡng trên được chọn cho tiếng Anh, tiếng Việt cần đo lại.
- Bỏ qua bước chống lọt đề, rồi tin vào điểm bài đo của chính mình.
Câu hỏi thường gặp
Common Crawl là gì?
Là một tổ chức phi lợi nhuận và kho dữ liệu web miễn phí do tổ chức này thu thập từ năm 2008, chia thành từng đợt, mỗi đợt có tệp WARC, WAT và WET.
Pretraining là gì?
Là giai đoạn mô hình đọc hàng nghìn tỷ token để học đoán token kế tiếp, trước khi được tinh chỉnh để làm theo yêu cầu.
Vì sao không dùng thẳng tệp WET đã tách chữ sẵn?
Theo FineWeb, tệp WET còn nhiều menu và chữ thừa; tự tách chữ từ WARC cho mô hình tốt hơn, dù tốn công hơn.
MinHash có bắt được mọi bản sao không?
Không. Đó là phép ước lượng xác suất: trang giống nhau 75% bị bắt khoảng 77% số lần, trang giống 85% thì gần như luôn bị bắt.
Học tiếp
- Scaling law là gì: vì sao mô hình lớn cần nhiều token.
- Bộ dữ liệu để luyện AI: bộ dữ liệu nhỏ để bạn tự thực hành.
- Benchmark AI là gì: đọc điểm bài đo và chuyện nhiễm đề.
- Kiện bản quyền AI: tòa án nói gì khi dữ liệu huấn luyện có sách, báo được bảo hộ.
Nếu bạn muốn học Python và học máy bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.
Nguồn tham khảo
- Penedo và cộng sự (2024), The FineWeb Datasets, arXiv 2406.17557v2 (PDF, đọc 12/11/2026)
- Soldaini và cộng sự (2024), Dolma: an Open Corpus of Three Trillion Tokens, arXiv 2402.00159v2 (PDF, đọc 12/11/2026)
- Llama Team, Meta (2024), The Llama 3 Herd of Models, mục 3.1, arXiv 2407.21783v3 (PDF, đọc 12/11/2026)
- Common Crawl: trang chủ và trang Get Started (đọc 12/11/2026)
- NumPy (thư viện dùng trong code)