- Reranker chấm lại các ứng viên do bước tìm đầu tiên trả về, bằng mô hình đọc câu hỏi và đoạn cùng lúc, nên chính xác hơn nhưng chậm hơn.
- Vì chậm, reranker chỉ chạy trên vài chục đến vài trăm ứng viên, không chạy trên cả kho.
- Trong thử nghiệm của Anthropic, thêm bước xếp hạng lại đưa tỷ lệ tìm hụt (khi lấy 20 đoạn đầu) từ 2,9% xuống 1,9%.
- Thêm reranker khi số đo cho thấy đoạn đúng thường có trong ứng viên nhưng đứng thấp; đổi lại là thêm độ trễ và chi phí.
Bài này dựa trên bài viết Contextual Retrieval của Anthropic, trang Cross-Encoders trong tài liệu thư viện Sentence Transformers và trang mô hình xếp hạng lại của Voyage AI trong tài liệu MongoDB, đọc ngày 11/11/2026. Nên đọc trước bài embedding là gì và đánh giá hệ thống RAG.
Vì sao tìm một bước chưa đủ
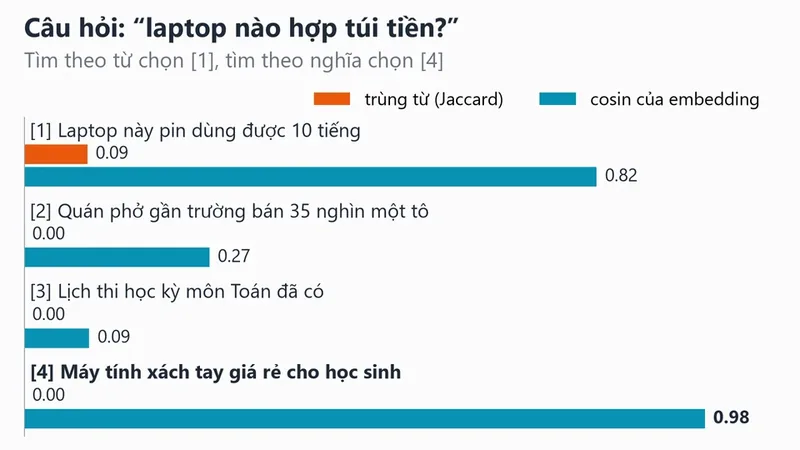
Tìm bằng embedding biến câu hỏi và từng đoạn thành vector riêng rẽ, rồi so khoảng cách. Vì mỗi đoạn được nhúng một lần từ trước, việc tìm trên hàng triệu đoạn vẫn nhanh. Cái giá là mô hình không bao giờ nhìn câu hỏi và đoạn cùng lúc; nó chỉ so hai bản tóm tắt dạng số. Các chi tiết như phủ định, con số, quan hệ giữa các ý có thể bị mất.
Trang tài liệu của Sentence Transformers giải thích sự khác biệt này bằng hai loại mô hình. Bi-encoder nhúng từng câu riêng rồi so bằng cosin. Cross-encoder đưa cả hai câu vào mô hình cùng lúc và cho ra một điểm liên quan, thường chính xác hơn, nhưng không tạo ra vector để lưu trước. Ví dụ trong tài liệu: muốn chia 10.000 câu thành các nhóm giống nhau, cross-encoder cần chấm khoảng 50 triệu cặp, mất cỡ 65 giờ; bi-encoder chỉ cần nhúng mỗi câu một lần, khoảng 5 giây.
Từ đó ra cách làm hai bước: bi-encoder tìm nhanh một nhóm ứng viên, cross-encoder chấm kỹ từng cặp câu hỏi và ứng viên rồi xếp lại.
Số liệu từ Anthropic
Bài viết Contextual Retrieval của Anthropic thử nhiều cách tìm và đo tỷ lệ tìm hụt, tức tỷ lệ câu hỏi mà đoạn đúng không nằm trong 20 đoạn đầu. Cách tìm cơ bản hụt 5,7%. Thêm ngữ cảnh cho từng đoạn trước khi nhúng giảm còn 3,7%. Kết hợp thêm tìm theo từ khóa còn 2,9%. Thêm bước xếp hạng lại còn 1,9%, tức giảm 67% so với cách cơ bản.
Cách họ dùng reranker: lấy 150 đoạn đầu từ bước tìm ban đầu, cho mô hình xếp hạng lại chấm từng đoạn với câu hỏi, rồi giữ 20 đoạn cao nhất đưa cho mô hình trả lời. Bài viết cũng nói rõ cái giá: thêm một bước khi chạy nên thêm chút độ trễ dù các đoạn được chấm song song, và xếp hạng lại càng nhiều đoạn thì càng tốt nhưng càng chậm, càng tốn; nên thử trên trường hợp của mình.
Ví dụ: luồng hai bước bằng Python
Đoạn code dưới đây minh họa luồng xử lý trên một kho 6 đoạn về khóa học. Bước một đếm số từ chung giữa câu hỏi và mỗi đoạn, lấy 4 ứng viên. Bước hai là một hàm giả lập bộ xếp hạng lại: nó xét câu hỏi và đoạn cùng lúc, bỏ các từ không mang nghĩa, và biết vài cặp từ đồng nghĩa như "vắng" với "nghỉ", "tiền" với "phí". Bộ xếp hạng lại thật là một mô hình học từ dữ liệu, không phải danh sách từ đồng nghĩa; hàm giả lập chỉ để thấy luồng dữ liệu đi qua hai bước.
"""Tìm hai bước: bước 1 lấy nhanh nhiều ứng viên, bước 2 xếp hạng lại kỹ hơn trên số ít ứng viên đó.

- buoc_1: đếm từ chung giữa câu hỏi và đoạn (rẻ, chạy được trên cả kho).
- xep_lai: GIẢ LẬP một bộ xếp hạng lại: xét câu hỏi và đoạn CÙNG LÚC, biết vài từ đồng nghĩa, bỏ từ vô nghĩa.
  Bộ xếp hạng lại thật là một mô hình (cross-encoder hoặc dịch vụ rerank); hàm này chỉ để thấy luồng xử lý.
Kho đoạn và câu hỏi là dữ liệu tự soạn để minh họa.
"""
import re

KHO = {
    "d1": "Học phí khóa Python cơ bản là 3 triệu đồng cho 12 buổi.",
    "d2": "Lớp Python cơ bản học tối thứ ba và thứ năm, mỗi buổi 2 giờ.",
    "d3": "Học viên nghỉ quá 3 buổi sẽ không được cấp chứng nhận hoàn thành.",
    "d4": "Khóa thuật toán nâng cao yêu cầu đã học xong cấu trúc dữ liệu.",
    "d5": "Học phí khóa thuật toán nâng cao là 5 triệu đồng cho 16 buổi.",
    "d6": "Có thể học bù buổi đã nghỉ ở lớp khác cùng khóa nếu còn chỗ.",
}
BO_HOI = [
    ("Một khóa thuật toán tốn bao nhiêu tiền?", "d5"),
    ("Vắng mặt nhiều thì sao?", "d3"),
    ("Học phí khóa Python cơ bản bao nhiêu?", "d1"),
]
DONG_NGHIA = {"tốn": {"phí"}, "tiền": {"phí", "đồng"}, "vắng": {"nghỉ"}, "nhiều": {"quá"}}
TU_RONG = {"thì", "sao", "một", "bao", "nhiêu", "có", "là", "và", "cho", "đã"}


def tu(s):
    return set(re.findall(r"\w+", s.lower()))


def buoc_1(cau_hoi, kho, n=4):
    diem = {m: len(tu(cau_hoi) & tu(d)) for m, d in kho.items()}
    return sorted(diem, key=lambda m: (-diem[m], m))[:n]


def diem_xep_lai(cau_hoi, doan):
    q = tu(cau_hoi) - TU_RONG
    mo_rong = q | set().union(*(DONG_NGHIA.get(t, set()) for t in q))
    return len(mo_rong & tu(doan))


def xep_lai(cau_hoi, ung_vien, kho, k=2):
    return sorted(ung_vien, key=lambda m: (-diem_xep_lai(cau_hoi, kho[m]), ung_vien.index(m)))[:k]


def hang(ds, dung):
    return ds.index(dung) + 1 if dung in ds else None


def chay_thu():
    dong = [f"Kho {len(KHO)} đoạn; bước 1 lấy 4 ứng viên, bước 2 giữ 2 đoạn đưa vào prompt"]
    for cau, dung in BO_HOI:
        uv = buoc_1(cau, KHO)
        cuoi = xep_lai(cau, uv, KHO)
        dong.append(f"  '{cau}': bước 1 xếp đoạn đúng thứ {hang(uv, dung)}, sau xếp lại thứ {hang(cuoi, dung)}; "
                    f"số đoạn được chấm kỹ {len(uv)}/{len(KHO)}")
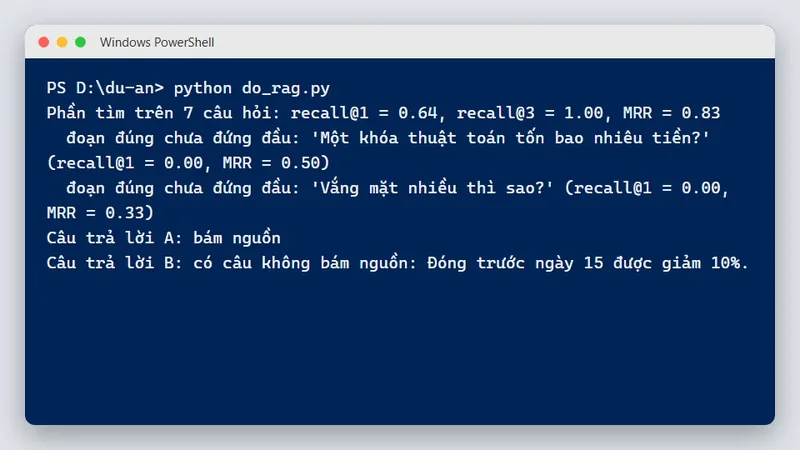
    print("\n".join(dong))
    return dong


if __name__ == "__main__":
    chay_thu()
Với câu "Một khóa thuật toán tốn bao nhiêu tiền?", bước một xếp đoạn học phí khóa thuật toán thứ hai, sau đoạn về điều kiện học khóa thuật toán, vì hai đoạn có cùng số chữ trùng. Bước hai đưa đoạn học phí lên đầu. Với câu "Vắng mặt nhiều thì sao?", bước một xếp đoạn quy định nghỉ học thứ ba vì không có chữ nào trùng; bước hai đưa lên đầu nhờ hiểu "vắng" gần nghĩa "nghỉ". Câu hỏi thứ ba vốn đã đúng từ bước một và vẫn đúng. Quan trọng: bước hai chỉ chấm 4 trên 6 đoạn. Với kho thật hàng triệu đoạn, tỷ lệ này là vài trăm trên hàng triệu.
Một hệ quả cần nhớ: reranker chỉ sắp xếp lại những gì bước một đưa cho nó. Nếu đoạn đúng không nằm trong ứng viên, reranker không cứu được. Vì vậy bước một nên lấy dư ứng viên, ưu tiên không bỏ sót hơn là xếp đúng.
Khi nào nên thêm reranker
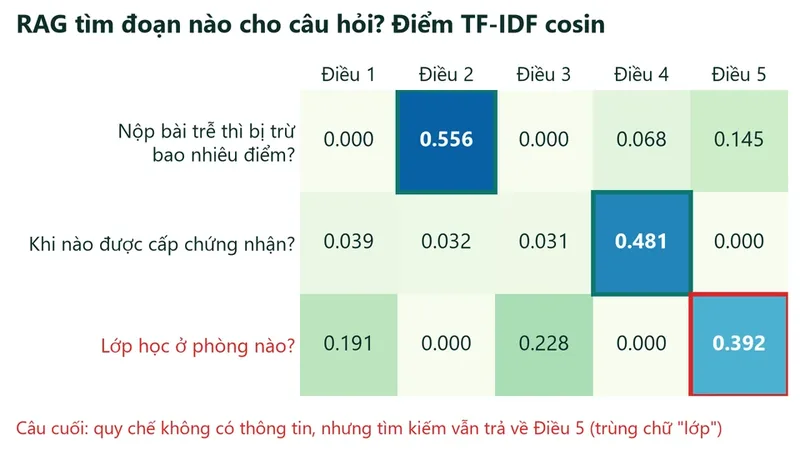
Đo trước khi thêm. Dùng bộ câu hỏi có đáp án như trong bài đánh giá hệ thống RAG, tính recall ở hai mức: với số ứng viên lớn (ví dụ 50) và với số đoạn thật sự đưa vào prompt (ví dụ 5). Nếu recall ở mức 50 cao mà ở mức 5 thấp, đoạn đúng có trong ứng viên nhưng đứng thấp: đây đúng là việc reranker làm tốt. Nếu recall ở mức 50 cũng thấp, vấn đề nằm ở bước một (cách chia đoạn, mô hình embedding), reranker không giúp được.
Cũng cân nhắc độ trễ. Chatbot cần trả lời trong vài giây; mỗi bước thêm vào đều cộng thời gian. Với ứng dụng chạy nền như tóm tắt hàng loạt, độ trễ ít quan trọng hơn.
Đưa vào hệ thống thế nào
Trong code, reranker chỉ là một hàm chen giữa bước tìm và bước tạo prompt: nhận câu hỏi và danh sách ứng viên, trả về danh sách đã xếp lại. Thiết kế như vậy giúp bật tắt dễ dàng để so sánh. Chạy bộ câu hỏi hai lần, một lần có và một lần không có bước xếp lại, ghi recall, MRR và thời gian trung bình mỗi câu. Nếu chất lượng tăng rõ mà thời gian còn chấp nhận được thì giữ; nếu chỉ nhích lên chút ít, bỏ đi cho hệ thống gọn hơn.
Hai mẹo nhỏ khi chạy thật. Cắt bớt đoạn quá dài trước khi đưa cho mô hình xếp hạng lại, vì mô hình nào cũng có giới hạn độ dài đầu vào. Và ghi lại điểm của cả bước một lẫn bước hai trong nhật ký; khi một câu trả lời sai, bạn biết ngay đoạn đúng đã bị bỏ ở bước nào.
Chọn reranker
Có hai nhóm: mô hình mở chạy trên máy của bạn (nhiều cross-encoder có sẵn trên Hugging Face), và dịch vụ qua API. Trang tài liệu của Voyage AI liệt kê các mô hình xếp hạng lại của họ, có bản ưu tiên chất lượng và bản ưu tiên tốc độ, chi phí. Với văn bản tiếng Việt, ưu tiên mô hình đa ngôn ngữ và đo trên dữ liệu của mình, vì nhiều mô hình phổ biến được huấn luyện chủ yếu bằng tiếng Anh.
Một lựa chọn khác là dùng chính mô hình ngôn ngữ lớn để chấm độ liên quan. Cách này linh hoạt nhưng chậm và tốn hơn nhiều so với mô hình xếp hạng lại chuyên dụng; hợp khi số ứng viên ít và cần lý do rõ ràng.
- Thêm reranker mà chưa đo xem lỗi nằm ở bước một hay ở thứ hạng.
- Lấy quá ít ứng viên ở bước một, rồi mong reranker tìm ra đoạn đúng không có trong đó.
- Chạy reranker trên cả kho thay vì trên ứng viên.
- Chọn mô hình chỉ huấn luyện tiếng Anh cho dữ liệu tiếng Việt mà không đo.
- Quên tính độ trễ thêm vào cho ứng dụng cần trả lời nhanh.
Câu hỏi thường gặp
Reranker khác mô hình embedding thế nào?
Mô hình embedding biến từng văn bản thành vector để lưu và so nhanh. Reranker nhận cả câu hỏi và đoạn cùng lúc, cho ra một điểm liên quan, không tạo vector.
Nên lấy bao nhiêu ứng viên?
Đủ để đoạn đúng gần như luôn có mặt. Anthropic dùng 150 trong thử nghiệm; với kho nhỏ, vài chục là đủ. Đo recall ở các mức khác nhau để chọn.
Có cần reranker nếu dùng tìm kết hợp từ khóa và embedding?
Có thể vẫn có ích, như số liệu của Anthropic cho thấy. Đo trên dữ liệu của bạn để quyết định.
Reranker có giúp giảm chi phí mô hình trả lời không?
Có thể: khi thứ hạng tốt hơn, bạn đưa ít đoạn hơn vào prompt mà vẫn đủ thông tin.
Học tiếp
- Đo xem có cần reranker: đánh giá hệ thống RAG.
- Bước tìm đầu tiên: embedding là gì.
- Toàn cảnh hệ thống: RAG là gì.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.