- Nếu văn bản vừa trong cửa sổ ngữ cảnh và chi phí chấp nhận được, đưa thẳng cả văn bản thường cho bản tóm tắt tốt nhất, vì mô hình thấy toàn cảnh.
- Nếu không vừa, chia văn bản thành phần, tóm tắt từng phần (map), rồi gộp các bản tóm tắt (reduce). Văn bản rất dài thì gộp nhiều tầng.
- Chia theo đoạn văn, mục, chương; không cắt giữa câu. Dặn mô hình giữ nguyên số liệu, tên riêng, mốc thời gian ở mọi bước.
- Với văn bản dài trong một prompt: đặt văn bản ở trên, câu hỏi ở cuối; tài liệu của Anthropic ghi cách này có thể cải thiện chất lượng tới 30% trong thử nghiệm.
Bài này dựa trên mục Long context prompting trong trang hướng dẫn viết prompt của Anthropic (đọc ngày 11/11/2026) và bài hướng dẫn tóm tắt văn bản dài bằng map-reduce trên blog Google Cloud (đọc ngày 14/11/2026).
Đưa thẳng hay chia nhỏ
Cách đơn giản nhất là đưa cả văn bản vào một lần gọi và xin tóm tắt. Mô hình đọc hết nên nắm được mạch chung, nối được ý ở chương đầu với kết luận ở chương cuối. Mô hình hiện nay có cửa sổ ngữ cảnh lớn, nên nhiều văn bản dài vẫn vừa một lần gọi. Trước khi chia, hãy đếm token như trong bài đếm token trước khi gọi API để biết văn bản của bạn có vừa không.
Khi văn bản vượt cửa sổ ngữ cảnh, hoặc vừa nhưng chi phí một lần gọi quá cao, hoặc bạn cần tóm tắt từng chương riêng, thì chia nhỏ. Cách chia nhỏ phổ biến nhất có tên map-reduce: map là tóm tắt từng phần độc lập, reduce là gộp các bản tóm tắt thành một. Bài hướng dẫn trên blog Google Cloud mô tả đúng hai bước này: tóm tắt từng phần, rồi tóm tắt tất cả các bản tóm tắt ở bước cuối; vì các phần độc lập nên bước map chạy song song được, nhanh hơn làm tuần tự.
Còn một cách nữa là làm dần, bài của Google Cloud gọi là refinement: tóm tắt phần một, rồi đưa bản tóm tắt cùng phần hai để cập nhật, cứ thế tới hết. Cách này giữ mạch tốt hơn nhưng không chạy song song được và lỗi ở bước đầu kéo dài tới cuối.
Viết prompt cho văn bản dài
Mục Long context prompting trong tài liệu của Anthropic, áp dụng cho đầu vào từ khoảng 20.000 token trở lên, có ba lời khuyên. Đặt văn bản dài ở đầu prompt, phía trên câu hỏi và chỉ dẫn; tài liệu ghi đặt câu hỏi ở cuối có thể cải thiện chất lượng câu trả lời tới 30% trong thử nghiệm, nhất là với đầu vào nhiều tài liệu. Bọc mỗi tài liệu trong thẻ kiểu XML kèm thông tin nguồn khi có nhiều tài liệu. Và với việc dài, nhờ mô hình trích các đoạn liên quan trước rồi mới làm việc chính.
Với tóm tắt, thêm vài dặn dò thực tế: giữ nguyên số liệu, tên người, tên tổ chức, ngày tháng; ghi rõ độ dài mong muốn (số gạch đầu dòng hoặc số câu); nói rõ người đọc là ai (sinh viên, ban giám hiệu, phụ huynh) vì điều đó quyết định ý nào quan trọng.
Ví dụ: tự chọn cách và gộp nhiều tầng
Đoạn Python dưới đây có hàm tom_tat nhận văn bản và một hàm gọi mô hình. Nếu văn bản không quá ngân sách (đo bằng số từ cho đơn giản), nó đưa thẳng một lần. Nếu quá, nó chia theo đoạn văn thành các phần không vượt ngân sách, tóm tắt từng phần với prompt có thẻ ghi rõ đây là phần mấy trên mấy, rồi gộp. Nếu các bản tóm tắt nối lại vẫn quá ngân sách, nó chia các bản tóm tắt thành nhóm và gộp từng nhóm, lặp lại thành nhiều tầng cho tới khi vừa, rồi gộp lần cuối.
"""Tóm tắt văn bản dài: đưa thẳng nếu vừa ngân sách; nếu không thì chia đoạn, tóm tắt từng đoạn (map), gộp (reduce),
và gộp nhiều tầng nếu các bản tóm tắt vẫn quá dài.

Hàm tom_tat nhận một hàm `goi(prompt) -> chữ` để dễ thay: khi chạy thử dùng goi_gia (lấy 150 từ đầu, KHÔNG phải
tóm tắt thật, chỉ để đếm số lần gọi và xem cấu trúc); khi chạy thật dùng goi_claude.
Độ dài đo bằng số từ cho đơn giản; khi chạy thật nên đếm token bằng endpoint đếm token.
Cài: python -m pip install anthropic ; đặt ANTHROPIC_API_KEY để chạy thật.
"""
import os
import re
import sys

MAU_MAP = ("<tai_lieu phan=\"{i}/{n}\">\n{doan}\n</tai_lieu>\n\n"
           "Tóm tắt phần tài liệu trên trong tối đa 5 gạch đầu dòng. Giữ nguyên số liệu, tên riêng, mốc thời gian.")
MAU_REDUCE = ("<cac_ban_tom_tat>\n{tom_tat}\n</cac_ban_tom_tat>\n\n"
              "Gộp các bản tóm tắt trên thành một bản tóm tắt chung, bỏ ý trùng, giữ số liệu. Tối đa 8 gạch đầu dòng.")


def so_tu(s):
    return len(s.split())


def chia_doan(van_ban, toi_da_tu):
    """Ghép các đoạn văn (cách nhau bởi dòng trống) thành phần không quá toi_da_tu từ; không cắt giữa đoạn văn."""
    phan, hien = [], []
    for dv in [d.strip() for d in re.split(r"\n\s*\n", van_ban) if d.strip()]:
        if hien and so_tu("\n\n".join(hien + [dv])) > toi_da_tu:
            phan.append("\n\n".join(hien))
            hien = []
        hien.append(dv)
    if hien:
        phan.append("\n\n".join(hien))
    return phan


def tom_tat(van_ban, goi, ngan_sach_tu=3000, nhat_ky=None):
    nk = nhat_ky if nhat_ky is not None else []
    if so_tu(van_ban) <= ngan_sach_tu:
        nk.append("đưa thẳng")
        return goi(MAU_MAP.format(i=1, n=1, doan=van_ban))
    phan = chia_doan(van_ban, ngan_sach_tu)
    ban = [goi(MAU_MAP.format(i=i, n=len(phan), doan=p)) for i, p in enumerate(phan, 1)]
    nk.append(f"map {len(phan)} phần")
    tang = 1
    while so_tu("\n\n".join(ban)) > ngan_sach_tu:  # gộp nhiều tầng nếu các bản tóm tắt vẫn dài
        nhom = chia_doan("\n\n".join(ban), ngan_sach_tu)
        ban = [goi(MAU_REDUCE.format(tom_tat=g)) for g in nhom]
        nk.append(f"gộp tầng {tang}: {len(nhom)} nhóm")
        tang += 1
    nk.append("gộp cuối")
    return goi(MAU_REDUCE.format(tom_tat="\n\n".join(ban)))


def goi_gia(prompt, dem):
    """Giả lập: 'bản tóm tắt' là 150 từ đầu của phần nội dung trong thẻ. Chỉ để đếm số lần gọi."""
    dem[0] += 1
    noi_dung = re.search(r">\n(.*)\n</", prompt, re.S).group(1)
    return " ".join(noi_dung.split()[:150])


class KhongCoCauTraLoi(Exception):
    """Mô hình dừng mà không đưa ra bản tóm tắt trọn vẹn."""


def goi_claude(client, mo_hinh="claude-haiku-5-5"):
    def goi(prompt):
        # Haiku 5.5 suy nghĩ trước khi trả lời, và token suy nghĩ tính vào max_tokens dù không hiện ra, nên để rộng chỗ.
        # max_tokens chỉ là mức trần: bạn trả tiền cho số token thật sự sinh ra.
        tl = client.messages.create(model=mo_hinh, max_tokens=16000, messages=[{"role": "user", "content": prompt}])
        # Bản tóm tắt bị cắt hay bị từ chối thì dừng và báo, không đưa chữ dở dang vào bước gộp.
        if tl.stop_reason in ("max_tokens", "model_context_window_exceeded"):
            raise KhongCoCauTraLoi(f"một lần gọi bị cắt giữa chừng ({tl.stop_reason})")
        if tl.stop_reason == "refusal":
            raise KhongCoCauTraLoi("mô hình từ chối tóm tắt một phần của văn bản")
        chu = "".join(k.text for k in tl.content if k.type == "text")
        if not chu.strip():
            raise KhongCoCauTraLoi("mô hình không trả về chữ nào")
        return chu
    return goi


def tao_van_ban(so_doan, tu_moi_doan=120):
    return "\n\n".join(f"Đoạn {i} nói về chủ đề số {i}. " + "nội dung chi tiết " * (tu_moi_doan // 2)
                       for i in range(1, so_doan + 1))


def chay_thu():
    dong = []
    for so_doan in (10, 60, 400):
        vb = tao_van_ban(so_doan)
        dem = [0]
        nk = []
        tom_tat(vb, lambda p: goi_gia(p, dem), ngan_sach_tu=3000, nhat_ky=nk)
        dong.append(f"{so_tu(vb)} từ: {'; '.join(nk)}; tổng {dem[0]} lần gọi mô hình")
    print("\n".join(dong))
    return dong


def main(duong_dan):
    if not os.environ.get("ANTHROPIC_API_KEY"):
        sys.exit("Chưa có ANTHROPIC_API_KEY. Đặt biến môi trường trước khi chạy.")
    import anthropic
    with open(duong_dan, encoding="utf-8") as f:
        vb = f.read()
    try:
        print(tom_tat(vb, goi_claude(anthropic.Anthropic())))
    except KhongCoCauTraLoi as e:
        sys.exit(f"Chưa tóm tắt được: {e}.")
    except anthropic.APIStatusError as e:
        sys.exit(f"API báo lỗi {e.status_code}: {e.message}")
    except anthropic.APIConnectionError:
        sys.exit("Không kết nối được tới API. Kiểm tra mạng rồi thử lại.")


if __name__ == "__main__":
    main(sys.argv[1]) if len(sys.argv) > 1 else chay_thu()
Phần chạy thử dùng một hàm giả lập thay cho mô hình (lấy 150 từ đầu làm "bản tóm tắt"), không phải tóm tắt thật, chỉ để đếm số lần gọi và thấy cấu trúc. Với ngân sách 3.000 từ: văn bản 2.480 từ đưa thẳng, 1 lần gọi; văn bản 14.880 từ chia 5 phần, cộng 1 lần gộp, tổng 6 lần; văn bản 99.200 từ chia 34 phần, các bản tóm tắt vẫn dài nên gộp thêm một tầng 2 nhóm, cộng lần gộp cuối, tổng 37 lần gọi. Khi chạy thật với đường dẫn tệp, chương trình dùng Claude Haiku 5.5, để max_tokens rộng vì phần suy nghĩ của mô hình cũng tính vào đó, và dừng với thông báo rõ nếu một lần gọi vẫn bị cắt hay bị từ chối, không đưa bản tóm tắt dở dang vào bước gộp.
Một ví dụ cụ thể: biên bản họp cả học kỳ
Giả sử bạn có mười lăm biên bản họp tổ bộ môn trong một học kỳ, mỗi biên bản vài trang, và cần một bản tổng kết cho trưởng khoa. Mỗi biên bản là một đơn vị tự nhiên, nên bước map tóm tắt từng biên bản, yêu cầu ghi rõ ngày họp, các quyết định đã chốt, các việc giao cho ai, hạn khi nào. Bước gộp không tóm tắt chung chung mà sắp lại theo chủ đề: chương trình học, thi cử, nhân sự, cơ sở vật chất; trong mỗi chủ đề, liệt kê quyết định theo thời gian và đánh dấu những việc đã giao mà chưa thấy báo xong ở các biên bản sau.
Cách đặt yêu cầu như vậy biến bản tóm tắt thành thứ dùng được ngay, thay vì một đoạn văn dài nhắc lại mọi thứ. Nó cũng giúp kiểm tra dễ hơn: mỗi quyết định trong bản tổng kết đều có ngày họp đi kèm, mở đúng biên bản ngày đó là đối chiếu được.
Hạn chế của chia nhỏ
Mỗi phần được tóm tắt mà không biết các phần khác. Một nhân vật được giới thiệu ở chương một và nhắc lại bằng biệt danh ở chương năm có thể bị hiểu là hai người. Một ý trải dài qua ranh giới hai phần có thể bị mất. Bản tóm tắt cuối cũng có thể nặng về các phần có nhiều chữ, dù chưa chắc quan trọng hơn.
Vài cách giảm: chia theo cấu trúc tự nhiên của tài liệu như chương, mục (xem bài chia đoạn văn bản cho RAG); đưa kèm mỗi phần một dòng ngữ cảnh như tên tài liệu và mục lục; ở bước gộp, nhắc mô hình hợp nhất các tên gọi khác nhau của cùng một đối tượng; và đọc kiểm một mẫu bản tóm tắt với văn bản gốc.
Chi phí và tốc độ
Map-reduce đọc mỗi chữ của văn bản gốc đúng một lần ở bước map, cộng thêm phần đọc các bản tóm tắt ở bước gộp. Bước map chạy song song được, nên nhanh hơn làm dần. Nếu cần tóm tắt hàng trăm tài liệu và không gấp, gửi các yêu cầu bước map theo lô để được giảm giá; xem bài batch API. Với mô hình nhỏ cho bước map và mô hình lớn hơn cho bước gộp cuối, bạn thường được bản tóm tắt tốt với chi phí thấp.
Đánh giá bản tóm tắt
Tóm tắt khó chấm hơn câu hỏi có đáp án. Ba cách đơn giản: kiểm mọi con số và tên riêng trong bản tóm tắt có xuất hiện trong văn bản gốc; liệt kê trước năm ý chính mà người hiểu tài liệu cho là bắt buộc, rồi đếm bản tóm tắt có bao nhiêu ý; và nhờ một người đọc bản tóm tắt rồi trả lời vài câu hỏi về tài liệu. So hai cách tóm tắt trên cùng vài tài liệu mẫu trước khi chọn cách cho cả kho.
- Chia nhỏ ngay cả khi văn bản vừa một lần gọi, làm mất mạch chung.
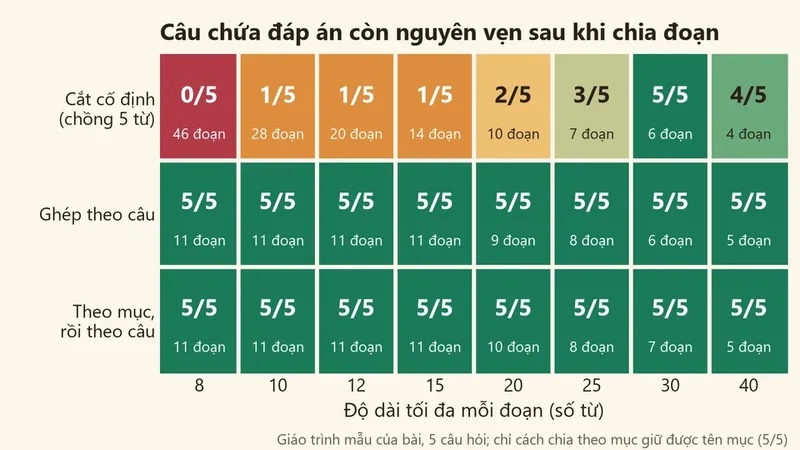
- Cắt theo số ký tự cố định, cắt ngang câu và ngang bảng.
- Không dặn giữ số liệu, để các bước gộp làm tròn hoặc bỏ mất con số.
- Gộp quá nhiều bản tóm tắt một lần đến mức lại vượt ngân sách.
- Dùng bản tóm tắt cho quyết định quan trọng mà không đối chiếu văn bản gốc.
Câu hỏi thường gặp
Văn bản bao dài thì nên chia?
Khi vượt cửa sổ ngữ cảnh của mô hình, hoặc chi phí một lần gọi quá cao với bạn. Đếm token để biết chắc.
Bản tóm tắt nên dài bao nhiêu?
Tùy người đọc và mục đích. Ghi rõ trong prompt, ví dụ số gạch đầu dòng tối đa.
Có nên tóm tắt tiếng Anh rồi dịch không?
Thường không cần. Yêu cầu mô hình tóm tắt thẳng bằng tiếng Việt, và giữ nguyên thuật ngữ gốc khi cần.
Tóm tắt có thể bịa thông tin không?
Có thể, nhất là khi qua nhiều tầng gộp. Kiểm số liệu và tên riêng với văn bản gốc.
Học tiếp
- Biết văn bản có vừa không: đếm token trước khi gọi API.
- Chia văn bản theo cấu trúc: chia đoạn văn bản cho RAG.
- Tóm tắt hàng loạt cho rẻ: batch API.
Nếu bạn muốn học Python và AI bài bản cùng giảng viên, tham khảo khóa học AI của Big-O Coding.
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.