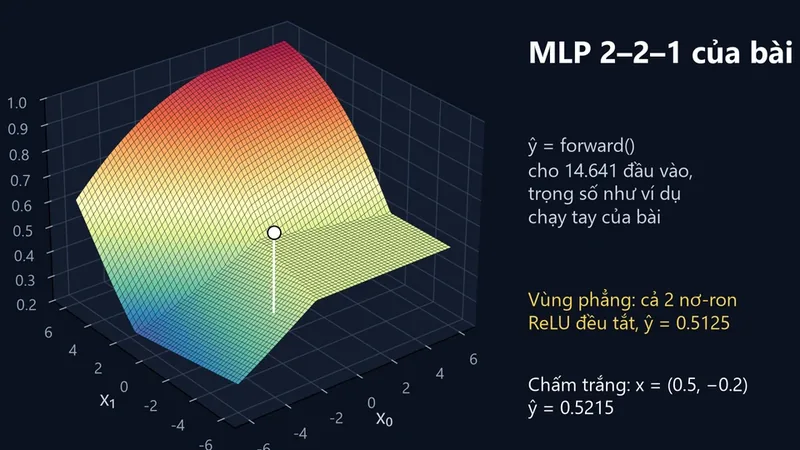
- Ngôn ngữ chung của dữ liệu và nơ-ron: Mọi thực thể trong AI từ hình ảnh, âm thanh, văn bản đến các trọng số mạng nơ-ron đều được mô hình hóa dưới dạng vector, ma trận và tensor đa chiều; phép biến đổi tuyến tính \(\mathbf{y} = \mathbf{W}\mathbf{x} + \mathbf{b}\) là viên gạch xây dựng nên mọi kiến trúc Deep Learning.
- Bản chất hình học của Trị riêng và Vector riêng: Vector riêng (Eigenvector) chỉ ra các phương hướng đặc biệt mà tác động của ma trận lên vector chỉ đơn thuần là co giãn độ dài theo hệ số trị riêng (Eigenvalue \(\lambda\)) mà không làm quay lệch phương, đặt nền móng cho thuật toán lặp lũy thừa Power Iteration và thuật toán PageRank kinh điển.
- Nén dữ liệu và giảm chiều tối ưu với SVD và PCA: Phân rã giá trị suy biến (Singular Value Decomposition) cho phép phân tách ma trận dữ liệu khổng lồ thành tích của các thành phần trực giao, loại bỏ nhiễu và bảo lưu phương sai thông tin lớn nhất trong không gian ít chiều hơn.
1. Tại sao Đại số Tuyến tính là Hơi thở của Trí tuệ Nhân tạo?
Nhiều người mới bắt đầu học Machine Learning thường coi các thư viện như PyTorch, TensorFlow hay Scikit-Learn như một "hộp đen": chỉ cần gọi model.fit() hoặc loss.backward(). Tuy nhiên, khi cần gỡ lỗi mô hình (debugging), tối ưu hóa thời gian huấn luyện trên cụm GPU, hoặc thiết kế các kiến trúc mới, sự am hiểu sâu sắc về Đại số Tuyến tính (Linear Algebra) là lằn ranh phân biệt giữa một người sao chép mã nguồn đơn thuần và một kỹ sư AI thực thụ.
Trong thế giới máy tính:
- Một bức ảnh màu không phải là hình vẽ mà là một Tensor 3 chiều: \(\text{Chiều cao} \times \text{Chiều rộng} \times \text{Kênh màu (RGB)}\).
- Một đoạn hội thoại văn bản là một ma trận các vector nhúng (Embedding Matrix): \(\text{Số lượng token} \times d_{\text{model}}\).
- Tầng nơ-ron truyền thẳng (Dense Layer) thực chất là một phép chiếu biến đổi không gian tọa độ thông qua phép nhân ma trận kết hợp với phép tịnh tiến của vector bias.
- Mục tiêu tối ưu hóa đạo hàm Gradient Descent thực chất là tìm vector chỉ phương hướng giảm nhanh nhất của mặt phẳng hàm mất mát đa biến.
Toàn bộ cuộc cách mạng phần cứng máy tính hiện đại (sự thống trị của chip GPU NVIDIA, Google TPU hay nhân Apple Neural Engine) đều xoay quanh một mục tiêu duy nhất: Tăng tốc độ tính toán các phép toán đại số tuyến tính cơ bản lên hàng triệu lần.
2. Trụ cột 1: Vector và Bản chất Hình học của Phép chiếu
Một vector \(\mathbf{v} \in \mathbb{R}^d\) vừa có thể hiểu theo góc độ khoa học máy tính (một mảng \(d\) phần tử số thực), vừa có thể hiểu theo góc độ hình học (một mũi tên có độ dài và phương hướng xuất phát từ gốc tọa độ trong không gian \(d\) chiều).
2.1. Độ dài và Chuẩn của Vector (Vector Norms)
Chuẩn vector đo lường kích thước hay khoảng cách từ gốc tọa độ đến điểm dữ liệu:
- Chuẩn \(L_1\) (Manhattan Norm): \(\|\mathbf{x}\|_1 = \sum_{i=1}^d |x_i|\). Trong học máy, chuẩn \(L_1\) được sử dụng trong kỹ thuật điều chuẩn Lasso Regularization, có đặc tính thần kỳ là ép các trọng số không quan trọng về đúng bằng \(0\), tạo ra mô hình thưa thớt (sparse weights) có khả năng tự chọn lọc đặc trưng.
- Chuẩn \(L_2\) (Euclidean Norm): \(\|\mathbf{x}\|_2 = \sqrt{\sum_{i=1}^d x_i^2}\). Được sử dụng trong Ridge Regularization (Weight Decay), giúp giữ cho các trọng số nơ-ron luôn nhỏ và phân bổ đều, ngăn chặn hiện tượng quá khớp (overfitting).
2.2. Tích vô hướng và Phép chiếu Trực giao (Dot Product & Projection)
Tích vô hướng giữa hai vector \(\mathbf{u}\) và \(\mathbf{v}\) là trung tâm của mọi cơ chế chú ý (Attention) và đo độ tương đồng trong AI:
\[\mathbf{u} \cdot \mathbf{v} = \sum_{i=1}^d u_i v_i = \|\mathbf{u}\|_2 \|\mathbf{v}\|_2 \cos \theta\]
Ý nghĩa hình học trực quan:
- Nếu \(\mathbf{u}\) và \(\mathbf{v}\) tạo góc nhọn (\(\theta \lt 90^\circ\)): \(\mathbf{u} \cdot \mathbf{v} \gt 0\), hai vector hỗ trợ và đồng thuận ngữ nghĩa với nhau.
- Nếu \(\mathbf{u}\) và \(\mathbf{v}\) trực giao vuông góc (\(\theta = 90^\circ\)): \(\mathbf{u} \cdot \mathbf{v} = 0\), hai khái niệm hoàn toàn độc lập và không liên quan.
- Nếu \(\mathbf{u}\) và \(\mathbf{v}\) tạo góc tù (\(\theta \gt 90^\circ\)): \(\mathbf{u} \cdot \mathbf{v} \lt 0\), hai vector mang ý nghĩa đối lập.
Độ dài hình chiếu trực giao của vector \(\mathbf{u}\) lên trục của vector đơn vị \(\mathbf{v}\) chính là \(\mathbf{u} \cdot \frac{\mathbf{v}}{\|\mathbf{v}\|_2}\). Mọi thuật toán phân tích thành phần chính (PCA) đều dựa trên phép chiếu trực giao này.
3. Trụ cột 2: Ma trận và Biến đổi Tuyến tính
Một ma trận \(\mathbf{A} \in \mathbb{R}^{m \times n}\) không đơn thuần là một bảng số liệu 2 chiều. Về bản chất toán học sâu xa: Mỗi ma trận là một phép biến đổi tuyến tính (Linear Transformation) ánh xạ một không gian vector \(n\) chiều sang không gian vector \(m\) chiều.
Khi nhân một ma trận với một vector:
\[\mathbf{y} = \mathbf{A} \mathbf{x}\]
Không gian tọa độ ban đầu bị tác động bởi ba hiệu ứng hình học cơ bản:
- Phép quay (Rotation): Làm đổi hướng của các vector cơ sở.
- Phép co giãn (Scaling): Kéo dãn hoặc thu hẹp độ dài các trục tọa độ.
- Phép trượt biến dạng (Shearing): Làm nghiêng các góc tọa độ.
Phép nhân Ma trận GEMM (General Matrix Multiply):
Trong Deep Learning, phép nhân hai ma trận \(\mathbf{C} = \mathbf{A} \mathbf{B}\) (với \(\mathbf{A} \in \mathbb{R}^{m \times k}, \mathbf{B} \in \mathbb{R}^{k \times n}\)) chiếm tới hơn 90% tổng thời gian tính toán của toàn bộ quá trình huấn luyện mạng nơ-ron:
\[C_{ij} = \sum_{p=1}^k A_{ip} B_{pj}\]
Tổng số phép toán số học là \(2mnk\) FLOPs. Các thư viện tính toán hiệu năng cao như BLAS, OpenBLAS và NVIDIA cuBLAS tối ưu hóa phép nhân ma trận này xuống cấp độ phần cứng bằng cách chia nhỏ ma trận vào bộ nhớ đệm L1/L2 cache (tiling) và tận dụng triệt để các tập lệnh vector hóa AVX-512 hoặc Tensor Cores.
4. Trụ cột 3: Giá trị riêng và Vector riêng (Eigenvalues & Eigenvectors)
Khi một phép biến đổi ma trận \(\mathbf{A}\) tác động lên không gian, hầu hết các vector đều bị đổi phương hướng và độ dài. Tuy nhiên, với nhiều ma trận (chẳng hạn mọi ma trận đối xứng thực), tồn tại những phương hướng đặc biệt mà tác động của ma trận lên vector chỉ đơn thuần là co giãn độ dài mà hoàn toàn không làm đổi phương. Không phải ma trận nào cũng có phương như vậy: phép quay \(90^\circ\) \(\begin{pmatrix} 0 & -1 \\ 1 & 0 \end{pmatrix}\) làm đổi phương mọi vector (trị riêng của nó là \(\pm i\), không phải số thực).
Những vector đặc biệt này được gọi là Vector riêng (Eigenvector \(\mathbf{v}\)), và hệ số co giãn độ dài tương ứng được gọi là Giá trị riêng (Eigenvalue \(\lambda\)):
\[\mathbf{A} \mathbf{v} = \lambda \mathbf{v}, \quad \text{với } \mathbf{v} \neq \mathbf{0}\]
Hay tương đương với phương trình đặc trưng:
\[(\mathbf{A} - \lambda \mathbf{I}) \mathbf{v} = \mathbf{0} \iff \det(\mathbf{A} - \lambda \mathbf{I}) = 0\]
4.1. Thuật toán Lặp Lũy thừa (Power Iteration)
Làm thế nào để máy tính tìm được giá trị riêng lớn nhất (trị riêng trội - dominant eigenvalue) và vector riêng tương ứng của một ma trận khổng lồ mà không cần giải phương trình đa thức định thức phức tạp?
Thuật toán kinh điển và thanh lịch nhất là Power Iteration:
- Khởi tạo một vector ngẫu nhiên \(\mathbf{v}_0\) và chuẩn hóa \(\|\mathbf{v}_0\|_2 = 1\). Không nên cố định \(\mathbf{v}_0 = [1, 1, \dots, 1]^T\): nếu \(\mathbf{v}_0\) không có thành phần nào theo vector riêng trội (chẳng hạn trùng phương với vector riêng của một trị riêng nhỏ hơn), thuật toán kẹt ở đó mãi. Ví dụ ma trận \(\begin{pmatrix} 1 & -2 \\ -2 & 1 \end{pmatrix}\) có trị riêng \(3\) và \(-1\), mà \([1, 1]^T\) chính là vector riêng của \(-1\), nên bắt đầu từ đó sẽ ra \(-1\) thay vì trị riêng trội \(3\). Code mẫu ở mục 6 chạy từ hai vector vuông góc \([1, 1]\) và \([1, -1]\) rồi giữ kết quả có \(|\lambda|\) lớn hơn: hai vector vuông góc không thể cùng nằm trên một phương.
- Tại mỗi bước lặp \(k = 1, 2, \dots\):
- Nhân ma trận với vector hiện tại: \(\mathbf{w}_k = \mathbf{A} \mathbf{v}_{k-1}\).
- Chuẩn hóa vector mới về độ dài đơn vị: \(\mathbf{v}_k = \frac{\mathbf{w}_k}{\|\mathbf{w}_k\|_2}\).
- Ước tính giá trị riêng tương ứng thông qua thương số Rayleigh (Rayleigh Quotient): \[\lambda_k = \mathbf{v}_k^T \mathbf{A} \mathbf{v}_k\]
Nếu có một trị riêng \(\lambda_1\) với \(|\lambda_1|\) lớn hẳn mọi trị riêng còn lại, sau đủ số bước lặp vector \(\mathbf{v}_k\) sẽ hội tụ về vector riêng ứng với \(\lambda_1\). Số vòng cần thiết tùy tỷ số \(|\lambda_2 / \lambda_1|\), với \(\lambda_2\) là trị riêng có độ lớn đứng thứ hai: với ma trận \(\begin{pmatrix} 3 & 0 \\ 0 & 4 \end{pmatrix}\) (tỷ số \(0.75\)), 10 vòng mới cho trị riêng ước lượng \(3.9968\) chứ chưa tới \(4\).
4.2. Ứng dụng lịch sử: Thuật toán PageRank của Google
Năm 1998, Larry Page và Sergey Brin sáng lập Google dựa trên thuật toán xếp hạng trang web PageRank. Họ mô hình hóa toàn bộ mạng Internet toàn cầu thành một đồ thị có hướng khổng lồ, với ma trận chuyển tiếp xác suất liên kết \(\mathbf{M}\). Điểm số uy tín của tất cả các trang web trên thế giới chính là nghiệm của hệ phương trình trạng thái dừng:
\[\mathbf{r} = \mathbf{M} \mathbf{r}\]
Đây chính là bài toán tìm vector riêng ứng với giá trị riêng \(\lambda = 1\) của ma trận Markov! Google đã sử dụng thuật toán Power Iteration để tính toán điểm số PageRank cho hàng tỷ trang web một cách thần tốc.
Chủ đề này nằm trong Lecture 12 - Dimensionality Reduction (Giảm chiều dữ liệu) của Khóa AI. Xem đề cương
5. Trụ cột 4: Giảm chiều Dữ liệu với PCA và Phân rã SVD
Trong các bài toán thực tế, dữ liệu thường có hàng nghìn đặc trưng (features) nhưng lại chứa đựng rất nhiều thông tin dư thừa và nhiễu loạn. Để nén dữ liệu mà vẫn giữ lại tối đa lượng thông tin, hai công cụ đại số tuyến tính tối thượng được áp dụng:
5.1. Phân tích Thành phần Chính (Principal Component Analysis - PCA)
Giả sử ma trận dữ liệu \(\mathbf{X} \in \mathbb{R}^{N \times d}\) đã được chuẩn hóa về trung bình bằng \(0\). Ma trận hiệp phương sai của dữ liệu là:
\[\mathbf{\Sigma} = \frac{1}{N} \mathbf{X}^T \mathbf{X} \in \mathbb{R}^{d \times d}\]
Ma trận hiệp phương sai \(\mathbf{\Sigma}\) là một ma trận đối xứng bán xác định dương. Theo Định lý Phổ (Spectral Theorem), nó luôn có thể chéo hóa trực giao:
\[\mathbf{\Sigma} = \mathbf{V} \mathbf{\Lambda} \mathbf{V}^T\]
- Các vector riêng \(\mathbf{v}_1, \mathbf{v}_2, \dots, \mathbf{v}_d\) chính là các Trục thành phần chính (Principal Components): hướng có phương sai biến thiên dữ liệu lớn nhất.
- Các giá trị riêng \(\lambda_1 \ge \lambda_2 \ge \dots \ge \lambda_d\) tỷ lệ thuận với lượng thông tin phương sai mà trục đó nắm giữ.
- Để giảm số chiều từ \(d\) xuống \(k\) (\(k \ll d\)), ta chỉ cần chọn \(k\) vector riêng có trị riêng lớn nhất và chiếu dữ liệu lên không gian con này: \(\mathbf{X}_{\text{reduced}} = \mathbf{X} \mathbf{V}_k\).
5.2. Phân rã Giá trị Suy biến (Singular Value Decomposition - SVD)
Trong khi chéo hóa trị riêng chỉ áp dụng được cho ma trận vuông, phân rã SVD có thể áp dụng cho bất kỳ ma trận chữ nhật \(\mathbf{A} \in \mathbb{R}^{m \times n}\) nào:
\[\mathbf{A} = \mathbf{U} \mathbf{\Sigma} \mathbf{V}^T\]
Trong đó:
- \(\mathbf{U} \in \mathbb{R}^{m \times m}\) là ma trận trực giao chứa các vector suy biến trái (Left-singular vectors).
- \(\mathbf{\Sigma} \in \mathbb{R}^{m \times n}\) là ma trận đường chéo chứa các giá trị suy biến không âm sắp xếp giảm dần \(\sigma_1 \ge \sigma_2 \ge \dots \ge 0\).
- \(\mathbf{V} \in \mathbb{R}^{n \times n}\) là ma trận trực giao chứa các vector suy biến phải (Right-singular vectors).
Theo Định lý Eckart-Young-Mirsky kinh điển, cách xấp xỉ tốt nhất một ma trận \(\mathbf{A}\) bằng một ma trận hạng thấp \(k\) (theo chuẩn Frobenius) chính là cắt tỉa phân rã SVD chỉ giữ lại \(k\) giá trị suy biến lớn nhất:
\[\mathbf{A}_k = \sum_{i=1}^k \sigma_i \mathbf{u}_i \mathbf{v}_i^T\]
Định lý này là xương sống toán học của các hệ thống gợi ý phim ảnh (Collaborative Filtering như thuật toán Netflix Prize), nén hình ảnh và thuật toán phân tích ngữ nghĩa tiềm ẩn LSA (Latent Semantic Analysis).
6. Cài đặt thuật toán kiểm thử: Thuật toán Power Iteration tìm Trị riêng trội
Dưới đây là mã nguồn cài đặt chính xác thuật toán Lặp Lũy thừa (Power Iteration) cho ma trận \(2 \times 2\) trong cả Python và C++17, tính toán chi tiết trị riêng trội và vector riêng chuẩn hóa kèm quy ước dấu nhất quán (chạy từ hai vector khởi tạo \([1, 1]\) và \([1, -1]\), lý do ở bước 1 của mục 4.1):
import math


def power_iteration_from(matrix, v0, v1, num_iters):
    # Initial normalization
    norm = math.sqrt(v0 ** 2 + v1 ** 2)
    v = [v0 / norm, v1 / norm]

    for _ in range(num_iters):
        # w = M * v
        w0 = matrix[0][0] * v[0] + matrix[0][1] * v[1]
        w1 = matrix[1][0] * v[0] + matrix[1][1] * v[1]
        norm = math.sqrt(w0 ** 2 + w1 ** 2)
        if norm > 0:
            v = [w0 / norm, w1 / norm]

    # Rayleigh quotient: lambda = v^T * M * v
    Mv0 = matrix[0][0] * v[0] + matrix[0][1] * v[1]
    Mv1 = matrix[1][0] * v[0] + matrix[1][1] * v[1]
    return v[0] * Mv0 + v[1] * Mv1, v


def power_iteration(matrix, num_iters):
    # Run from two orthogonal start vectors [1, 1] and [1, -1], keep the result with the larger |lambda|.
    # A single fixed start can lie exactly on the eigenvector of a smaller eigenvalue and never leave it
    # (e.g. [1, 1] for [[1, -2], [-2, 1]] gives -1 instead of 3); two orthogonal vectors cannot both lie
    # on that one direction, so at least one of them converges to the dominant eigenvector.
    lam_a, v_a = power_iteration_from(matrix, 1.0, 1.0, num_iters)
    lam_b, v_b = power_iteration_from(matrix, 1.0, -1.0, num_iters)
    if abs(lam_b) > abs(lam_a) + 1e-9:
        eigenval, v = lam_b, v_b
    else:
        eigenval, v = lam_a, v_a

    # Deterministic sign convention: first non-zero component positive
    if v[0] < -1e-9 or (abs(v[0]) <= 1e-9 and v[1] < 0):
        v = [-v[0], -v[1]]

    return round(eigenval, 4), [round(v[0], 4), round(v[1], 4)]
#include <iostream>
#include <vector>
#include <cmath>
#include <iomanip>

// Power iteration from the start vector (v0, v1); returns {Rayleigh quotient, unit vector}.
std::pair<double, std::vector<double>> power_iteration_from(
    const std::vector<std::vector<double>>& matrix,
    double v0, double v1,
    int num_iters
) {
    double norm = std::sqrt(v0 * v0 + v1 * v1);
    v0 /= norm;
    v1 /= norm;

    for (int k = 0; k < num_iters; ++k) {
        double w0 = matrix[0][0] * v0 + matrix[0][1] * v1;
        double w1 = matrix[1][0] * v0 + matrix[1][1] * v1;
        norm = std::sqrt(w0 * w0 + w1 * w1);
        if (norm > 0) {
            v0 = w0 / norm;
            v1 = w1 / norm;
        }
    }

    double Mv0 = matrix[0][0] * v0 + matrix[0][1] * v1;
    double Mv1 = matrix[1][0] * v0 + matrix[1][1] * v1;
    return {v0 * Mv0 + v1 * Mv1, {v0, v1}};
}

std::pair<double, std::vector<double>> power_iteration(
    const std::vector<std::vector<double>>& matrix,
    int num_iters
) {
    // Two orthogonal start vectors [1, 1] and [1, -1], keep the result with the larger |lambda|:
    // one fixed start can lie exactly on the eigenvector of a smaller eigenvalue and never leave it,
    // but two orthogonal vectors cannot both lie on that one direction.
    auto a = power_iteration_from(matrix, 1.0, 1.0, num_iters);
    auto b = power_iteration_from(matrix, 1.0, -1.0, num_iters);
    auto best = (std::abs(b.first) > std::abs(a.first) + 1e-9) ? b : a;

    double eigenval = best.first;
    double v0 = best.second[0], v1 = best.second[1];

    // Deterministic sign convention: first non-zero component positive
    if (v0 < -1e-9 || (std::abs(v0) <= 1e-9 && v1 < 0)) {
        v0 = -v0;
        v1 = -v1;
    }

    eigenval = std::round(eigenval * 10000.0) / 10000.0;
    v0 = std::round(v0 * 10000.0) / 10000.0;
    v1 = std::round(v1 * 10000.0) / 10000.0;

    return {eigenval, {v0, v1}};
}
Khi tự viết lại code này, bạn có thể kiểm bằng ma trận \(\begin{pmatrix} 1 & -2 \\ -2 & 1 \end{pmatrix}\): code đúng phải ra trị riêng \(3\) với vector riêng \([0.7071, -0.7071]\), còn code chỉ khởi tạo từ \([1, 1]\) sẽ ra \(-1\). Với các ma trận khác, hãy so kết quả với numpy.linalg.eig, và nhớ rằng nếu số vòng lặp quá ít thì kết quả chưa hội tụ: ma trận \(\begin{pmatrix} 3 & 0 \\ 0 & 4 \end{pmatrix}\) sau 10 vòng mới ra \(3.9968\), còn sau 100 vòng thì ra đúng \(4\) với vector \([0, 1]\).
Phân tích độ phức tạp thuật toán
- Độ phức tạp thời gian: Mỗi vòng lặp nhân ma trận \(d \times d\) với vector \(d \times 1\) tiêu tốn \(\mathcal{O}(d^2)\) phép toán. Với \(K\) vòng lặp, tổng thời gian tính toán là \(\mathcal{O}(K \cdot d^2)\) (code mẫu chạy từ hai vector khởi tạo nên tốn gấp đôi, vẫn là \(\mathcal{O}(K \cdot d^2)\)). Sau mỗi vòng lặp, sai số của vector \(\mathbf{v}_k\) giảm theo hệ số \(|\lambda_2 / \lambda_1|\) (với ma trận đối xứng, sai số của trị riêng ước lượng giảm theo hệ số \(|\lambda_2 / \lambda_1|^2\)): tỷ số này càng nhỏ thì hội tụ càng nhanh. Nếu \(\lambda_1\) vượt trội so với \(\lambda_2\), thuật toán hội tụ cực kỳ nhanh.
- Độ phức tạp không gian: Chỉ cần lưu trữ vector biến đổi trung gian \(\mathcal{O}(d)\).
7. Bài tập vận dụng và câu hỏi phỏng vấn
- Câu hỏi: Trong bài toán hồi quy tuyến tính bình phương tối thiểu (Ordinary Least Squares - OLS), nghiệm dạng đóng được tính bằng công thức \(\mathbf{w} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{y}\). Điều gì sẽ xảy ra nếu ma trận \(\mathbf{X}^T \mathbf{X}\) không khả nghịch (singular matrix)? Làm thế nào để khắc phục trong thực tế?
- Gợi ý trả lời:
- Ma trận \(\mathbf{X}^T \mathbf{X}\) không khả nghịch xảy ra khi các cột của \(\mathbf{X}\) bị phụ thuộc tuyến tính lẫn nhau (hiện tượng đa cộng tuyến hoàn hảo - multicollinearity) hoặc khi số lượng đặc trưng lớn hơn số lượng mẫu dữ liệu (\(d \gt N\)). Khi đó định thức \(\det(\mathbf{X}^T \mathbf{X}) = 0\), không tồn tại ma trận nghịch đảo thông thường.
- Giải pháp 1: Sử dụng Ma trận giả nghịch đảo Moore-Penrose (Pseudoinverse \(\mathbf{X}^+\)) tính toán thông qua phân rã SVD.
- Giải pháp 2: Áp dụng điều chuẩn Ridge Regression (cộng thêm thành phần đường chéo \(\lambda \mathbf{I}\)): \(\mathbf{w} = (\mathbf{X}^T \mathbf{X} + \lambda \mathbf{I})^{-1} \mathbf{X}^T \mathbf{y}\). Vì \(\mathbf{X}^T \mathbf{X}\) là bán xác định dương, việc cộng thêm \(\lambda \mathbf{I}\) (với \(\lambda \gt 0\)) đảm bảo ma trận kết quả luôn luôn xác định dương nghiêm ngặt và khả nghịch 100%.
- Gợi ý trả lời:
- Câu hỏi: Giải thích tại sao một ma trận trực giao \(\mathbf{Q}\) (thỏa mãn \(\mathbf{Q}^T \mathbf{Q} = \mathbf{I}\)) lại có đặc tính bảo toàn độ dài vector và góc hình học khi thực hiện phép biến đổi?
- Gợi ý trả lời:
- Xét vector \(\mathbf{y} = \mathbf{Q} \mathbf{x}\). Bình phương độ dài của vector mới là: \[\|\mathbf{y}\|_2^2 = \mathbf{y}^T \mathbf{y} = (\mathbf{Q} \mathbf{x})^T (\mathbf{Q} \mathbf{x}) = \mathbf{x}^T \mathbf{Q}^T \mathbf{Q} \mathbf{x} = \mathbf{x}^T \mathbf{I} \mathbf{x} = \|\mathbf{x}\|_2^2\] Do đó độ dài \(\|\mathbf{y}\|_2 = \|\mathbf{x}\|_2\) được bảo toàn nguyên vẹn.
- Tương tự, tích vô hướng giữa hai vector sau biến đổi: \(\langle \mathbf{Q}\mathbf{u}, \mathbf{Q}\mathbf{v} \rangle = \mathbf{u}^T \mathbf{Q}^T \mathbf{Q} \mathbf{v} = \mathbf{u}^T \mathbf{v}\). Vì cả độ dài lẫn tích vô hướng đều không đổi, góc \(\cos \theta = \frac{\mathbf{u} \cdot \mathbf{v}}{\|\mathbf{u}\| \|\mathbf{v}\|}\) được bảo toàn tuyệt đối. Phép biến đổi trực giao chỉ đóng vai trò như một phép quay hoặc phép phản xạ thuần túy trong không gian hình học.
- Gợi ý trả lời:
Khóa AI – Introduction to Machine Learning: nền tảng Máy học từ thuật toán cơ bản đến Neural Networks và LLM, học bằng Python. Học thử buổi 1 miễn phí.